أشارككم في هذا الموضوع ورقة بحثية مهمة في مجال تقنيات القرآن الكريم ومعالجة اللغة العربية بعنوان:
MASAQ Parser: A Fine-grained MorphoSyntactic Analyzer for the Quran
تقدم الورقة مشروع باسم محلل مساق MASAQ Parser الذي يوفر مورد رقمي متقدم مصمم خصيصًا للتحليل الصرفي والنحوي لنص القرآن الكريم ودعم تطبيقات معالجة اللغات الطبيعية العربية.
أهم ما تقدمه الدراسة البحثية
توفر الدراسة مجموعة بيانات شاملة تغطي القرآن الكريم كاملًا، حيث تعتمد على نص تنزيل Tanzil الموثوق وتتضمن:
- أكثر من 131 ألف مدخل صرفي
- أكثر من 123 ألف وظيفة نحوية إعرابية
- تحليل على مستوى الكلمة والمورفيم (morpheme)
- مجموعة وسوم نحوية موحدة tagset ( تتضمن أكثر من 70 دورًا نحويًا)
استخدمت هذه البيانات لبناء محلل نحوي آلي يعتمد على التعلم الآلي، وقد تم اعتماد خوارزمية Random Forest لتطوير المحلل النحوي وحققت الخوارزمية دقة وصلت إلى 99%.
القائمون على الدراسة
أُنجزت الدراسة من قبل فريق بحثي أكاديمي متخصص في اللسانيات الحاسوبية ومعالجة اللغة العربية:
- مجدي صوالحة Majdi Sawalha
- عبدالله الشديفات Abdallah T. AlShdaifat
- فيصل الشرقي Faisal Alshargi
- بسام حمو Bassam Hammo
- حسين ياغي Sane Yagi
وقد نشرت الدراسة ضمن أعمال مؤتمر علمي دولي متخصص بعنوان: Proceedings of the New Horizons in Computational Linguistics for Religious Texts (CLRel 2025) والصادر عن منظمة ACL.
الإشكالية التي تعالجها الدراسة
رغم التطور الملحوظ في مشاريع معالجة اللغات الطبيعية العربية NLP لا يزال النص القرآني يمثل تحديًا خاصًا لعدة أسباب:
- معظم بنوك الأشجار النحوية (Treebanks) العربية تركز على العربية الفصحى الحديثة (Modern Standard Arabic)، ولا تمثل تعقيد العربية القرآنية.
- أن الإعراب العربي التقليدي موجود في كتب بصيغة وصفية موجهة للبشر، وليس في صورة منظمة قابلة للمعالجة الحاسوبية.
- أن كتب الإعراب، رغم غناها العلمي تعاني من عدم توحيد المصطلحات والاعتماد على الشرح النصي وعدم جاهزيتها للاستخدام في نماذج تعلم الآلة
النتيجة: تعتمد كثير من التطبيقات القرآنية الحالية على تحليلات نحوية سطحية، أو أدوات غير موثقة، أو نماذج مدربة على بيانات لا تمثل الإعراب القرآني بدقة.
أهمية دراسة MASAQ Parser؟
تأتي أهمية هذه الدراسة في أنها تنقل الإعراب من كونه علمًا وصفيًا إلى كونه بنية بيانات حاسوبية، من خلال:
توحيد الأدوار والمصطلحات النحوية المستمدة من علم الإعراب ضمن مجموعة وسوم ثابتة (Tagset).
ربط كل كلمة (وأحيانًا جزء من الكلمة) بوظيفتها النحوية وعلاقتها بالكلمات الأخرى.
تقديم قاعدة بيانات كاملة لإعراب القرآن الكريم يمكن للحاسوب فهمها ومعالجتها.
إتاحة البيانات بترخيص مفتوح يتيح البناء عليها بحثيًا وتطبيقيًا.
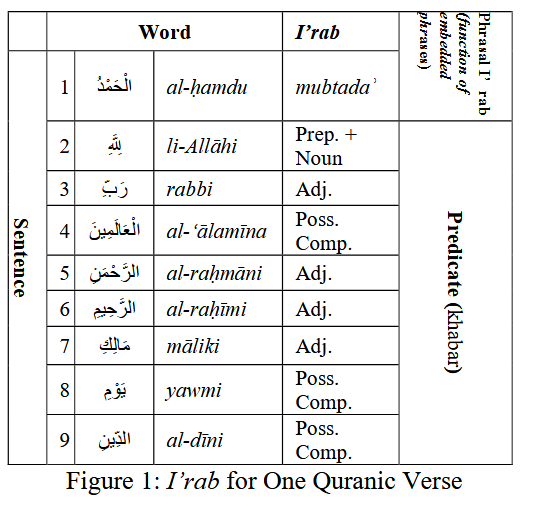
يظهر الشكل التالي مثالاً لإعراب سورة الفاتحة بتنسيق مهيكل يسهل التعامل معه حاسوبيًا:
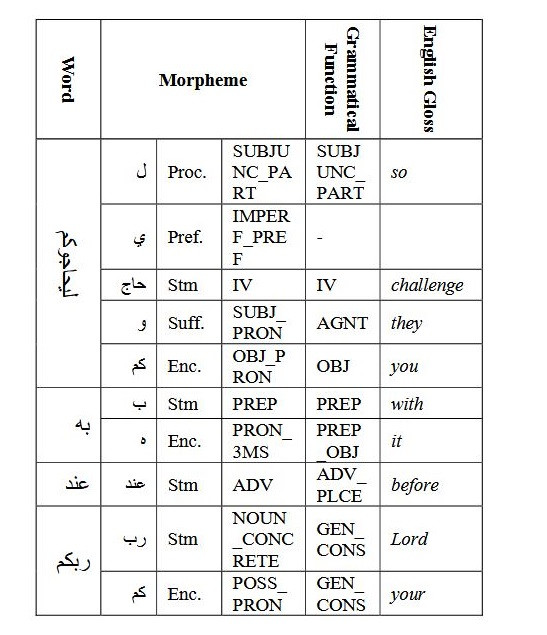
كما يظهر الجدول التالي تحليل نحوي- مورفيمي لمقطع " لِيُحَاجُّوكُم بِهِ عِندَ رَبِّكُمْ" من الآية 76 في سورة البقرة، حيث تفكك الكلمات إلى أجزائها (سابقة، جذع، لاحقة) وتحدد الوظيفة النحوية لكل جزء، مثل تحديد "واو الجماعة" في كلمة "لِيُحَاجُّوكُم" كفاعل (AGNT) و"كم" كمفعول به (OBJ)
أهمية الدراسة للمطورين
توفر هذه الدراسة للمطورين أساسًا موثوقًا لبناء تطبيقات قرآنية متقدمة، مثل:
- محركات بحث نحوية في القرآن الكريم
- أنظمة سؤال وجواب قرآنية
- تطبيقات NLP أكثر دقة وتوافقًا مع طبيعة النص القرآني
- أدوات تفاعلية لتعليم إعراب اللغة العربية والقرآن الكريم
برأيكم، كيف يمكن لبيانات الدراسة أن تسهم في سد الفجوات الحالية في معالجة اللغة العربية والقرآن الكريم؟ وما التطبيقات القرآنية التي ترون أنها الأكثر استفادة من هذه البيانات النحوية المتقدمة؟
وهل تعتقدون أن الأولوية يجب أن تكون لتطوير أدوات تعليمية أم خدمات موجهة للمطورين (APIs و SDKs) أم الدمج مباشرة داخل تطبيقات القرآن الحالية؟
