في أي نظام NLP تُعرف الكلمة بأنها وحدة نصية تفصلها مسافات. هذا التعريف البسيط يعجز أحيانًا أمام الرسم العثماني للقرآن الكريم، والإعجاز اللغوي للقرآن.
حيث توجد كلمات مركبة صرفيًا رغم اتصالها رسمًا مثل "مم" و"فيم"، وأخرى منفصلة شكلًا لكنها وحدة دلالية واحدة.
السؤال الهندسي الأول هو كيف نحدد حدود الكلمة بدقة قبل أي معالجة لاحقة؟
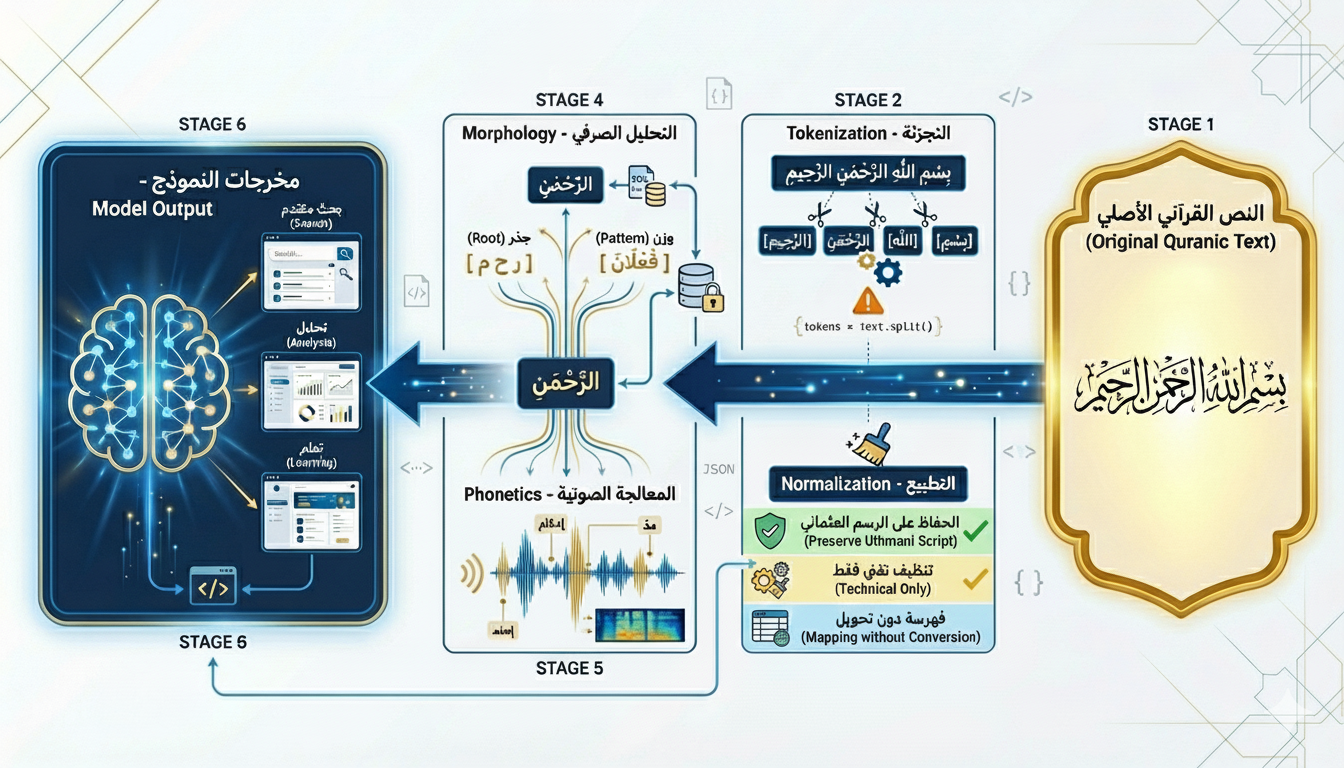
التجزئة Tokenization والخوارزميات التقليدية
خوارزميات Tokenization الجاهزة مثل NLTK أو SpaCy تعتمد على أنماط عامة في اللغة العربية. هذه الأنماط لا تتعامل مع خصوصية الرسم القرآني بشكل صحيح.
النتيجة هي تقسيم خاطئ أحيانًا للكلمات، وهذا يتسبب في سلسلة من الأخطاء المتراكمة. فأي نظام يعتمد على هذه المخرجات الخاطئة سيفشل -ولو جزئيًا- في البحث والتحليل الصرفي والإحصائيات.
التشكيل كبيانات حرجة لا كزينة بصرية
الحركات والتشكيل ليست metadata اختيارية بل جزء أساسي من هوية الكلمة. كلمة "عَلَم" بفتح اللام تختلف تماما عن "عَلِمَ" بكسر اللام، رغم تطابق الحروف الأساسية.
عند التخزين في قاعدة البيانات، التشكيل يجب أن يكون جزءًا من المفتاح الأساسي Primary Key أو Composite Key أو على الأقل من هوية الكلمة المنطقية. فبعض النماذج تتعامل مع التشكيل كضوضاء وتزيله؛ وهذا يدمر المعنى والنطق معا.
العلاقة بين الكلمة والتمثيل الصوتي
في النصوص العادية يمكن فصل الكلمة المكتوبة عن نطقها الصوتي. أما في القرآن هذا الفصل غير ممكن وظيفيًا دون فقدان معلومات، لأن أحكام التجويد تؤثر في بنية الكلمة صوتيًا.
كما أنّ الإدغام والإخفاء والمد يغيرون كيفية معالجة حدود الكلمة. كذلك ربط النص بالصوت يتطلب طبقة Phonetic Processing متخصصة غير متوفرة في المكتبات الجاهزة.
تعدد القراءات وكسر افتراضات النماذج
الكلمة الواحدة قد تُقرأ بأكثر من وجه صحيح حسب القراءات العشر المتواترة. نماذج Machine Learning تبحث عن نمط ثابت واحد، لكن التعدد هنا ثراء معتمد لا خطأ.
أي Dataset تتجاهل هذا التنوع ستنتج نموذجًا منقوص الفهم. لذا التحدي هو بناء نماذج تستوعب التعدد الصحيح دون اعتباره تناقضًا في البيانات.
الترميز Unicode والتطبيع Normalization
القرآن يستخدم أحرفًا خاصة مثل الألف الخنجرية والهمزات بأشكالها المختلفة. كل شكل له نقطة ترميز Unicode مستقلة، وهذا يخلق إشكاليات في البحث والمقارنة.
فمثلًا خوارزميات String Matching التقليدية تفشل في التعرف على "ٱ" و"ا" كنفس الحرف. يجب تطبيق Normalization متخصصة تفهم السياق القرآني دون تشويه الأصل.
العلاقات المورفولوجية والإعرابية
كل كلمة مرتبطة بجذرها اللغوي ووزنها الصرفي وموقعها الإعرابي. هذه العلاقات الثلاثية يجب أن تكون قابلة للاستعلام دون تكرار أو تضارب.
فتصميم Schema يحفظ هذه الأبعاد يتطلب Graph Database أو هيكل علائقي معقد. وأي خطأ هنا يعطل محركات البحث المورفولوجي ويفسد التطبيقات التعليمية.
خطورة استخدام البيانات الجاهزة
أحد أخطر الأخطاء هو معاملة القرآن كنص عربي عادي ضمن Datasets عامة. يُختزل النص أو يُعاد ترميزه دون مراعاة خصوصيته، ثم يُلام النموذج على الضعف.
المشكلة ليست في الخوارزمية بل في المنهج. البيانات الخاطئة تنتج نماذج مضللة مهما كانت متقدمة، والحل يبدأ من بناء Datasets قرآنية متخصصة.
معالجة القرآن على مستوى الكلمة تحدٍ هندسي متعدد الطبقات. فالنجاح يعني بناء أساس تقني صلب يحترم النص ويستفيد من التقنية دون تبسيط مخل أو تشويه.
وهذه صورة توضيحية لمراحل التعامل مع النص القرآني على مستوى الكلمة. استعنت بـ Nano Banana Pro لإخراجها بصريًا بعدما وضحت له الخطوات، نظرًا لتعقيد إخراج هذا النوع من المخططات بصريًا.