كمطورين وحفظة للقرآن نواجه صعوبة في حفظ وتمييز الآيات المتشابهة مع بعضها، وكذلك قد يصعب علينا يدويًا تحديد أماكن الآيات المتشابهة بسبب كثرة المواضع وتنوعها وتداخلها.
ولهذا طورت تطبيق فروق وهو تطبيق PWA مبني على التحديث الأخير لمشروع quran-search-engine الذي أطلقه د. @عادل بن يحي بعد مساهمات من مبادرة رمضان الأثر ركزت على تحسينات في السرعة والأداء.
فكرة التطبيق ومميزاته
يهدف تطبيق فروق إلى مساعدة الحفظة والباحثين في الوصول إلى الآيات المتشابهة مع بعضها بسرعة وسهولة، حيث يمتاز بمميزات قوية أهمها:
- بحث لحظي سريع حيث تظهر النتائج مباشرة بعد الكتابة.
- مرونة في البحث حيث يتجاهل التطبيق الأخطاء البسيطة ويساعد على الوصول للآيات حتى إن لم تتذكرها بدقة.
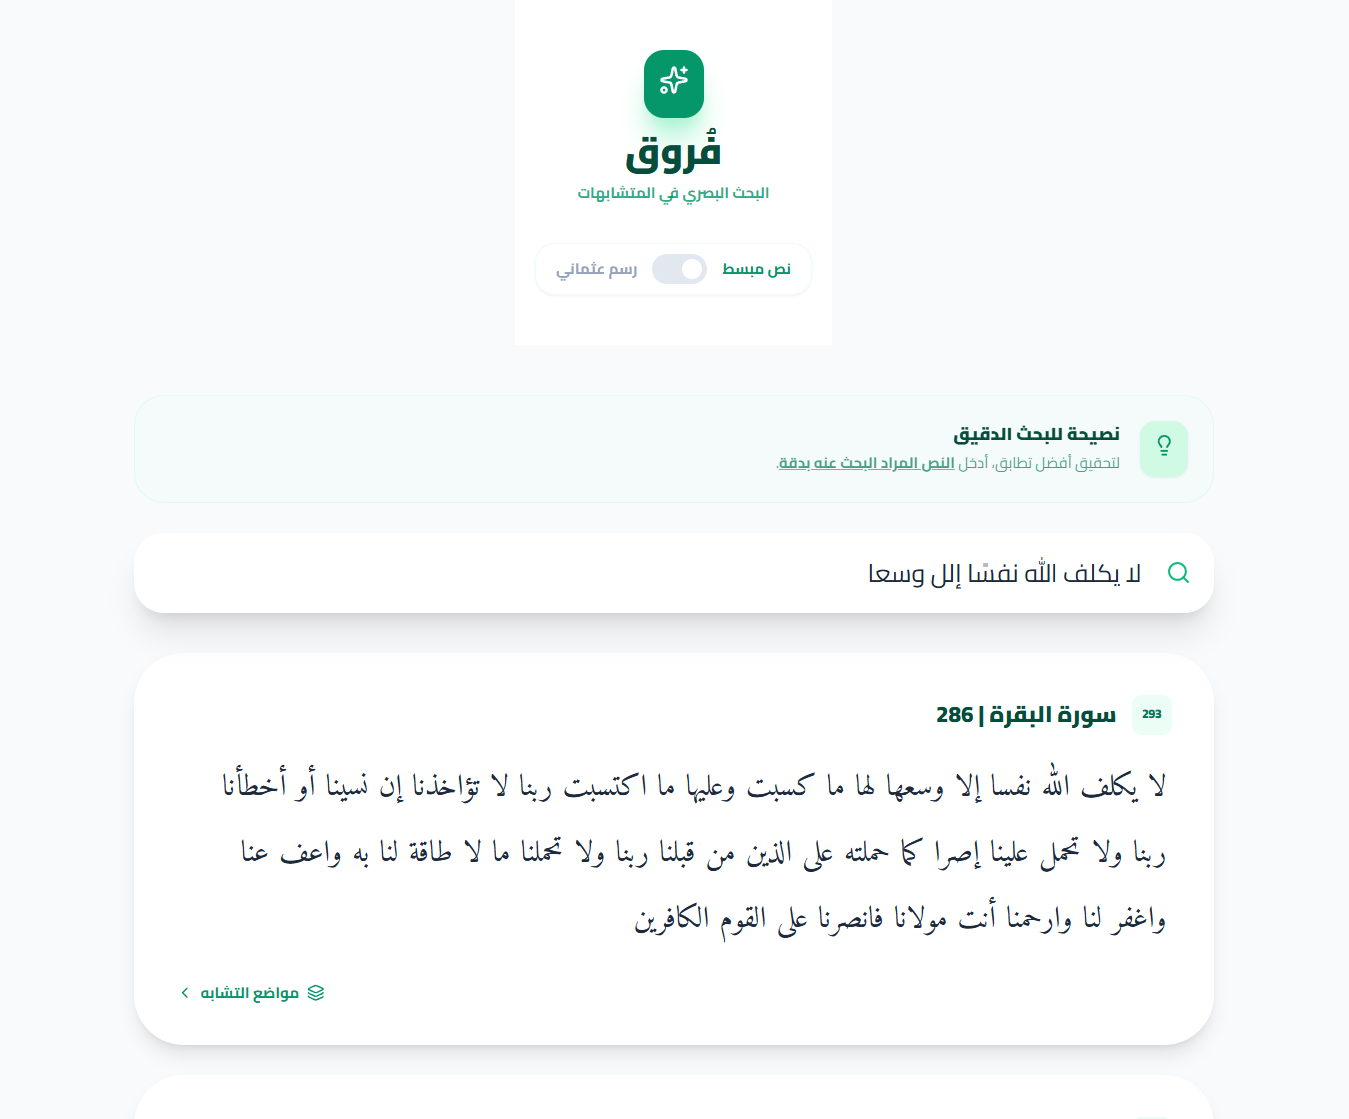
- استكشاف الآيات المتشابهات فعند النقر على أي آية في نتائج البحث الأولى تعرض مجموعة الآيات المشابهة لها مع تلوين مواضع التشابه وإمكانية التحكم في دقته.
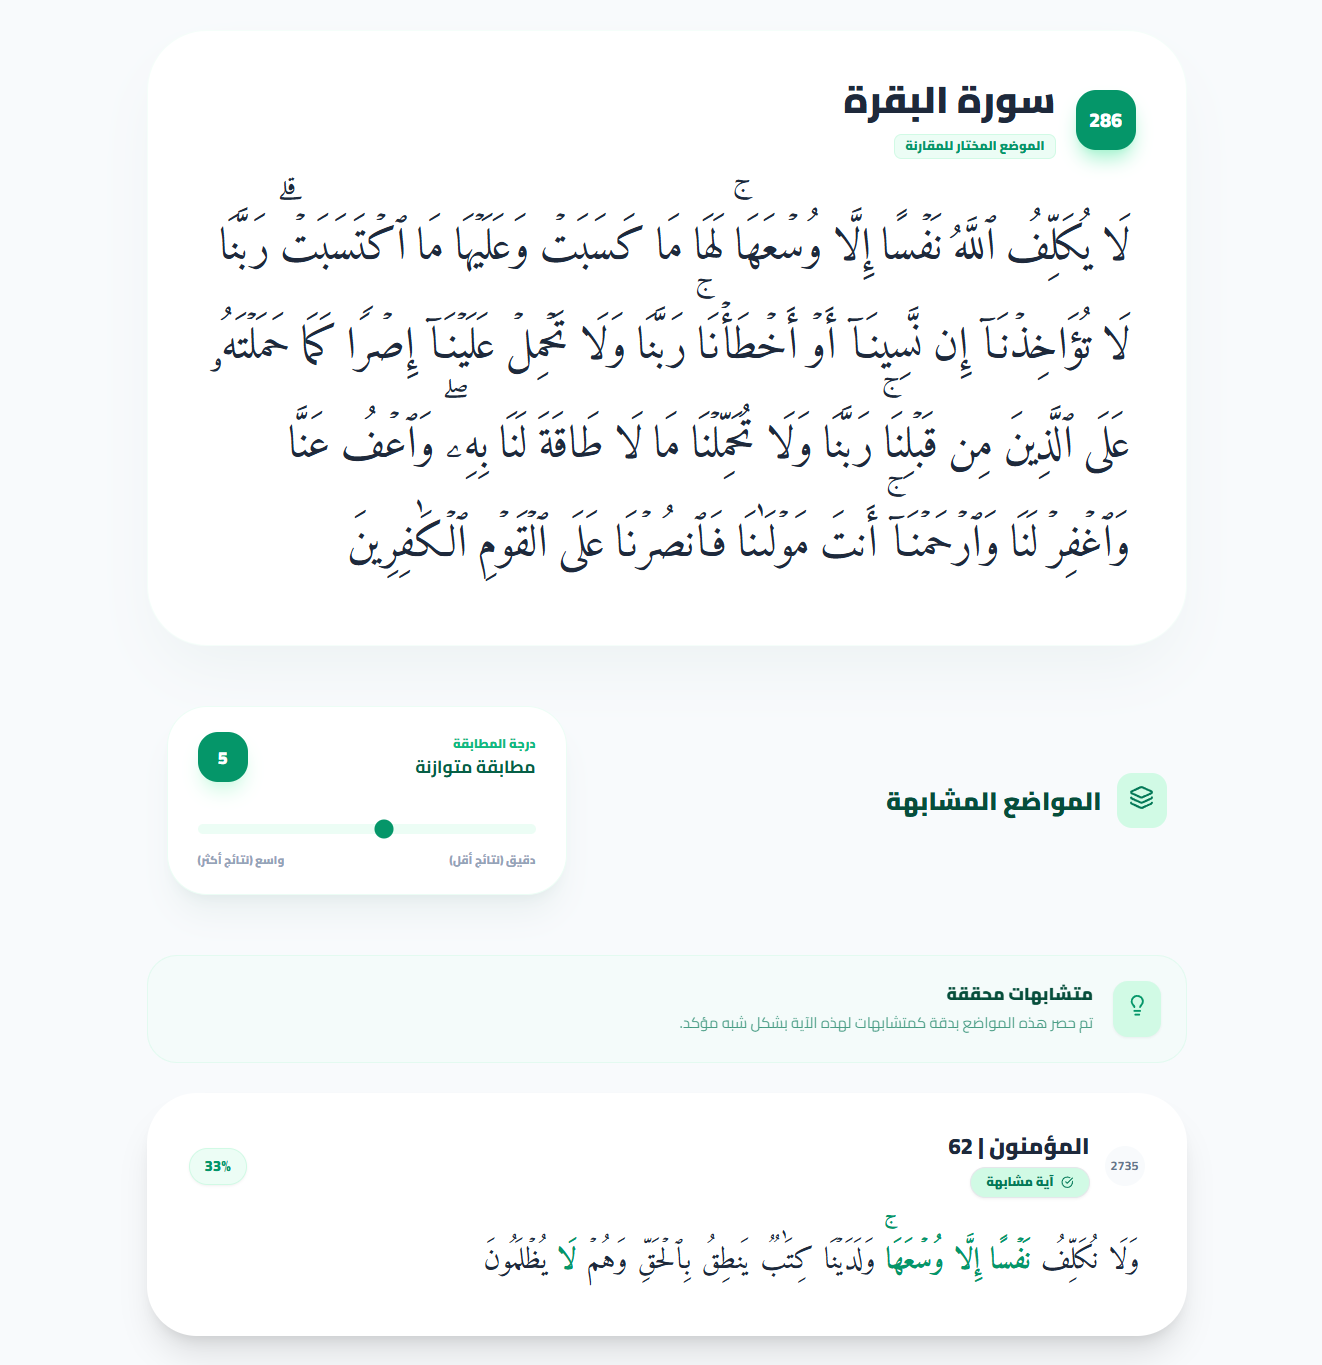
- يوفر التطبيق إمكانية إظهار نتائج البحث بالرسم الإملائي أو الرسم العثماني.
نظرة تقنية على بنية المشروع
كان الهدف بناء تطبيق سريع دون الاعتماد على أطر ثقيلة، لذا بنيت واجهة التطبيق باستخدام React وTailwind. وهذا تفصيل لأهم 3 نقاط تقنية:
1. استغلال الفهرس المعكوس
بناء على تحديث quran-search-engine الذي انتقل بالمحرك من المصفوفات إلى الـ Maps، فقد استفدت من الفهرس المعكوس المبني مسبقًا، وتمكنت من برمجة طبقة تشابه ديناميكية، حيث تجرد هذه الطبقة كلمات الآية المعنية وتستخرج جذورها ثم تفحص تقاطعاتها مع كامل القرآن في أجزاء من الثانية.
2. الوزن النسبي لندرة الكلمات
لضمان عدم ظهور متشابهات وهمية، أي آيات تشترك فقط في كلمات شائعة (مثل في أو على أو الله)، استخدمت خوارزمية ذكية مستوحاة من خوارزمية IDF. تقيم هذه الخوارزمية مدى ندرة الكلمة بناء على تكرارها في الفهرس المعكوس، وبالتالي فإذا اشتركت آيتان في كلمة نادرة يعطى هذا التشابه وزنًا أعلى بكثير من إذا كانت الكلمة شائعة، وهذا رفع دقة التعرف على المتشابهات بشكل كبير.
3. استخدام خوارزمية مسافة ليفنشتاين Levenshtein
لرفع دقة استخراج الآيات المشابهة، قمت بدمج خوارزمية مسافة ليفنشتاين ضمن طبقة التشابه الديناميكية، حيث يتم حساب مسافة التباين الحرفي وعدد التعديلات اللازمة بين الكلمات وتضمينها عند حساب درجة التشابه، وهذا ساعد على ربط الآيات حتى مع وجود فوارق إملائية أو لغوية.
تجربة التطبيق
يعمل المشروع كليًا على متصفح العميل (Client-side)، ويمكنكم تجربته مباشرة من خلال الرابط التالي:
https://alinice1998.github.io/Furooq/
كما يمكنكم المساهمة في تطويره أو الاطلاع على الكود من خلال زيارة مستودع التطبيق على GitHub:
https://github.com/alinice1998/Furooq/
وختامًا، لدي سؤال: هل جرب أحدكم استخراج الآيات المتشابهة بالاعتماد على نماذج التضمين (Embedding model) مثل gemini-embedding-001، وهل كانت النتائج دقيقة؟ أم تعتقدون أنه من الأفضل الاعتماد على الطرق البرمجية؟


