غالبًا ما نواجه، كباحثين ومطورين مهتمين بتطوير التطبيقات القرآنية نقصًا في توفر البيانات الأساسية وأبرزها بيانات التلاوات عالية الجودة مع توقيتات زمنية دقيقة timestamps
هذه البيانات ضرورية جدًا لتطوير أنظمة البحث الصوتي في القرآن الكريم، وتطبيقات التعرف على التلاوة، وتحليل التجويد وغيرها.
اليوم أشارككم خبرًا نقله لي أحد الزملاء -جزاه الله خيرًا- عن توفر مجموعة بيانات تلاوات ضخمة من خلال مشروع تدبّر Tadabur من إعداد مجموعة إيوان في جامعة الملك سعود وهي مجموعة بحثية متخصصة في مجال معالجة اللغة الطبيعية والذكاء الاصطناعي باللغة العربية.
ما هو مشروع Tadabur؟
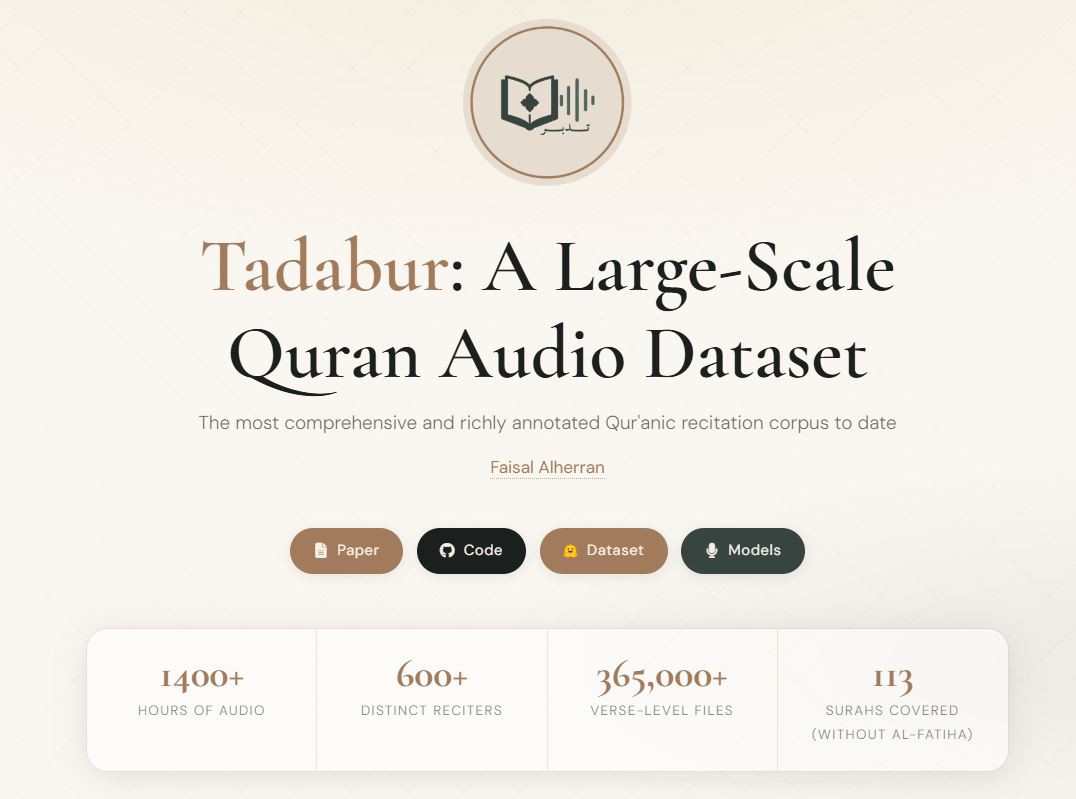
هو مشروع مفتوح المصدر لدعم الأبحاث المتقدمة في تقنيات الصوت واللغة يوفر أكبر مجموعة بيانات صوتية متخصصة في تلاوات القرآن الكريم حتى اليوم.
يتضمن المشروع أيضًا نماذج Whisper تم تخصيصها وتحسينها fine-tuned للتعامل مع خصائص التلاوة القرآنية.
يهدف المشروع إلى سد فجوة كبيرة في الموارد الصوتية العربية، خصوصًا في مجالات التعرف على الكلام ASR، وفهم الخصائص الصوتية والنغمية acoustic and prosodic characteristics للتلاوة القرآنية، بما يشمل تحليل الأداء الصوتي، والإيقاع، والنبرة، وخصائص التجويد ضمن السياق الصوتي للتلاوة.
ما الذي يميز مشروع Tadabur؟
يتميز المشروع بحجمه غير المسبوق، إذ يضم مجموعة بيانات ضخمة ودقيقة تشمل:
- أكثر من 1400 ساعة من التلاوات القرآنية
- أكثر من 600 قارئ من مختلف المدارس الصوتية
- أكثر من 365,000 ملف آية قرآنية
- محاذاة زمنية دقيقة على مستوى الكلمة word-level والآية verse-level
هذه البيانات تمثل نقلة نوعية في معالجة التلاوات القرآنية رقميًا، وتفتح المجال أمام أبحاث أكثر تقدمًا في هذا المجال.
أهداف مشروع Tadabur
تم تصميم مشروع ليكون مرجعًا علميًا يخدم عدة مجالات بحثية متقدمة، من أبرزها:
- التعرف على الكلام العربي ASR: تحسين دقة النماذج في فهم وتفريغ التلاوة القرآنية.
- نمذجة التجويد: تحليل قواعد التجويد صوتيًا لفهم كيفية تطبيقها آليًا.
- التعرف على القرّاء: بناء أنظمة قادرة على تمييز القارئ من خلال صوته وأسلوبه.
- التحليل الصوتي والنغمي: دراسة الخصائص الصوتية للتلاوات مثل الطبقات والوقف والمدود
ما رأيكم في هذا المشروع؟ وهل ترون أن توفير قواعد بيانات قرآنية ضخمة ومخصصة هو الخطوة الأهم لبناء بنية تحتية تدعم تطوير تقنيات فهم القرآن الكريم صوتيًا وفتح آفاق جديدة للابتكار في الذكاء الاصطناعي؟
وما هي الخطوات العملية التي تقترحونها لتوسيع وتوفير المزيد من هذه البيانات لدعم البحث والتطوير في هذا المجال؟
