تحليل اختلاف تسميات المصطلحات القرآنية في المشاريع مفتوحة المصدر
بسم الله الرحمن الرحيم.
أثناء بحثي عن إمكانية بناء معيار موحد للبيانات القرآنية، كان أول سؤال يخطر ببالي هو التسميات. وحيث إن للمصطلحات القرآنية لها خصوصيتها ومعانيها، فيجب التعامل معها بحذر في التقنيات القرآنية. وإن كنا نطمح للوصول إلى معيار لهذه البيانات، فيجب علينا أولًا الإجابة على سؤال: كيف ستُكتب هذه المصطلحات في المعيار؟
وللوصول إلى إجابة (spoiler alert: I did not) بحثتُ في عدة مشاريع مفتوحة المصدر.
أهمية هذا السؤال
قبل البداية، بحثت عن مشاريع مشابهة، وكان أقرب مثال هو مشروع بدأ في عام 2002 تحت مسمى USX (Unified Scripture XML)، وكان هدفه هو توحيد معيار النصوص المسيحية. وهو عبارة عن معيار بصيغة XML.
وهذا المعيار هو المعتمد في أكبر مكتبة رقمية للمصادر المسيحية في العالم، مما يدل على نجاح هذا المعيار. خلال بحثي اكتشفت عدة نقاط رائعة جدًا أدت إلى نجاحه، وأنا أعمل بالفعل على مقالة أشرح فيها سبب نجاح هذا المعيار، والتي من الممكن تعلمها. ولكن ما يهمني الآن هو: كيف تم حل هذه المشكلة - التسميات - ؟
لفهم كيف حُلّت هذه المشكلة يجب فهم ما لا يهدف له هذا المعيار. فالمعيار لا يهدف إلى الترجمة، ولكن يجب أن يُمكّنها. ولكن للوصول إلى ذلك يجب وضع keys متفق عليها (schema) لوصف المعيار نفسه. هدفها فقط تنظيم البيانات وليس لها أي علاقة بما يراه المستخدم النهائي. ولكن إذا تُرجمت هذه الـ keys فإنها تخرج عن كونها معيارًا، وتدخل في نطاق النقاش حول مدى صحة الترجمة. وكان جواب USX طبعًا هو أن تكون هذه الـ keys بالإنجليزية. وحسب هذا المعيار فإن نقاش الترجمة وصحتها متروك لقيم هذه الـ keys وليس لذاتها. وحسب فهمي أنهم اختاروا verse بدلًا من أي كلمة أخرى من أي لغة أصلية للتوراة، لأنه هذا المفهوم متسحدث وقد كتب أصلا باللغة الإنجليزية
طيب، ما فائدة هذا القرار وكيف انعكس على نجاح المشروع؟ ولفهم ذلك يجب أن نشرح بشكل بسيط ماهية هذا المعيار.
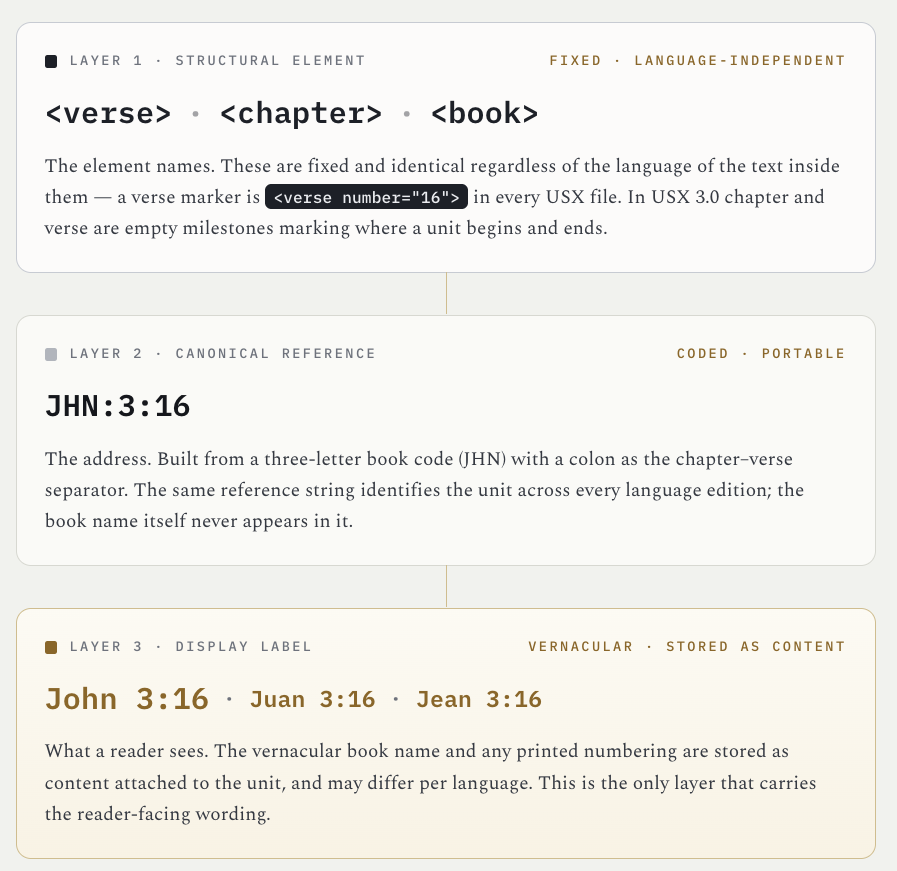
للتبسيط، هنا توضيح كيف يمكن كتابة XML بمعيار USX. وللوصول إلى ذلك يجب توضيح ماهية هذه الـ tags التي تمثل الـ keys التي ذكرناها سابقًا، وهنا بعضها:
<usx><book><chapter><verse><para>
تمثل هذه الـ tags أساس المعيار، والتي لا يمكن أن تتأثر بالترجمة.
والجدير بالذكر أن إحدى أهم منافع هذه الـ tags هي سهولة الوصول للمعلومة، فباستخدام توصيف نموذجي مثلًا:
JHN:3:16
حيث إنه:
Book:Chapter:verse
فبالإمكان الوصول لأي معلومة بسهولة.
والآن نأتي للجواب على سؤال: ما فائدة هذا القرار، وكيف انعكس على نجاح المشروع وانتشاره ودعمه لمئات اللغات؟ دعونا نرى مثالًا على هذا.
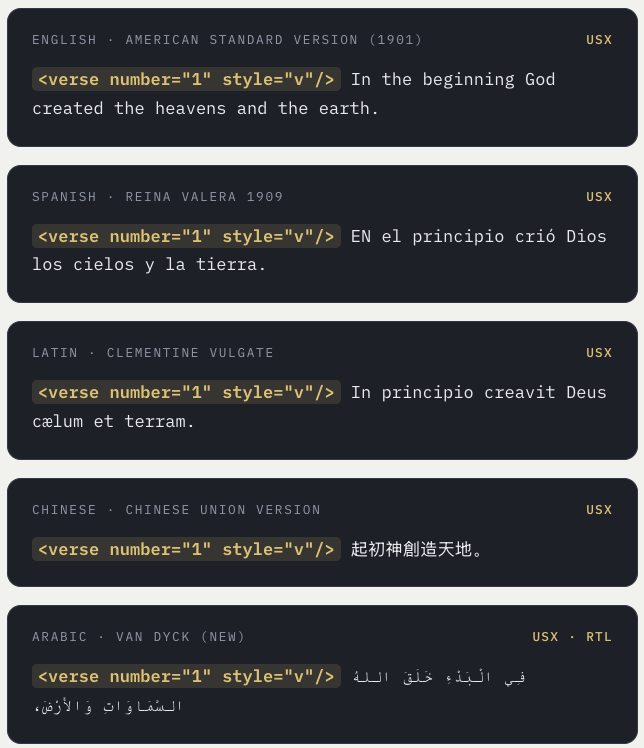
نلاحظ أن الـ tags متسقة بين الجميع ولم تتأثر بالترجمات. وهذا ما يمكن الوصول له إذا تم الإتفاق على keys ثابتة.
المصادر:
نظرة أعمق على المشكلة
بعد أن عرفنا أهمية الإجابة على هذا السؤال، دعونا نلقِ نظرة أعمق على بعض المشاريع المفتوحة المصدر وكيفية تسميتها للمتغيرات والبيانات.
المشاريع التي تم البحث فيها هي:
- mushaf-imad-flutter — Flutter image-based mushaf reader
- miqat — audio forced-alignment backend for timestamping recitations
- quran-page-splitter — mushaf page → line/segment image cropper
- Unified-Quranic-Syntax-Adapted-Database — actually 11 QUL mushaf layout SQLite databases
- QuranDictionary — Arabic-first glossary of tajwīd / waqf / structure terms
- quran.com — de-facto reference platform (Quran Foundation API: github.com/quran + frontend)
- quran-meta — TypeScript Qur'an metadata library
كان السؤال الحاضر أثناء بحثي: ما القرار الذي اتخذه كل من هذه المشاريع فيما يتعلق بالتسميات؟ وقد وجدت هذه النتائج.
ملاحظة : لم يتم عرض الجدول بشكل صحيح هنا بإمكانك معاينته من هذا الرابط بشكل أفضل
| Concept | mushaf-imad | miqat | splitter | QUL | QuranDictionary | quran.com | quran-meta |
|---|
| The book | Mushaf | quran | quran_metadatMushaf | Mushaf | Quran | Mushaf | quran |
| Chapter | Chapter, surah_number | — | Sura/SURAS | surah | Surah/Chapter, Sûrat | chapter (API), Chapter (SDK), surah (UI) | Surah |
| Verse | Verse/Ayah, aya | — | aya | ayah total_ayahs | Ayah/Verse | verse/verse_number (API), verseNumber (SDK), ayah (UI) | AyahNo |
| Juz (1/30) | Part, juz/Juz | — | — | — | Al-Juz'/Juz, Ajza (plural) | juzs, juz (UI) | Juz/JuzMeta, jozz (data), juzs (api) |
| Hizb | hizbNumber | — | — | — | Hizb/Hizbs | hizb (UI) | HizbId |
| Rub al-Hizb | Quarter, hizbFraction | — | — | — | Rub-el-Hizb | rub_el_hizb_number (API), rub (UI) | RubAlHizb/RubAlHizbId, hizbQuarters |
| Manzil | — | — | — | — | Al-Manzil (المنزل؛ "Station/Stopping Place") | manzil_number (API verse only) | Manzil/ManzilMeta, numManzils, manzils (api) |
| Ruku | — | — | — | — | Ar-Rukû'/Ruku | ruku_number | Ruku, rukus |
| Reciter | Reciter | — | — | — | reciter | reciter | Qari |
| Recitation | Riwayah vs rewaya (spelling), Recitation, recitations/style | — | — | Hafs | Methods of Recitation, recitation | recitations/style (API), qirat/QiraatTransmitter, Qiraat (UI) | Riwaya, Narrations |
| Bismillah | — | — | basmala | basmallah | — | bismillah | — |
| Sajda | sajda | — | — | — | Sajdah | sajdah | Sajdah (spelling), sajdas (api) |
| Audio timestamp | startMs/endMs (start_ms/end_ms), startTime/endTime | start/end (SECONDS), confidence/score, AlignmentEngine, segment | SegmentResult/separator_cuts — VISUAL aya region (bbox), NOT audio | — | — | audio_url (per-word file), Segment (SDK type) | — |
- السورة: بعضهم سمّاها
Chapter وبعضهم سمّاها surah، وهنا مثال جيد مع quran.com حيث وضعوا chapter في الـ API وsurah في الواجهات.
- الآية: وهنا تتضح المشكلة بشكل كبير، حيث توجد ٣ حالات وهي:
Ayah تنتهي بحرف HAya لا تنتهي بحرف H- وهناك الجمع أيضًا 😅
ayat
- الجزء: وهنا مجموعة حالات مثيرة للاهتمام أيضًا، حيث هناك
part وjuz وكذلك الجمع juzs. والملاحَظ أن الجمع مشكلة متكررة، وسنتحدث عنها بإذن الله.
- الحزب: أكثر من حالة، ولكن يوجد
Hizb وQuarter.
- ربع الحزب: في quran.com هناك حالتان:
rub_el_hizb وrub-el-hizb، وهناك حالة RubAlHizb في مكتبة quran-meta.
- المنزل: الكل متفق على
manzil.
- القارئ في حالة البيانات الصوتية: هناك حالتان:
qari وreciter.
وهنا مختصر لأبرز الاختلافات.
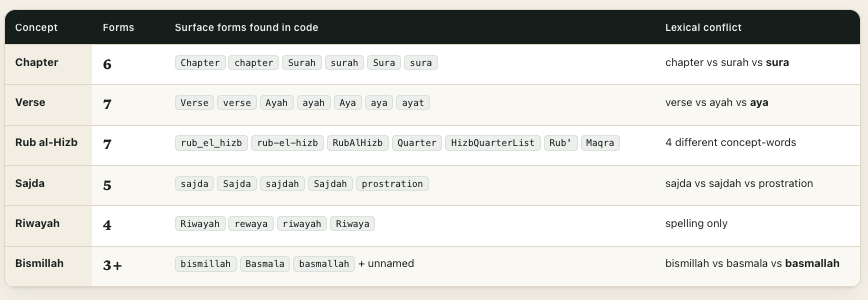
مشكلة الجمع
أغلب هذه المشاريع اعتمدت على خيار المصطلحات الإنجليزية المعرّبة. فمثلًا يتكرر خيار Ayah، وهذا الخيار جيد في البرمجة أثناء تسمية الـ objects، فمثلًا:
class Ayah:
    ...

ayah = Ayah(...)   # كائن واحد
ولكن في حالات الجمع، فمثلًا لو أراد المطور عبر الـ API الوصول إلى collection، كيف يكتب الجمع؟ وهنا وجدت أكثر من حالة:
ayat  = [ ... ]   # جمع عربي
ayahs = [ ... ]   # جمع إنجليزي
وهنا تكمن المشكلة، وهذه في حالة الآية فقط، فطبّق ذلك على بقية الحالات. مثلًا كيف يمكن جمع القُرّاء؟ هل من الممكن كتابة qaris؟
وهذا أكبر تحدٍّ في تبنّي هذا الخيار، فيجب أيضًا إيجاد معيار للجمع لجميع هذه المصطلحات، وإلا فإن اجتهاد كل مطور في الكتابة سيؤدي إلى عكس قيمة المعيار.
كيف يجب أن يكون المعيار في رأيي؟
مشكلة تبنّي التعريب الحرفي هي أننا سنقع في سؤال: هل المخرج بعد الجمع كلمة عربية أم لا؟ أقصد انه كلمة qaris ليست عربية.
أعتقد أنه للتسهيل فإن إضافة s للجمع كافية، بشرط أن تكون الكلمة الأصلية مفردة.
مثلا Qari وجمعها Qaris
وربما يكون شكلها غريبًا، لكني أعتقد أنه الخيار الأمثل.
ملاحظة من الكود
ولعل أوضح دليل على هذه المشكلة هو الاختلاف الذي قد يظهر داخل ملف واحد. ففي مشروع mushaf-imad-flutter، وداخل ملف chapter_index_drawer.dart، يوجد نص واجهة يستخدم الجمع الإنجليزي Surahs، وبجواره نص آخر يستخدم الجمع العربي ayat يعني نظامَي جمع مختلفين في الواجهة نفسها:
'Chapter Index · ${chapters.length} Surahs'
'${chapter.versesCount} ayat'
ماذا يعني كل هذا ؟
المقصد من هذه المقالة هو توضيح حجم التحدي في بناء معايير للبيانات القرآنية، مطوري المكتباب والتقنيات المذكورة اجتهدو جهد كبير جدا في البناء وإيصال القيمة للمستخدمين. وأعتقد أنه من أهم أدوار المجتمع أن يدعم هذا التطور في العمل على مشاريع مثل ( معيار موحد للبيانات ) وتقديمه لهذه المشاريع حتى تسهل عملها وتنقلها إلى مستوى آخر من الجودة وسهولة البناء
طرحت أسئلة كثيرة، وأغلبها لا أملك إجابة لها. ولكن من المهم تفكيك التحدي وعرضه ويهمني جدا معرفة رأيكم!


