السلام عليكم ورحمة الله وبركاته.
من أنا؟
أنا أخوكم كمال ياسر؛ معلم القرآن الكريم، وأحكام التجويد، والعلوم الشرعية للناطقين باللسانين الإنجليزي والألماني. لستُ مبرمجاً بالمعنى التخصصي، بيد أنني أجتهد في تطويع تقنيات الذكاء الاصطناعي والبرمجيات المتاحة لحل المشكلات العملية التي تواجهني.
وإن تخصصت في هذا الباب، إلا أنني أحن دائماً إلى التقنيات وما يتصل بها؛ إذ يملكني شغف قديم بالتقنية، لا سيما ما ارتبط منها بنظام التشغيل Windows، بيد أنني لا أمتلك المعرفة البرمجية الصلبة التي تؤهلني لبناء مشاريع متكاملة بمفردي. ولأجل هذا، أتابع مستجدات التقنية وأخبارها باستمرار، وخاصة ما يتعلق بالذكاء الاصطناعي (AI).
قصتي مع مجتمع إتقان
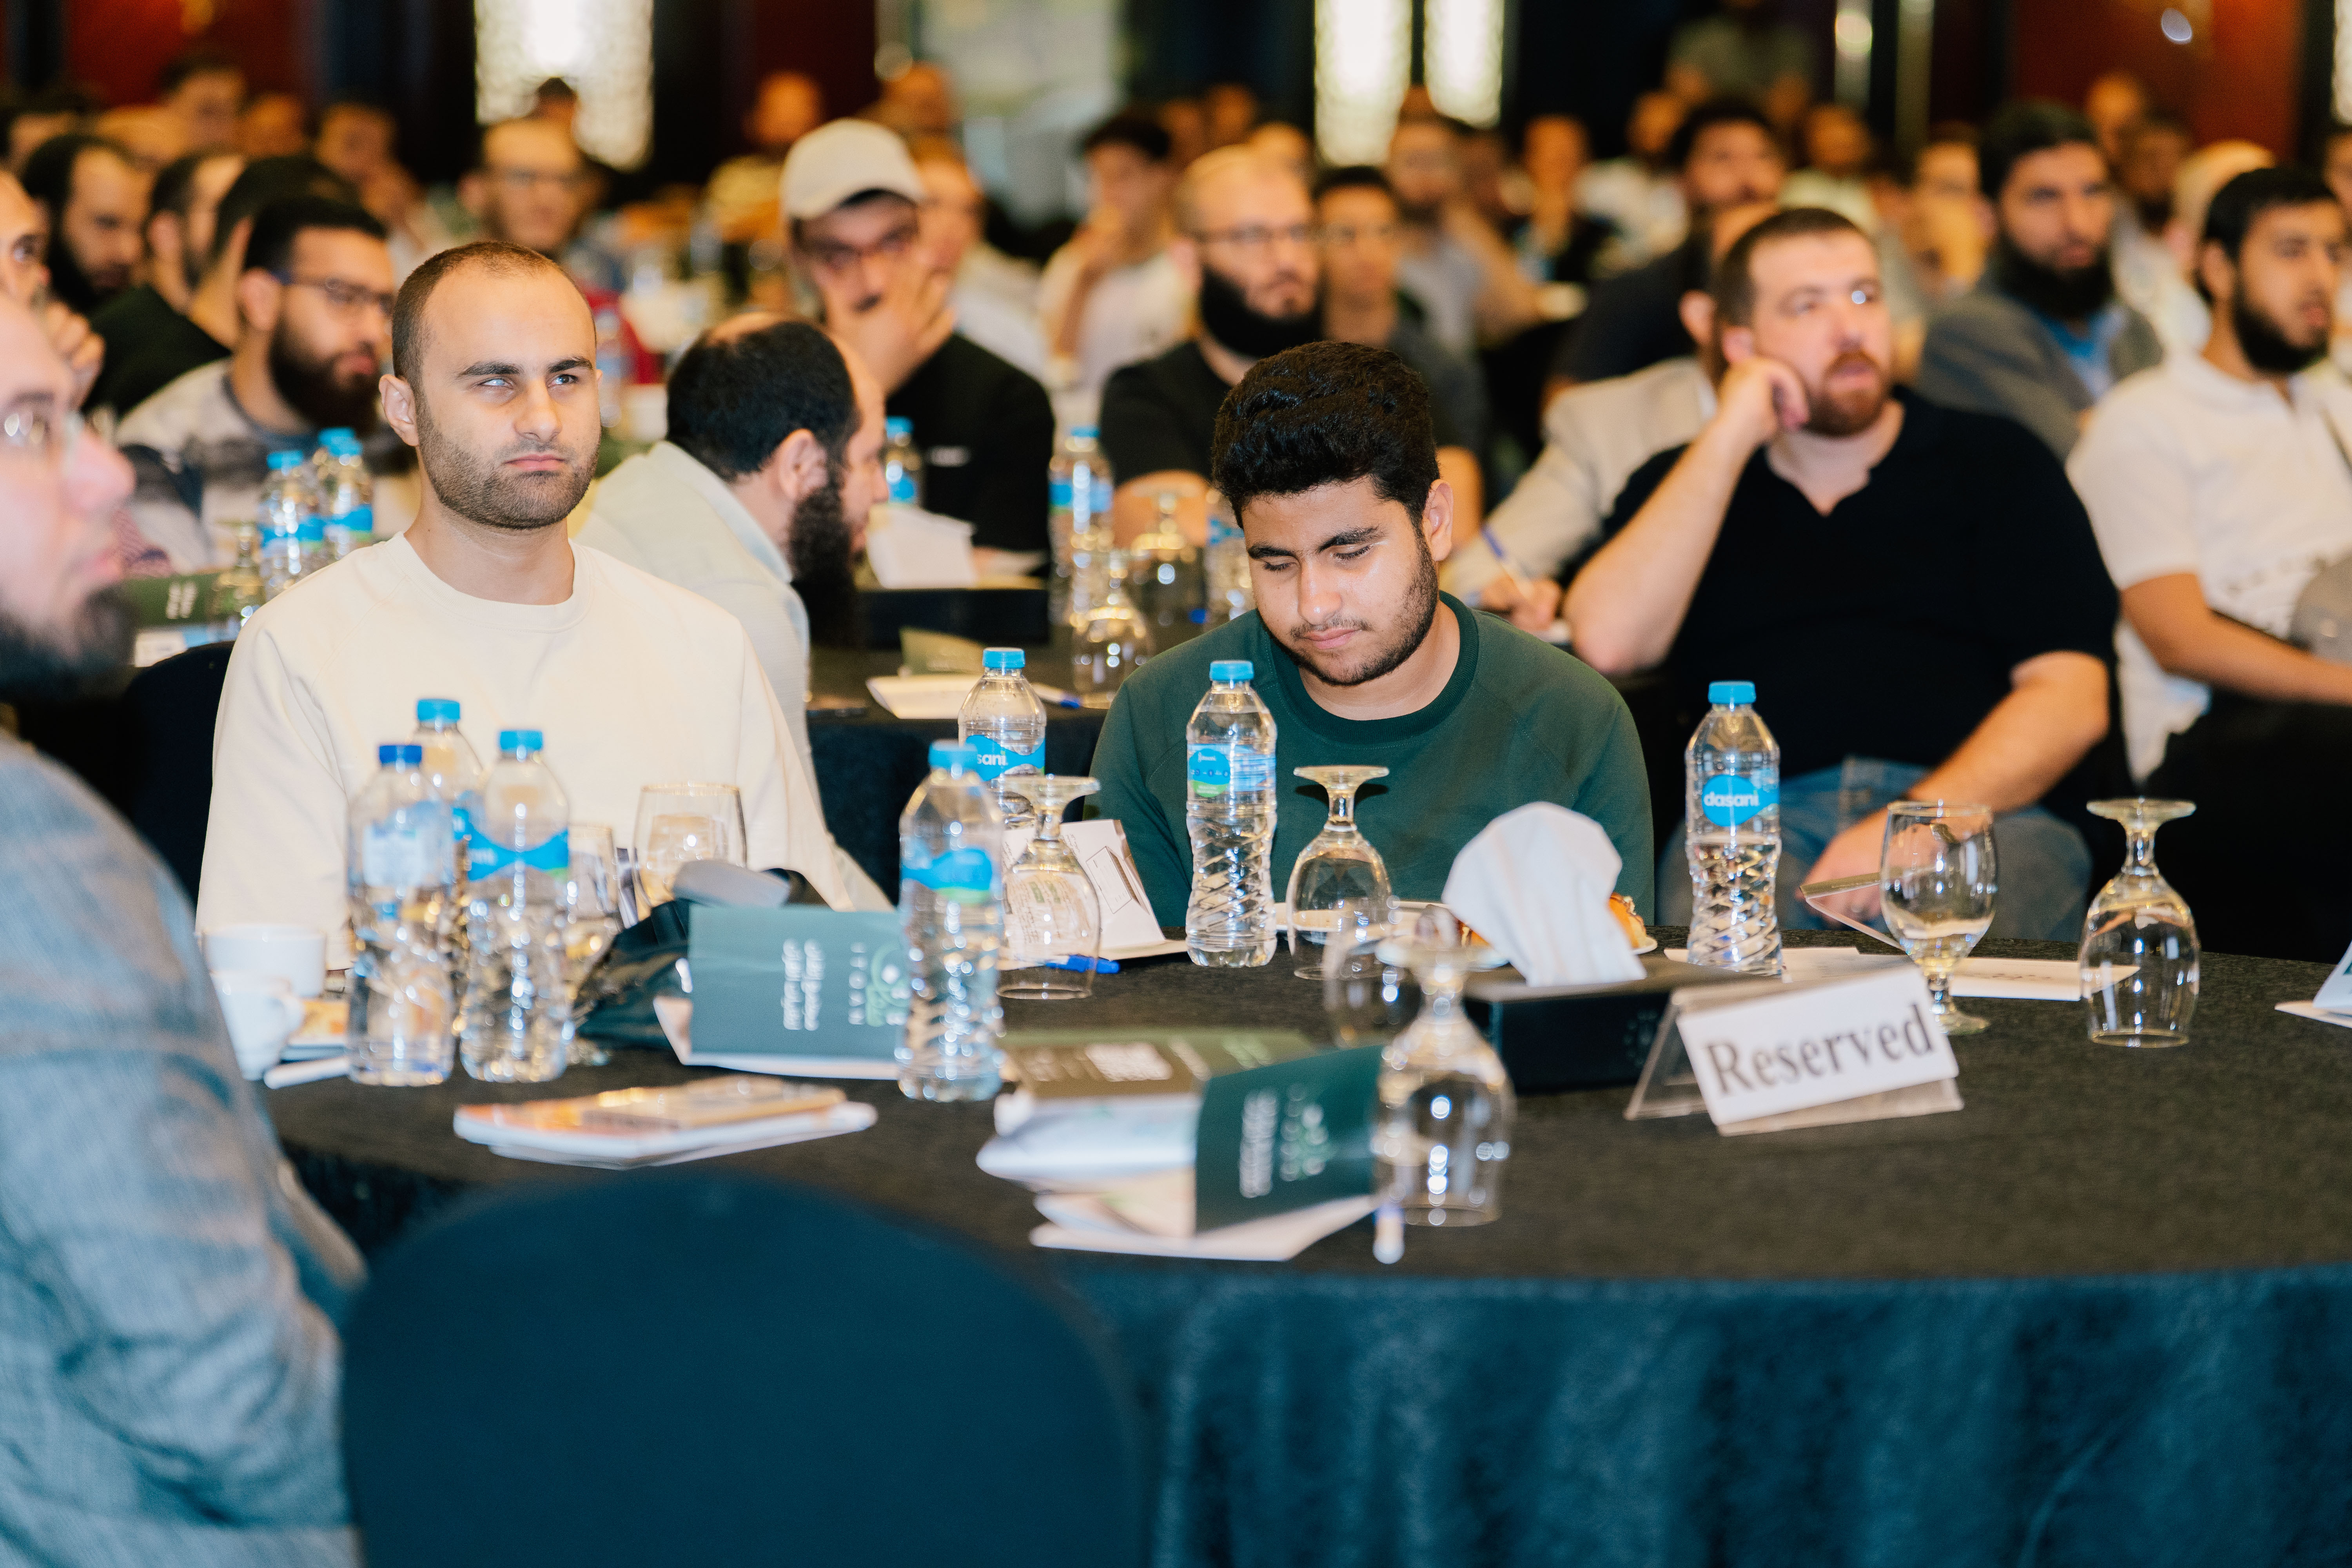
بدأت معرفتي الحقيقية بهذا المجتمع المبارك إثر حضوري لملتقى «إتقان» بالقاهرة. وهناك لقيت نخبة من المبرمجين والمهتمين بالتقنيات القرآنية. ومما دفعني للمشاركة معهم هو بشاشة الاستقبال وروح التعاون التي تسود الجمع، بل إن التشجيع الذي لقيته منهم كان الحافز الأكبر لنشر مشروعاتي وأفكاري البرمجية التي كانت حبيسة جهازي لعدم اكتمالها، مثل مشروعات معالجة وهيكلة كتب التفسير والتدبر في ملفات (JSON) والتي شاركتُ بعضَها معَ مجتمعِ إتقان للانتفاعِ بها.
استجابة لهذه الدعوة الكريمة لعرض تجربة رقمنة العلوم وتذليل عقبات التعرف البصري على النصوص (OCR)، أضع بين أيديكم هذه السطور كمدخل لمدارستنا في هذا اللقاء. وسأركز هنا على تجربة كف البصر وما تفرضه من تحديات عملية في قراءة كتب العلم وتصفحها.
كف البصر وعقبة الكتب المصورة
لما كنت فاقداً للبصر، فقد اصطدمت مباشرة بعقبة تلقي كتب العلم الشرعي ومصنفاته؛ إذ لا يزال جل التراث حبيساً في قوالب مصورة (ممسوحة ضوئياً - PDF) لا سبيل لقارئات الشاشة إليها. هذا التحدي لم يقف عند حد الصعوبة، بل كان الحافز لولوج ميدان رقمنة الكتب وتطويع التقنية لفك هذا الحصار المعرفي.
أطوار رحلتي مع التعرف الضوئي
لقد عكفت على التعامل مع التقنيات والبرمجيات منذ أكثر من خمس عشرة سنة إبان يفاعتي، وكنت أتتبع كل جديد يطرح في مضمار رقمنة الكتب وتصفحها. وقد مرت تجربتي بأربعة أطوار رئيسية، تترجم عثرات وعقبات التعرف البصري (OCR) للمكفوفين:
الطور الأول: البرمجيات التقليدية (عقود الخيبات وتشويه المتون)
الاعتماد الكامل على برامج الـ OCR التقليدية القديمة. وكانت أقصى دقة تبلغها لا تتجاوز 80% في أحسن أحوالها، بل كانت تسقط عند أول اختبار حقيقي أمام كتب العلم والمصنفات المشكولة؛ فتخرج النصوص مشوهة تماماً وتستحيل قراءتها؛ حيث تتداخل الحواشي السفلية بالمتون، وتضطرب الحروف وتشكيلها، ويفقد النص القرآني رسمه العثماني. فضلاً عن عجز هذه البرامج عن دعم ثنائية اللغة (مثل الكتب التي تجمع بين النصوص العربية والألمانية)، وعجزها التام عن وصف الصور التوضيحية والمخططات المدرجة في الكتب، وهي ميزة جوهرية لتصور محتوى الصفحة للمكفوفين. أما المنظومات العلمية والشعرية فكان من شبه المستحيل تماماً تحويلها ورقمنتها بشكل فصيح ومفهوم.
الطور الثاني: واجهات النماذج اللغوية (المحاولات اليدوية الشاقة)
مع ظهور الذكاء الاصطناعي، كنت أرفع ملفات الـ PDF مباشرة على مواقع النماذج اللغوية لتفريغها. ورغم تحسن جودة التعرف على الكلمات، إلا أن هذه الطريقة كانت شاقة؛ إذ إن نافذة المحادثة في النماذج لا تستوعب أكثر من 30 إلى 50 صفحة، وتبدأ بعد ذلك بالهلوسة وخلط السياق، مع عجزنا التام عن تنفيذ أي آليات تدقيق ومطابقة برمجية صارمة عليها.
الطور الثالث: الـ API من Google (السكربتات المساعدة وضيق حدود الاستخدام)
الانتقال لربط السكربتات المساعدة بواجهة برمجة التطبيقات (API) من Google لرقمنة الملفات، مستفيداً من السعة المجانية السخية آنذاك. بيد أن مشكلة هذا الطور تجلت حين تراجعت حدود الاستخدام المجاني للـ API بشكل ملحوظ وضاق متسعها. ورغم أن بعض المكفوفين قد طوروا بالفعل حلولاً تعتمد على الـ API وما زالوا يسعون في هذا الاتجاه، إلا أن الشواهد تؤكد أن الشركات الكبرى المقدمة للنماذج لن تدع الحلول المجانية طويلاً.
الطور الرابع: الطور الحالي (مهارة الذكاء الاصطناعي - AI Skill)
الطور الناضج الذي يعتمد على مهارة استخلاص النصوص وتنسيق الأجزاء (ocr-transcription)؛ وهي مهارة مهيأة للتثبيت داخل وكيل ذكاء اصطناعي (AI Agent) لتدير مسار عمل تتابعياً متكاملاً. يقوم الوكيل الرئيسي بتقسيم الملفات إلى أجزاء (chunks) لا تتجاوز 20 صفحة لمعالجتها بالتوازي عبر وكلاء فرعيين، ثم يجري تحققاً مؤجلاً لترقيم الصفحات، وينفذ بروتوكولات التعافي والدمج والتحويل التلقائي.
الحل: مشروع OCR Workflow
ومن رحم هذه المعاناة، وتوالي خيبات الأدوات التقليدية، عكفت على التطوير بمفردي على مدار شهرين كاملين، خضت خلالهما تجارب مضنية لتعويض نقص خبرتي الصريحة في البرمجة. قد يبدو هذا العمل للبعض مشروعاً يسيراً يمكن إنجازه في بضع ساعات، بيد أن الحقيقة خلاف ذلك تماماً؛ فلا يعرف قيمة وتكلفة كل سطر كتب في هذه المهارة إلا من اختبر عثرات النماذج اللغوية وتناقضاتها، وعالج مئات الكتب والصفحات عملياً، ليقوم المسار ويطوره كرة بعد كرة حتى استقام باسم «مسار عمل استخلاص النصوص ورقمنة الكتب» (OCR Workflow).
ولأجلِ هذا، فقد ترددت كثيراً في إخراج هذا العمل للناس؛ لأنني لا أراه سلساً ميسر الاستخدام للخلق كافة أو خالياً من الأخطاء، وقد يعتريه النقص لبساطة معرفتي التقنية المتخصصة، كما لا يسعفني قلة خبرتي بالبرمجة في تحويل أفكاري إلى منتج تام يستفيد الناس منه مباشرة، إضافة إلى عجزي عن تصميم الصور المناسبة لواجهات وبيان المشروعات. وأقدم اعتذاري الصادق للإخوة إن كانت مشروعاتي تخرج دائماً غير مكتملة؛ بيد أنني مستعد للتعاون والمساهمة في المجتمع بما أستطيع وما يتيحه لي جهدي البسيط ولو كان قليلاً. إنني أحب المشروعات المفتوحة المصدر، ولدي مشروعات أخرى سأنشرها تباعاً في هذا المجتمع المبارك، وقد شجعني دعم الإخوة هنا على تجاوز هذا التردد، إيماناً بأن قوة مجتمعنا تكمن في سد الخلل وإكمال النقص بالتشارك البناء.
هذا المشروع ليس برنامجاً تقليدياً مغلقاً، بل هو عبارة عن مهارة (Skill) برمجية مخصصة تُثبَّت في بيئة عمل الوكيل لتوجيه سلوكه. وهي تسلك مساراً تتابعياً محكماً؛ يبدأ بتقسيم ملف الـ PDF وتهيئة الأجزاء (chunks)، ثم معالجتها برمجياً وتصحيحها، وصولاً للتحقق المؤجل (Deferred Validation) للتأكد من سلامة ترقيم الصفحات، ودمج الأجزاء، وتحويلها آلياً إلى مستندات Word عبر Pandoc. وقد اختبرت المهارة جيداً على نماذج Gemini المتعددة، وأستفيد منها كثيراً وبشكل يومي في تحويل كتبي وتصفحها.
وعلى الرغم من أن هذا المسار يستهلك كماً كبيراً من الرموز (Tokens) أثناء معالجة الصفحات وإعادة تصحيحها، إلا أن هذا الاستهلاك مقبول تماماً مقارنة بدقة النتائج الباهرة التي يخرجها. بيد أنني أطمح مستقبلاً لتجربة هذه المهارة على نماذج لغوية محلية (Local LLMs) واختبار كفاءتها، لتفادي الاعتماد الكلي على النماذج السحابية المدفوعة، وهي مسألة ذات أولوية قصوى لدي نظراً لارتفاع كلفة النماذج يوماً بعد يوم، غير أنني لا أمتلك الإمكانات التقنية والعتاد اللازم لتحقيق ذلك بمفردي.
المشكلات الخمس التي يحلها المشروع
نجح هذا المسار في حل مشكلات رئيسية كانت تستعصي على البرمجيات المعتادة، وهي:
- تفكيك النصوص المشكولة: ضبط حركاتها لتقرأها البرامج بشكل صحيح.
- معالجة اللغات المختلطة: إدارة وجود أكثر من لغة في الصفحة الواحدة بسلاسة (كالعربية والألمانية).
- مطابقة الأرقام العربية: ضبط رسم الأرقام وتنسيقها.
- فصل المتون عن الحواشي: عزل الحواشي السفلية والجانبية بدقة لمنع التداخل السمعي أثناء القراءة.
- تحويل المنظومات الشعرية: ضبط الصدر والعجز وفصل شطري البيت بفاصل قياسي موحد بعد أن كان تحويل المنظومات العلمية والشعرية شبه مستحيل.
ركائز الحل التقني
وينشط هذا النظام عبر ثلاث ركائز أساسية:
التفتيت والمعالجة المتوازية:
تقسيم الكتب الضخمة لصفحات يسيرة لمعالجتها بالتوازي محلياً للتغلب على قيود ذاكرة النماذج وضمان سلامة ترقيم الصفحات بصورة آلية بالكامل.
ميثاق النسخ والأمانة العلمية:
تقويم انحراف الحروف وتشويه الكلمات الناتج عن التعرف البصري مع توثيق اللفظ الأصلي المحرف في الحواشي السفلية أمانة للنقل، واستبدال الآيات ورسمها بالرسم العثماني الموثق (بالمطابقة مع قاعدة بيانات المصحف) وجعلها بين الأقواس المخصصة للآيات، لتنطقها قارئات الشاشة نطقاً سليماً خالياً من اللحن والنقص.
الهيكلة المتوافقة مع قارئات الشاشة:
ترتيب الحواشي الجانبية والسفلية وصياغتها بنظام Markdown، وصياغة الجداول وتجريدها من الفراغات الزائدة لتقرأها الآلة بتسلسل سليم، مع تضمين أوصاف نصية موجزة ومباشرة للصور والرسوم التوضيحية (مثل: [صورة: وصف]) بدلاً من تجاهلها أو نطق وسومها البصرية المعيقة، وتصدير المخرجات برمجياً لملفات Word منسقة ومعدة سلفاً باتجاه الكتابة العربي (RTL) عبر أداة Pandoc.
ضمانات الموثوقية والأمانة العلمية
لضمان دقة رقمنة كتب العلم وتلافي عيوب الأتمتة المعتادة، تلتزم المهارة ببروتوكول تشغيل صارم يحقق الآتي:
- الأمانة وحظر التخمين: في حال وجود تلف مادي بالصفحة (كبقع الحبر أو التمزق) يمتنع الوكيل عن تخمين الكلمات، ويستبدلها بوسم سببي تفصيلي (مثل:
[نص غير مقروء لخلل مادي...])، مع توثيق الأخطاء المطبعية في حواشٍ سفلية أمانةً للنقل الأصلي.
- تجميد العمل عند الخطأ (Freeze Protocol): عند حدوث أي خطأ برمجي أو نفاد للذاكرة في السكربتات المساعدة، يتوقف الوكيل الرئيسي فوراً ويقدم تقريراً تفصيلياً للمستخدم بدلاً من الدخول في حلقات مفرغة تبدد الرموز.
- التعافي الذاتي للجزئيات: إذا فشل التحقق البرمجي لـ (chunk) معين، يُحذف الملف التالف تلقائياً ويعاد استخلاصه والتحقق منه منفرداً دون إفساد بقية أجزاء الكتاب.
- ترشيد استهلاك الرموز (Anti-Rewrite): يلتزم الوكيل باستخدام أوامر النظام المباشرة (مثل نقل ونسخ الملفات) بدلاً من إعادة توليدها برمجياً، توفيراً للتكلفة وحفظاً للموارد.
الخطوات المستقبلية
- الانتقال للنماذج المحلية: يظل العائق الأكبر أمام انتشار هذه المهارة هو تكلفتها المرتفعة؛ إذ لا يستطيع الاستفادة منها حالياً إلا من يملك اشتراكاً مدفوعاً في واجهات النماذج اللغوية الكبرى المشهورة، وتكلفة الرموز (Tokens) للكتاب الواحد باهظة ومكلفة. لذا، يتركز طموحي القادم على اختبار وتطويع المهارة لتعمل بكفاءة على النماذج اللغوية المحلية (Local LLMs) لإنهاء المعاناة المادية مع الشركات الكبرى وتعميم نفعها مجاناً للجميع؛ كما أن نجاح هذا الاختبار سيفتح آفاقاً واسعة للمؤسسات العاملة في رقمنة كتب التراث والعلوم الشرعية، لتسريع وتسهيل عمليات التحويل على نطاق واسع بكفاءة وبأقل تكلفة.
- تطوير السكربتات البرمجية: السعيُ الدائمُ لتحسينِ ملفاتِ المهارةِ وأكوادِ السكربتاتِ المساعدةِ (مثلِ بروتوكولاتِ التقسيمِ والتحققِ والدمجِ) وتطويرِ منطقِها البرمجيِّ، لضمانِ دقةٍ أعلى في الاستخلاصِ وتلافياً تاماً للأخطاءِ التقنيةِ.
- مراجعة الشفرات والمعايير: تطلعُنا لعرضِ ملفاتِ المهارةِ وشفراتِ السكربتاتِ على خبراءَ ومتخصصينَ في الذكاءِ الاصطناعيِّ ولغةِ Python، لإجراءِ مراجعةٍ شاملةٍ وتأكيدِ موائمتِها للمعاييرِ البرمجيةِ والتقنيةِ القياسيةِ.
ومن هذا المنطلق، أهيب بالإخوة المطورين والخبراء في مجتمع «إتقان» ممن لديهم الإمكانيات الفنية والعتاد اللازم أو الخبرة البرمجية، مشاركتي وتوجيهي في تنفيذ هذه الخطوات وتجاوز هذه العقبات مجتمعين لخدمة تراثنا وتيسيره للجميع.
دعوة للمدارسة
يسرني في هذا اللقاء أن أستقبل أسئلتكم ومذاكرتكم حيال تحديات كف البصر في التعامل مع الكتب الشرعية، والبنية التقنية لهذا المشروع، ومستجدات تيسير الوصول للمكفوفين في التطبيقات والبرمجيات الإسلامية. كما أنني أنتظر بلهفة مساهمات المطورين الأفاضل معي في تطوير هذا المشروع وسد ثغراته لتعميم نفعه.
بانتظار تفاعلكم وأسئلتكم الطيبة.
مستودع المشروع مفتوح المصدر على GitHub:
https://github.com/kamalyaser31/ocr-workflow
