التاريخ: 18 يوليو 2026
المهارة المُختبَرة: .claude/skills/ocr-transcription/
** رابط المشرع:** https://github.com/kamalyaser31/ocr-workflow
الملف المُختبَر: كتاب تأملات قرآنية — تأليف: محمد بن فوزي العاملي (177 صفحة)
المصدر: شبكة الألوكة (تحميل PDF الأصلي)
النموذج ومُقدّم الخدمة: MiniMax / minimax 2.5 (جهد متوسط / Medium Effort)
العميل المستخدم: إضافة Claude Code لبيئة VS Code
1. نبذة عن الكتاب والتجربة
تم اختيار كتاب تأملات قرآنية كمادة للاختبار نظرًا لكونه نموذجًا مرجعيًا ممتازًا لمعالجة المستندات العربية المعقدة؛ فهو يتكون من 177 صفحة وتتحقق فيه معظم الحالات الحدّية (Edge cases):
- آيات قرآنية باللون الأحمر ومحاطة بالأقواس المزخرفة ﴿ ﴾ مع تشكيل كامل.
- نصوص وتأملات بالاتجاه العربي (RTL) مع وجود علامات مائية لشبكة الألوكة.
- صفحة فهرس تفصيلية للآيات في آخر 25 صفحة من الكتاب.
2. بيئة العمل وأدوات التشغيل (Tech Stack)
| المكون | القيمة / الأداة |
|---|
| نظام التشغيل | Windows 11 Home (10.0.26200) عبر Git Bash |
| النموذج / المنسق | MiniMax 2.5 (عبر Claude Code) |
| تحويل PDF لصور | pdftoppm (من حزمة Poppler portable v24.08.0) |
| معالجة وتجميع | مكتبة Python pypdf (عبر سكربتات validate_chunk و merge_parts) |
| التصدير النهائي | pandoc للتصدير إلى Word مع وسْم dir=rtl |
3. مسار التنفيذ الخطوي (Chronological Workflow)
[ملف PDF (177 صفحة)] ➔ (pdftoppm) ➔ [صور دقيقة للصفحات] ➔ (9 وكلاء فرعيين/Subagents) ➔ [ملفات part_N_temp.md] ➔ (merge_parts.py) ➔ [md/tamalatqurania.md] ➔ (Pandoc) ➔ [word/tamalatqurania.docx]
- مرحلة الإعداد والتجهيز:
- تشغيل أمر
/ocr-transcription داخل بيئة VS Code.
- اكتشاف عدم توفر
pdftoppm على النظام، وتثبيت النسخة المحمولة (Portable Poppler) وإضافتها للمسار (PATH).
- الاستخلاص بالتوازي:
- تقسيم المستند وإطلاق 9 وكلاء فرعيين (Subagents) للعمل بالتوازي، حيث قام كل وكيل باستخلاص جزء مخصص من الكتاب.
- التحقق والتجميع:
- تشغيل
validate_chunk.py --all: نجاح 9/9 أجزاء.
- الدمج عبر
merge_parts.py لإنتاج الملف الموحد md/tamalatqurania.md بحجم 66 كيلوبايت.
- التصدير إلى Word:
- استخدام Pandoc لإنشاء ملف
word/tamalatqurania.docx (بحجم 32 كيلوبايت) يدعم الاتجاه من اليمين إلى اليسار تلقائيًا.
4. النتائج وإحصائيات استهلاك الرموز (Token Metrics)
📊 النتيجة الإجمالية:
- ✅ استخلاص كامل ومستقر: تم استخراج النصوص العربية بنسبة 100% مع الحفاظ على الرسم العثماني/الأقواس المزخرفة ﴿ ﴾ للآيات.
- ✅ الحفاظ على حدود الصفحات: إدراج فواصل الصفحات بشكل منظم (
--- Page N ---).
- ✅ تنسيق Word RTL متكامل: تصدير وثيقة جاهزة للقراءة بجهة خط عربية صحيحة.
📈 استهلاك الرموز (Tokens):
- إجمالي الرموز المستهلكة: 110.41 ألف رمز (110.41 K Tokens).
- ضريبة التشغيل الأول (Cold-Start Tax): تم استهلاك حوالي 20-25 ألف رمز بسبب إعداد البيئة، وأخطاء تثبيت الحزم، وإعادة ضبط مسارات النظام.
- التكلفة المتوقعة للتشغيل اللاحق (Warm Run): تُقدّر بـ 80-90 ألف رمز (أي بتوفير يتراوح بين 20% إلى 25%) نظرًا لتوفر الأدوات والبيئة الجاهزة.
5. أبرز التحديات الفنية وكيف تم حلها
| # | المشكلة / التحدي | الحل المتبع |
|---|
| 1 | عدم اكتشاف المهارة في VS Code | تبين أن إضافة Claude Code تبحث فقط داخل .claude/skills/ وليس .agents/skills/. تم إنشاء وصلة رمزية (Symlink) أو نسخ المهارة إلى المسار المعتمد. |
| 2 | تحديث متغيرات البيئة (PATH Caching) | عملية الـ Read في Claude Code تقوم بتخزين الـ PATH عند بدء الجلسة؛ لذا لزم إعطاء إعادة تشغيل كاملة لـ VS Code بعد تثبيت pdftoppm و pandoc. |
| 3 | عراقيل صلاحيات المسؤول (Admin Rights) | فشل choco install لعدم وجود صلاحيات؛ تم الاعتماد على النسخة المحمولة (Portable Release) لبرنامج Poppler والـ Installer الرسمي لـ Pandoc. |
| 4 | تعليق الوكلاء الفرعيين في Plan Mode | ورث الوكلاء الفرعيون "نمط التخطيط" من الجلسة الأم؛ تم التعامل معهم عبر توجيه رسائل تأكيد لتجاوز النمط ومباشرة الكتابة. |
6. اكتشاف فني جوهري: مسار المهارات المعتمد
💡 معلومة هامة للمطورين:
لتشغيل أي مهارة في إضافة VS Code Claude Code عبر أوامر الشَرطة المائلة (مثل /ocr-transcription)، يجب أن توجد المهارة حصريًا في المسار:
<workspace>/.claude/skills/<skill-name>/SKILL.md
الحل الأمثل في حال التثبيت اليدوي: إنشاء وصلة رمزية (Symlink) من جذر المشروع:
cd .claude/skills && ln -s ../../.agents/skills/ocr-transcription ocr-transcription
7. 🚀 تطور جديد: التثبيت السهل بنقرة واحدة عبر NPM
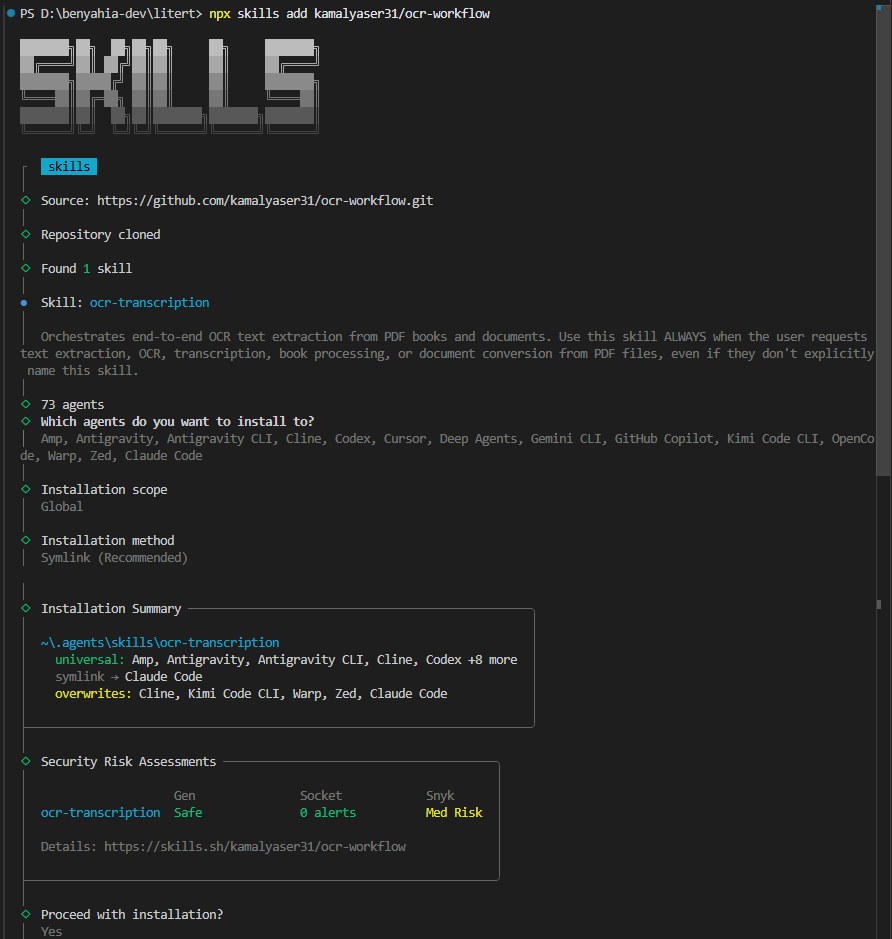
بعد إجراء المزيد من الاختبارات والتطوير، تم التوصل إلى حل جذري لمشكلة إعداد البيئة (البداية الباردة)، وذلك بفضل التنظيم الهيكلي الممتاز للمستودع (Repo). الآن، لم يعد المستخدم بحاجة إلى النسخ اليدوي للملفات أو إنشاء وصلات رمزية (Symlinks) معقدة كما ورد في قسم الاكتشافات.
يمكن الآن تثبيت مهارة ocr-transcription على مختلف وكلاء الذكاء الاصطناعي (AI Agents) بكل سهولة عبر أمر برمجي واحد:
npm skills add kamalyaser31/ocr-workflow
مميزات هذه الطريقة:
- التنصيب والتحديث المباشر: أمر واحد يقوم بجلب الملفات ووضعها في المسار الصحيح المعتمد تلقائيًا (
.claude/skills/ أو ما يكافئه حسب بيئة الوكيل).
- التوافق الواسع: بفضل التغليف (Packaging) الاحترافي، أصبحت المهارة قابلة للاستخدام والتحديث بسهولة على بيئات متعددة خارج إطار VS Code المحدود.
8. توصيات لمطوري المهارات (Developer Recommendations)
- إضافة فحص قبلي تلقائي (Pre-flight Checks):
إدراج أمر فحص عند بداية تشغيل المهارة للتأكد من وجود pdftoppm و pandoc و pypdf قبل إطلاق الوكلاء، لتوفير 12 ألف رمز في حال وجود نقص.
- منع توارث Plan Mode:
حقن تعليمات صريحة للوكلاء الفرعيين تنص على تجاوز نمط التخطيط ومباشرة الكتابة في part_N_temp.md.
- توسيع وسائل تثبيت Pandoc:
تحديث سكربت convert_to_docx.py ليدعم طرق تثبيت وسيطة أو التنزيل المباشر في حال غياب winget.
9. الخلاصة
أثبتت مهارة ocr-transcription بالكامل كفاءتها وجاهزيتها للإنتاج (Production-ready). بالرغم من أن التجربة الأولى استلزمت بعض التدخلات اليدوية لإعداد الأدوات المساندة، إلا أن المستند الناتج جاء بدقة ممتازة وتنسيق عربي متقن. علاوة على ذلك، أدى التنظيم الهيكلي الفائق للمستودع وتوفير حزمة NPM سهلة التثبيت إلى إزالة عقبات "التشغيل البارد" عمليًا، ليصبح نشر وتحديث المهارة على وكلاء الذكاء الاصطناعي تجربة سريعة وسلسة بأمر برمجي واحد.
📂 المخرجات النهائية للتجربة:
