Wael
أحمد شمس
جزاكم الله خيرًا، وسؤالك مهم جدًا، وخليني أوضح الفكرة بالتفصيل.
في البداية، أنا لم أعتمد على Claude Code باعتباره مصدرًا للمحتوى، وإنما استخدمته كأداة مساعدة في الاستخراج والمقارنة والتنظيف والتنظيم.
1. المصادر
كان عندي مصدر أساسي أردت أن يكون هو المرجع النهائي للمحتوى، وهو تفسير التحرير والتنوير لابن عاشور، واعتمدت على نسخة الكتاب الموجودة على المكتبة الشاملة:
https://shamela.ws/book/9776/6606
وأعطيت Claude Code إمكانية الوصول إلى الكتاب كاملًا، وليس فقط إلى صفحات معينة، حتى يكون المصدر الأصلي متاحًا له بالكامل أثناء عملية الاستخراج.
وفي نفس الوقت، جمعت له عددًا من المواقع الإسلامية التي تعرض معلومات ومقدمات السور. بعض هذه المواقع تعرض المحتوى داخل الموقع، لكن لا توفره بشكل مفتوح أو من خلال API يمكنني الحصول على البيانات منه مباشرة.
ولم أتعامل مع هذه المواقع باعتبارها مصدرًا للنص، وإنما استخدمتها كمرجع مساعد لتحديد نوع المحتوى المطلوب والجزء الذي نبحث عنه.
بالتالي كان عنده بشكل أساسي:
- المصدر الأصلي: كتاب التحرير والتنوير كاملًا.
- مصادر مساعدة: مواقع إسلامية تعرض مقدمات وعلوم السور.
والهدف من المقارنة كان أن نعرف ما المحتوى المطلوب، ثم نرجع إلى المصدر الأصلي ونستخرج النص المقابل منه، بدل الاعتماد على النص الموجود في المواقع الأخرى.
2. استخراج النصوص
بعد ذلك استخدمت Claude Code في كتابة سكربت يستطيع التعامل مع محتوى الكتاب الإلكتروني الموجود على المكتبة الشاملة.
السكريبت يمر على السور الـ114، ويحدد موضع كل سورة، ثم يستخرج المحتوى المطلوب ويخزنه كبيانات خام.
فبدل ما أفتح كل سورة يدويًا وأنسخ النص منها، أصبحت عملية الاستخراج آلية، وأصبح عندي في النهاية ملف يحتوي على البيانات الأولية لكل سورة.
3. المعالجة والتنظيف
بعد استخراج البيانات الخام، بدأت مرحلة المعالجة باستخدام Python.
تم تنظيف النصوص ومعالجة المشاكل الناتجة عن الاستخراج، وترتيب المحتوى بحيث يكون لكل سورة سجل مستقل، ثم تجهيز الحقول بالشكل المناسب لقاعدة البيانات.
وفي هذه المرحلة أيضًا استفدت من Claude Code في مراجعة الناتج، ومقارنته بالمصادر المساعدة للتأكد من أن المحتوى الذي تم استخراجه هو الجزء المقصود من مقدمات السور.
4. بناء قاعدة البيانات
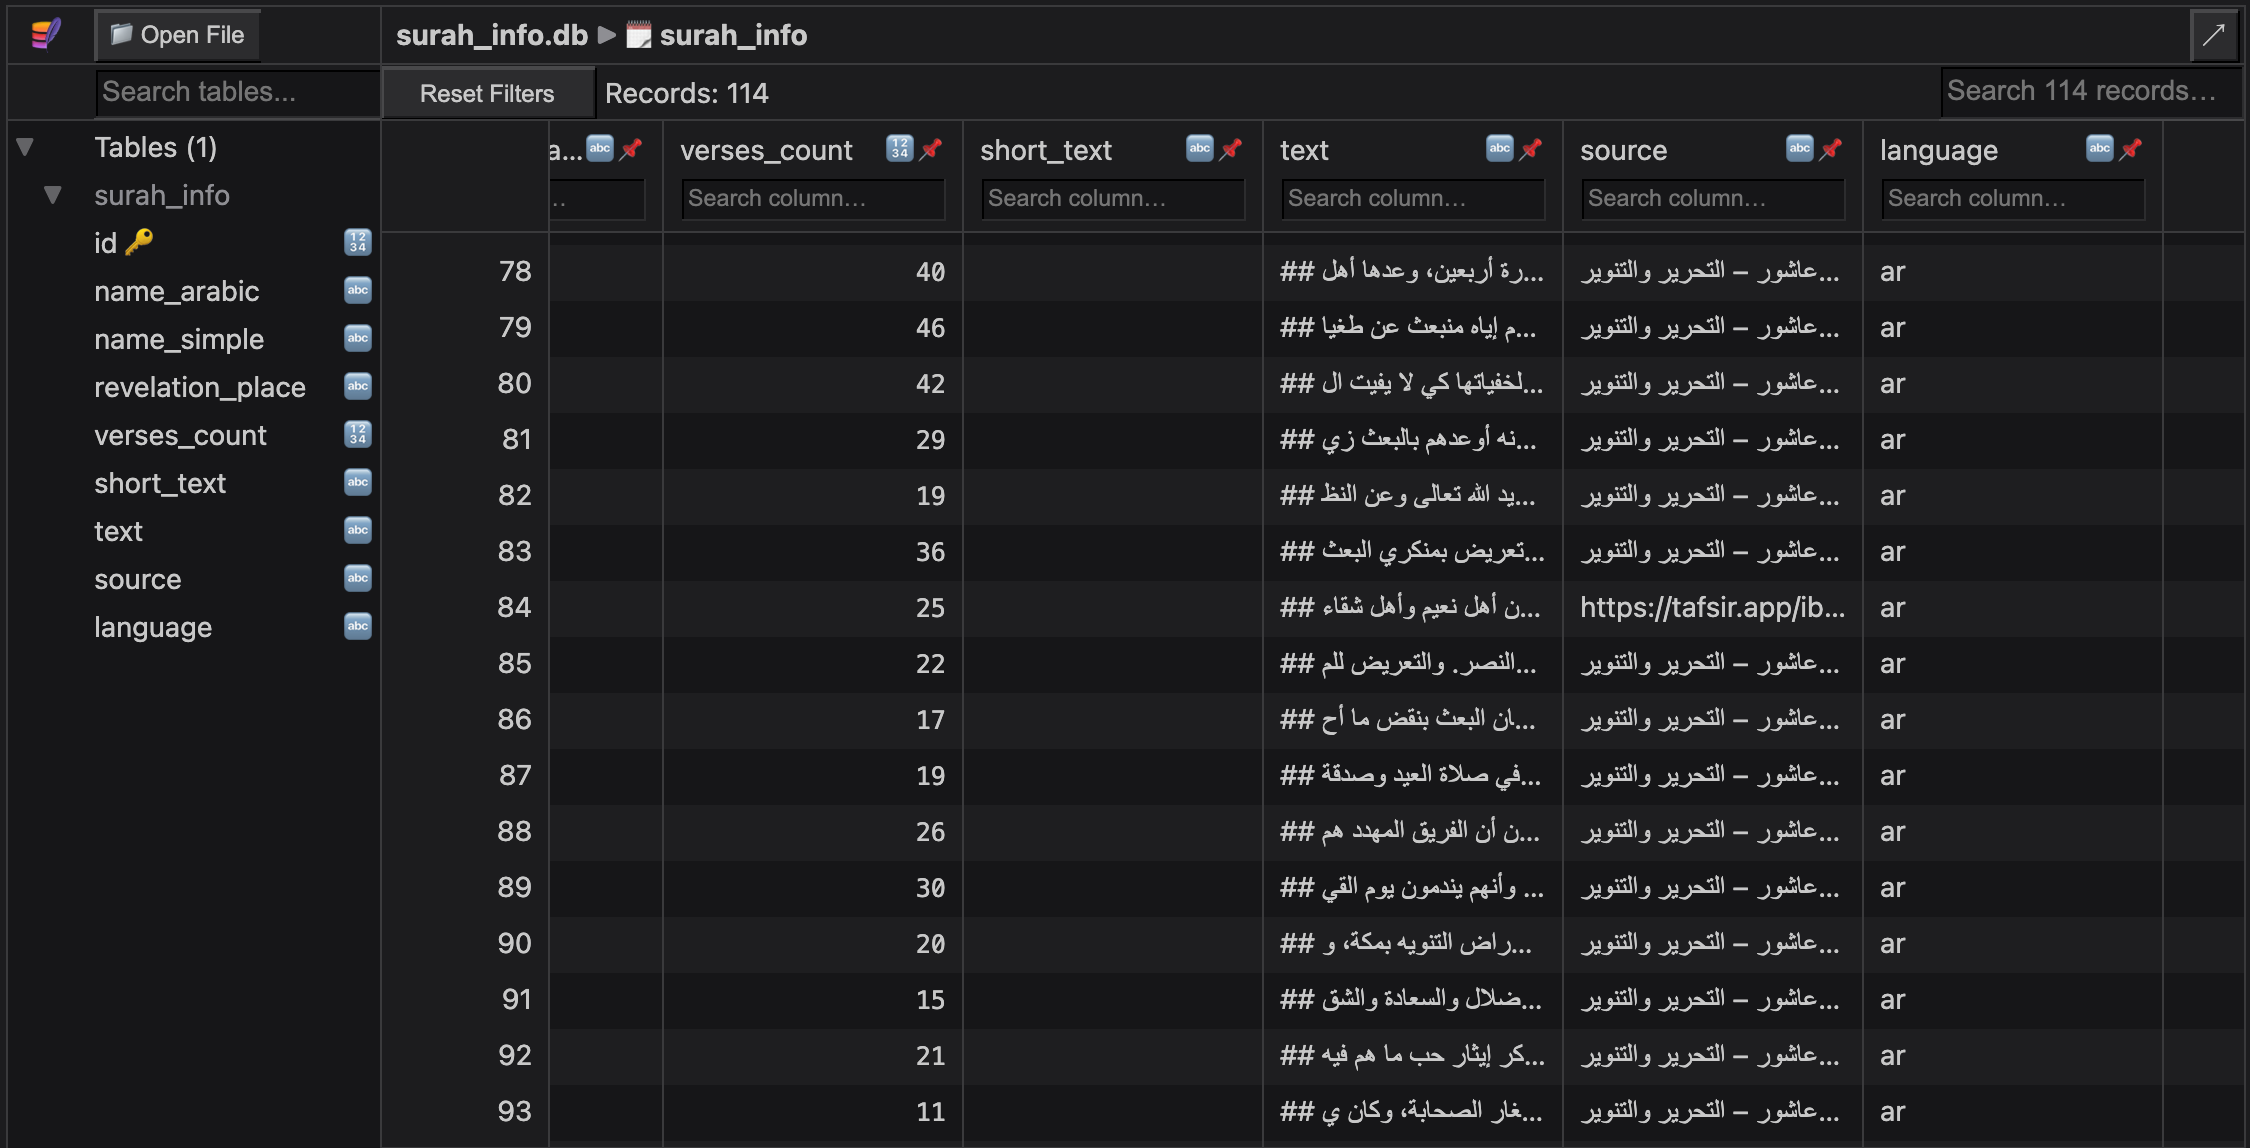
بعد الانتهاء من المعالجة والتنظيم، جهزت البيانات في قاعدة بيانات SQLite بصيغة .db.
وأصبح لكل سورة سجل مستقل يمكن الوصول إليه مباشرة من التطبيق، بدل أن تكون البيانات موزعة داخل الكود.
والنسخة الحالية تحتوي على السور الـ114، ويحتوي الحقل text على مقدمات السور المستخرجة من التحرير والتنوير، بالإضافة إلى البيانات الأخرى الموجودة في القاعدة مثل مكان النزول وعدد الآيات.
5. هل كان هناك Prompt واحد؟
لا، لم تكن العملية عبارة عن Prompt واحد أعطيته لـClaude ثم حصلت على النتيجة النهائية.
كانت عملية تكرارية، قسمت فيها العمل إلى مراحل:
استخراج → معالجة → تنظيم → مراجعة → اختبار → تعديل
ومن الأشياء التي ساعدتني فيها Claude Code أنه يستطيع كتابة السكربت وتشغيله، ثم مراجعة الناتج، واكتشاف المشاكل، وتعديل السكربت وإعادة تشغيله مرة أخرى.
وهذا كان أنسب بكثير من التعامل معه كنموذج محادثة فقط، لأن جزءًا كبيرًا من المهمة كان في الحقيقة أتمتة عملية استخراج ومعالجة البيانات.
6. النتيجة الحالية
بصراحة، النتيجة الحالية مرضية جدًا بالنسبة لي، خصوصًا أنها النسخة الأولى من العملية.
البيانات أصبحت منظمة وقابلة للاستخدام مباشرة، وكل سورة لها سجل مستقل، وقاعدة البيانات أصبحت منفصلة عن التطبيق ويمكن لأي مطور استخدامها.
لكن ما زال هناك مجال للتحسين، خصوصًا في تنسيق النص.
مثلًا بعض المقدمات تحتوي على أحاديث أو اقتباسات داخل النص، وأرى أن الأفضل في النسخ القادمة أن يتم تمييزها بشكل أوضح عن النص الأساسي، سواء بتنسيق مختلف أو باستخدام خط مخصص للأحاديث والاقتباسات، حتى تكون القراءة أسهل وأوضح.
كذلك ما زال هناك مجال لمزيد من التنظيف والمراجعة وتحسين بنية البيانات.
لكن من ناحية استخراج المحتوى من المصدر، وتنظيمه، وتحويله إلى قاعدة بيانات قابلة لإعادة الاستخدام، فالنتيجة الحالية بالنسبة لي جيدة جدًا.
وبعد أن وجدت اهتمامًا وطلبًا من الإخوة بمشاركة الملف، رأيت أنها فرصة طيبة للنفع العام، ولذلك شاركت النسخة الأولى من قاعدة البيانات بصيغة .db بدل أن تظل محصورة داخل «مناجاتك».
وأي مراجعة أو تدقيق من الإخوة المتخصصين ستكون مفيدة جدًا، وإن شاء الله أستفيد منها في تحسين النسخ القادمة.