«مسلم»: مساعدٌ صوتيٌّ عربي يعرض مصادره قبل أن يجيب
السلام عليكم ورحمة الله وبركاته،
أنا أخوكم يحيى النوساني، مطوّر ومصمّم «مسلم» — أوّل رفيقٍ صوتيٍّ عربيٍّ للمعرفة الإسلامية. سعدتُ جدًّا بلقاء عددٍ منكم في ملتقى إتقان بالقاهرة، ووعدتُكم حينها أن أكتب لكم هنا شرحًا وافيًا لما نبنيه، لا على سبيل التعريف بالمنتج، بل على سبيل مشاركة ما تعلّمناه بيننا كإخوةٍ نخدم هذا المجال — فأكثر ما في هذه الصفحة تفاصيلُ تقنية أتمنّى لو أنّ أحدًا كتبها لي قبل عامين.
«مسلم» رفيقٌ صوتيّ عربي: تسأل بصوتك، فيبحث في القرآن والتفسير والحديث، ثم يعرض لك من أين جاء الجواب قبل أن ينطق به. وهو يعمل الآن على muslim.yahyaelnawasany.com.
وحين يتلو لك آيةً، فلن تسمع صوتًا اصطناعيًّا مُركَّبًا — بل تسجيلًا حقيقيًّا بصوت قارئٍ مُجاز، تمامًا كما تُتلى في المساجد. القرآن عندنا محتوًى لا واجهة، فلا نُخضِعه لتقنيات تركيب الكلام بأيّ حال.
١. الرحلة: من أين بدأ «مسلم»
بدأت الرحلة منذ سنوات، وما زلتُ أدعو وأعمل على أن نُكمل مسيرة علمائنا في حفظ هذا الدين ونشره، والله هو الحافظ والموفِّق.
في خِضمّ هذا التقدّم العلميّ المتسارع، وأثناء عملي السابق في شركة Turing، وأنا يومئذٍ طالبٌ مُقبِلٌ على عامه الجامعيّ الأخير في كلّية الذكاء الاصطناعيّ بجامعة كفر الشيخ، كنتُ بعيدًا كلَّ البُعد عن المجال العربيّ والإسلاميّ. غير أنّ شغفي باللغة العربية وإيماني بها، وإدراكي لِقَدْرِ الأثر الذي يمكن أن يبقى فيها وفي خدمة هذا الدين، دفعاني إلى قرارٍ حاسم. فحين حان وقت التحضير لمشروع التخرّج — وقد تحتّم عليّ أن أُنفّذه وحدي، لتأخّري عن الالتحاق بالصفّ الجامعيّ في أوّله بسبب انغماسي في العمل — قرّرتُ أن يكون هذا المشروع في خدمة هذا الدين وهذه الأمّة التي لطالما كانت سبّاقة. فأين أمّتي اليوم؟
بدأتُ بفكرةٍ بسيطة: مساعدٌ صوتيّ إسلاميّ مختصٌّ بالعلوم الإسلامية. وكما ذكرتُ، كنتُ أبعدَ ما أكون عن مجال الذكاء الاصطناعيّ التوليديّ العربيّ، فرفعتُ شعاري الدائم: التعلّم المستمرّ لأجل الشيء الذي أريد بناءه. ولا أُخفيكم سرًّا، فكلُّ جزءٍ في «مسلم» هو حصيلةُ بحثٍ طويل ودوراتٍ تعليميةٍ في كلّ مكوِّنٍ أردتُ بناءه.
فكان عليّ أن أبدأ بالتعلّم أوّلًا لأقدر على بناء هذا المشروع الكبير. قسّمتُ العمل على نفسي، وفهمتُ الفكرة العامّة، ثمّ درستُ المساعد الصوتيّ ومكوِّناته واحدًا واحدًا: تعرُّف الكلام (STT)، ثمّ النموذج اللغويّ (LLM)، ثمّ تركيب الكلام (TTS). فصلتُ بينها ودرستُ كلًّا منها على حِدَة بدقّةٍ تامّة، وبالطبع في سياق التخصّص باللغة العربية. قارنتُ بين النماذج المتاحة، ونظرتُ فيما إذا كنتُ سأحتاج إلى ضبط أحدها (fine-tuning) أم لا، وبنيتُ لنفسي منهجًا واضحًا: أدرسُ كلَّ مكوِّنٍ وحده قبل أن أجمعها معًا.
وهذه فكرةٌ آمنتُ بها، وأراها أهمَّ ما خرجتُ به:
ليس كلُّ كبيرٍ صالحًا للمهمّة التي تريدها.
عليك أن تدرس المهمّة، وأن تدرس هدفك، وأن تنظر في خصائص كلّ مكوِّن — سواءٌ أكان نموذجًا أم خادمًا أم غيرهما. فربّما لا يتناسب نموذجٌ ضخمٌ مع غرضٍ صغيرٍ محدَّد، بل ربّما كان حجمه الكبير هو المعضلة نفسها. ليس عليك أن تفكّر مباشرةً في بناء أفضل وكيلٍ من أفضل نظام تعرُّفِ كلامٍ في العالم، وأفضلِ نموذجٍ لغويّ، وأفضلِ مركِّب كلام؛ فالأمور لا تسير هكذا. بل عليك أن تبحث وتدقّق في كلّ مكوِّن، وأن تضع هدفك أمامه بشكلٍ محدَّد.
٢. القاعدة التي بُني عليها كلُّ شيء: المصدرُ يسبق الدعوى
القرار الأوّل لم يكن تقنيًّا. كان هذا:
جوابٌ بلا مصدرٍ هو الإخفاق الوحيد الحقيقيّ في هذا النظام.
وكلُّ ما بعده تفريعٌ على هذه الجملة. فالنموذج اللغويّ لا يُسأل عن تفسير آيةٍ ولا عن متن حديث؛ إنّما يُسأل عن الصياغة فقط، والمعرفة تأتيه مُسترجَعةً من مصدرٍ يمكن للمستخدم أن يفتحه بنفسه.
ولأنّ القاعدة ليست شعارًا، فقد فُرِضت في الواجهة أيضًا: رقائق المصادر (source chips) تظهر على الشاشة قبل أن يبدأ نصُّ الجواب، وقبل أن يبدأ الصوت. ولا تُتخطّى هذه الخطوة ولو عاد الجواب من الذاكرة المؤقّتة في جزءٍ من الثانية. فإن كان النظام قد نظر في كتاب، فعليه أن يقول ذلك.
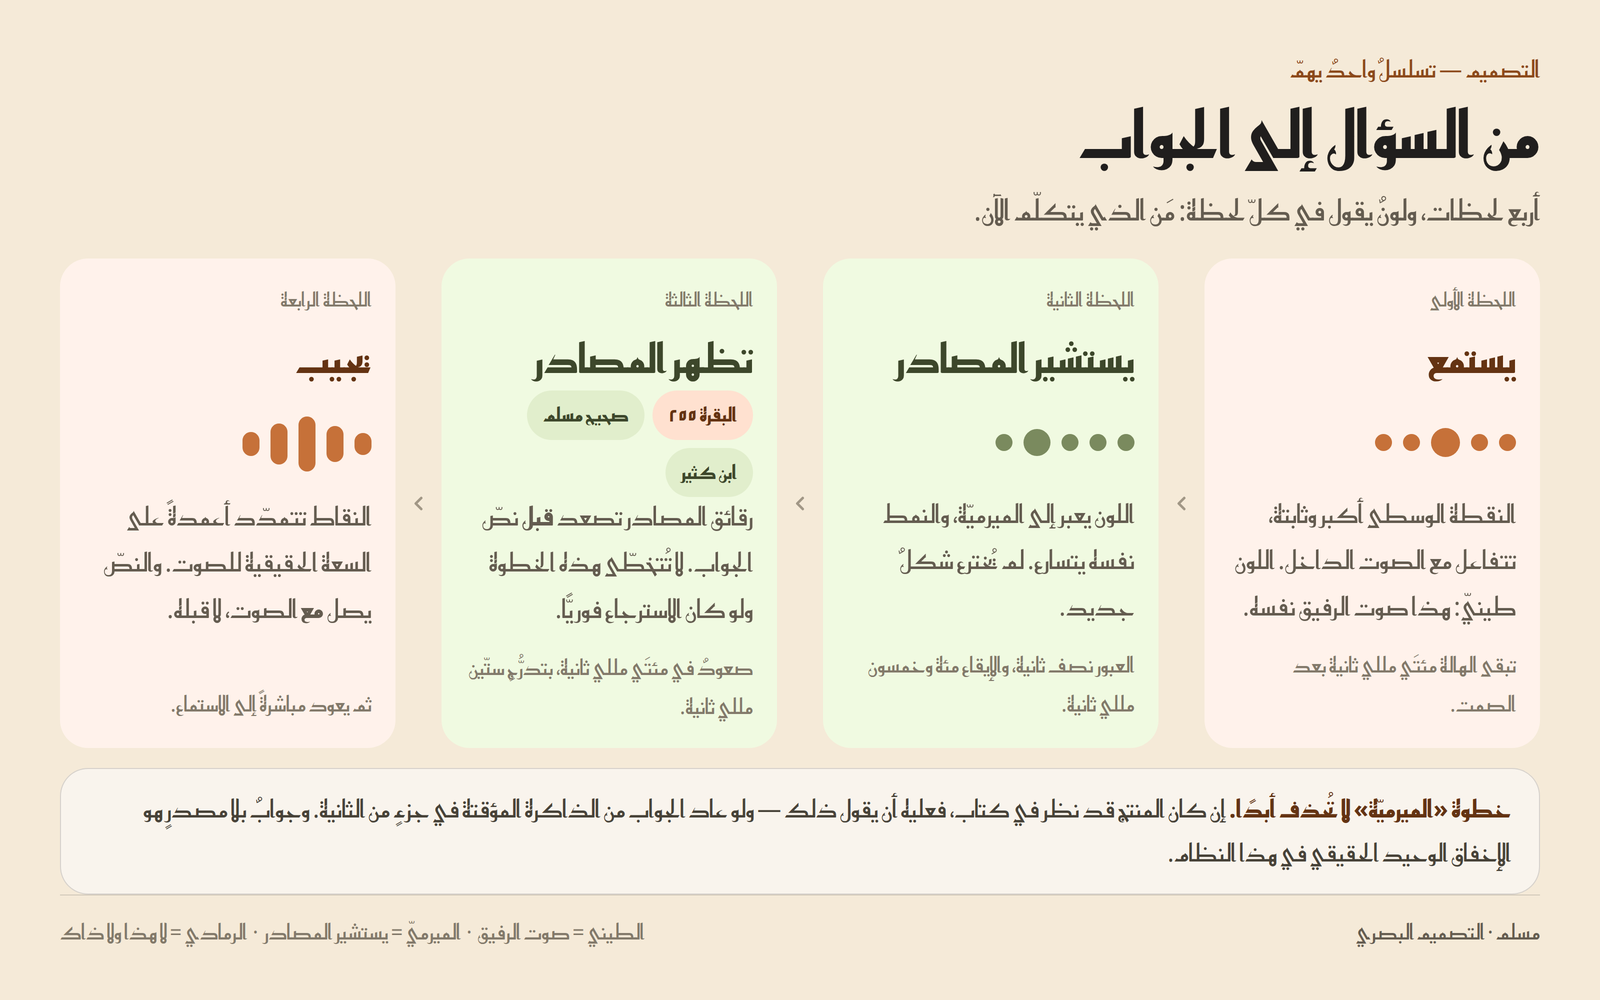
واللون في هذا النظام معنًى لا زينة: الطينيّ (terracotta) صوتُ الرفيق نفسه، والميرميّ (sage) يعني «أنا الآن أنظر في المصادر». فالمستخدم يعرف من اللون وحده مَن الذي يتكلّم، دون أن يقرأ كلمة.
٣. المعمارية: ثلاث طبقات، وكيف اختير كلُّ جزء
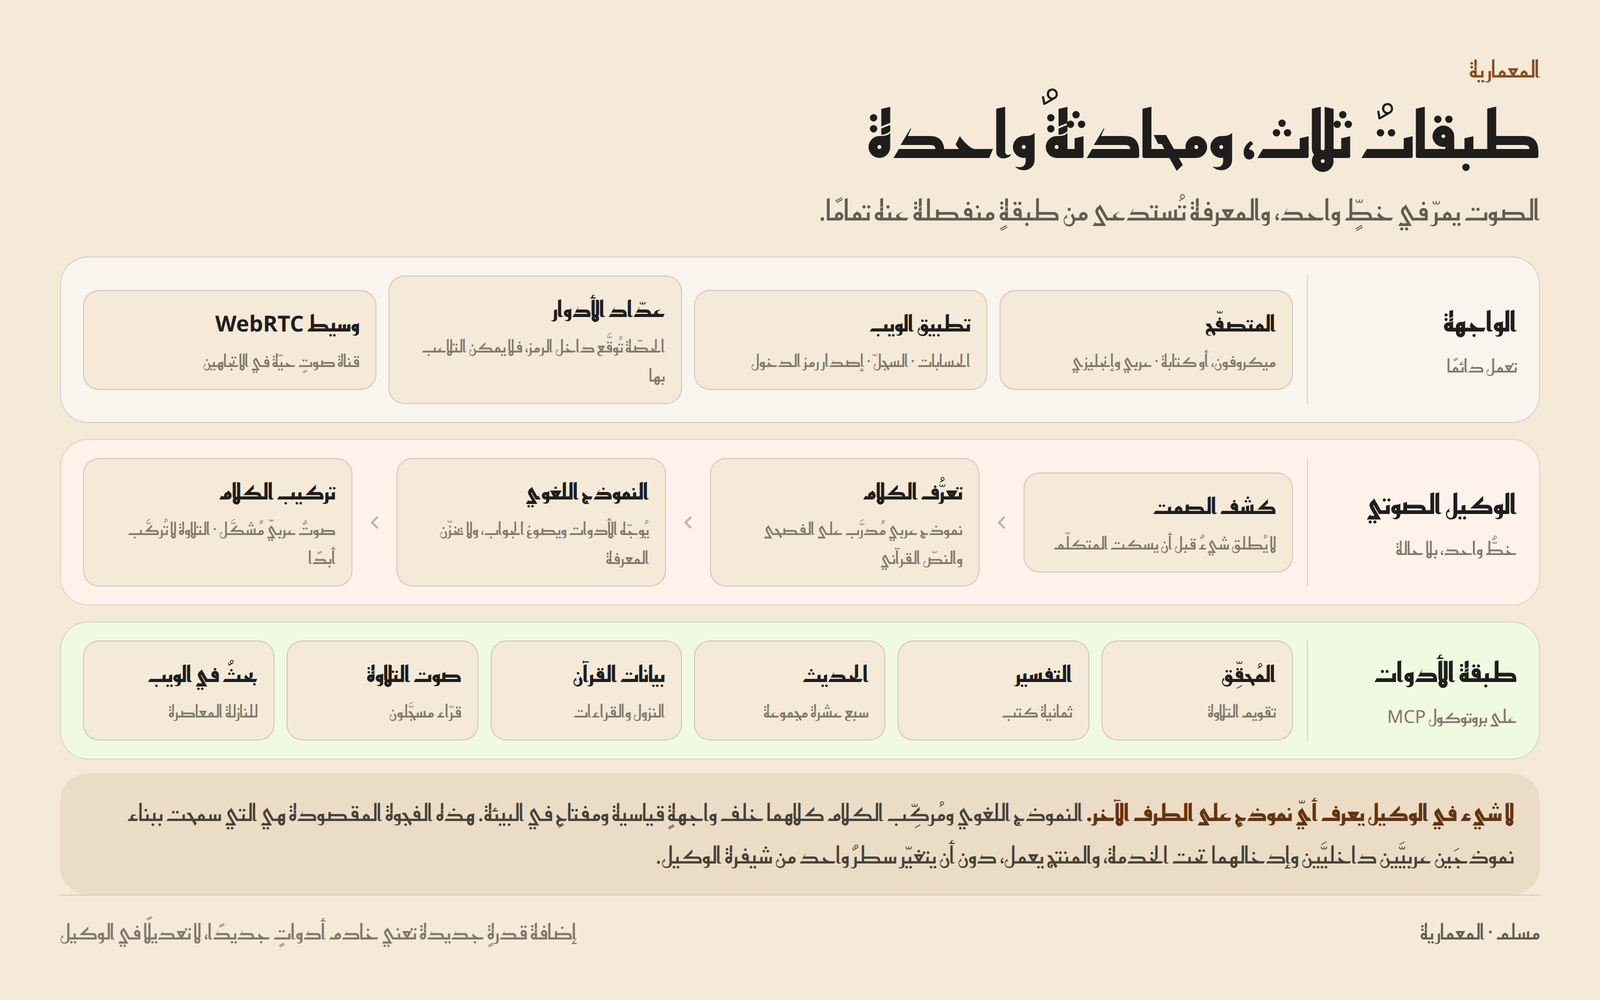
الصوت يمرّ في خطٍّ واحد: كشف الصمت (VAD) ← تعرُّف الكلام (STT) ← النموذج اللغويّ ← تركيب الكلام (TTS)، والمعرفة تُستدعى من طبقةٍ منفصلةٍ عنه تمامًا.
أهمّ قرارٍ معماريٍّ اتّخذناه — وأنصح به كلَّ من يبني شيئًا كهذا:
النموذج اللغويّ ومركِّب الكلام كلاهما خلف واجهةٍ قياسيةٍ ومفتاحٍ في البيئة، ولا شيء في الوكيل يعرف أيَّ نموذجٍ على الطرف الآخر.
فالنموذج اللغويّ يُخاطَب عبر واجهةٍ متوافقةٍ مع OpenAI (chat/completions)، ومركِّب الكلام عبر HTTP بسيط. وهذه الفجوة المقصودة هي التي سمحت لنا ببناء نموذجَين عربيَّين داخليَّين وإدخالهما تحت الخدمة والمنتج يعمل، دون أن يتغيّر سطرٌ واحدٌ من شيفرة الوكيل. ولو كان النموذج مكتوبًا داخل الكود لكانت كلُّ تجربةٍ تعني إعادة نشر.
أ. تعرُّف الكلام: الاختيار من الهدف لا من الشُّهرة
يُعدّ Whisper من أفضل نماذج تعرُّف الكلام التي وُجدت، لكنّني حين نظرتُ إليه من زاويتي وجدتُ أنّني أحتاج نموذجًا مُدرَّبًا تدريبًا خاصًّا على النصّ القرآنيّ وعلى العربية بلهجاتها، وأحتاجه سريعًا في الوقت نفسه. لذلك وقع اختياري على معمارية FastConformer من NVIDIA، ثمّ على نموذج NeMo Arabic STT المنشور عليها، وأضفنا فوقه CATT لاستعادة التشكيل.
فالاختيار لم يأتِ من فراغ، ولا لأنّه «أفضلُ نموذجٍ موجود»، بل جاء من هدفي ومن حاجتي المحدَّدة.
ب. النموذج اللغويّ: لماذا اخترتُ الصغير المُدرَّب لا الضخم الجاهز
كنتُ في البداية مقتنعًا بما يقتنع به كثيرون: أنّ النموذج ذا الثلاثمئة مليار مُعامِلٍ هو الأفضل لأداء مهمّتك. لكنّني بعد بحثٍ ووقتٍ طويلٍ من التجربة اقتنعتُ بغير ذلك.
فالوكيل هنا مساعدٌ صوتيّ، نعم، ويحتاج إلى تدقيقٍ في الكلام، لكنّ هذا الكلام يأتي بمصدرٍ حتمًا. فلستُ أريد أن يكون النموذج اللغويّ هو الأفضل، بل أريد أن يكون المصدرُ ورَبْطُه (mapping) هو الأفضل. أمّا النموذج اللغويّ فأحتاجه لأمرٍ واحد: أن يُرتّب الكلام الذي يُخرِجه بناءً على المصدر الذي أعطيتُه إيّاه من البداية — وقد زوّدتُه بالسياق كاملًا ودرّبتُه عليه، فصارت له به معرفة. لذلك غيّرتُ وجهتي من نموذجٍ لغويٍّ ضخمٍ إلى نموذجٍ صغيرٍ مضبوطٍ بدقّة.
وفي هذه المرحلة اقتنعتُ بفكرةٍ حاسمة: عليّ أن أُدرِّب نموذجي بنفسي. فوقع الاختيار على ضبط نموذج Karnak (ستّة مليارات مُعامِل) على البيانات التي أعددتُها.
وكانت كيفيّة التدريب من أهمّ الأمور. فبسبب ضيق الموارد بعد مغادرتي Turing، اضطررتُ إلى التدريب على وحدات معالجةٍ رسوميّةٍ مستأجَرة، فاستعملتُ كثيرًا من الخوادم المتاحة حول العالم ودفعتُ فيها الكثير. درّبتُ النموذج بطريقة QLoRA على بياناتٍ موجَّهةٍ لهذا الوكيل تحديدًا: بياناتٍ إسلامية، واستدعاءِ الأدوات (tool calling) — إذ لاحظتُ ضعف النموذج الأصليّ فيه — ونبرةِ الخطاب التي أريد أن يخرج بها الكلام. وبعد أسابيع من عملٍ مُضنٍ، أخرجتُ بحمد الله Muslim-6B-PRO، وهو منشورٌ الآن على Hugging Face مفتوحَ المصدر بالكامل، بل يمكنكم الاطّلاع بتفصيلٍ أدقّ على كيفيّة تدريبه وعلى بياناته كاملةً.
ج. تركيب الكلام: من واجهةٍ جاهزة إلى نموذجٍ نملكه
هنا كانت أكبر معضلةٍ واجهتُها. فلكي يشعر المستخدم أنّه يتحدّث إلى إنسانٍ حقيقيّ، احتجتُ إلى أمرين: صوتٍ قريبٍ من الصوت البشريّ في دقّته، وزمنِ استجابةٍ أقلَّ ما يمكن. بحثتُ طويلًا في النماذج المتاحة يومَها وجرّبتُ كثيرًا منها، فلم أجد نموذجًا مفتوح المصدر يفي بما أريد. فخلصتُ — كما يخلص كثيرون في بلادنا — إلى استعمال واجهةٍ برمجيةٍ جاهزة، ووقع الاختيار على ElevenLabs.
ظلّ الأمر كذلك حتّى أطلقتُ النسخة التجريبية في شهر مايو. وبعد ثلاثة أشهرٍ من جمع بيانات المستخدمين منها، تبيّن لي أمرٌ في غاية الأهمّية: عليّ أن أُدرِّب نموذج تركيب الكلام الخاصّ بي. وما تزال هذه في نظري أهمَّ خطوةٍ خطوتُها، لأنّها لم تبنِ صوتًا عربيًّا دقيقًا فحسب، بل أثمرت نموذجًا يُعَدّ اليوم من أفضل نماذج تركيب الكلام العربيّ مفتوحة المصدر.
وأصدُقُكم القول: هذا النموذج ينطق بالفصحى وحدها، فقد دُرِّب عليها بالكامل. وكان هدفي من ذلك واضحًا؛ فقد كان بوسعي أن أُدرِّبه على اللهجات جميعًا كما فعلتُ مع تعرُّف الكلام، لكنّني كنتُ واضحًا في غايتي: أريد للمستخدم أن يسمع العربية الفصحى. فالذي يجمعنا نحن المسلمين هو القرآن، والقرآن عربيّةٌ فصحى. فلك أن تُحدِّث «مسلم» بأيّ لهجةٍ شئت، أمّا حين تسمع الجواب فستسمعه بلسان الفصحى.
وأُحبّ أن أذكر أمرًا شخصيًّا: لطالما عملتُ في شركاتٍ أجنبيةٍ كثيرة وتواصلتُ مع فرقٍ غربية، لكنّ الذي يزيد حنيني إلى هذه اللغة هو ثِقَلُها؛ فأنا حين أتحدّث الإنجليزية أو الألمانية لا أشعر بنفسي كما أشعر بها حين أتحدّث العربية. أنا مُغرَمٌ بهذه اللغة بكلّ تفاصيلها.
ولن أُطيل في تفاصيل تدريب فصيح — وهو نموذج تركيب الكلام الخاصّ بنا — فهي تستحقّ موضوعًا مستقلًّا أعِدُكم به، وسأُرفق روابطه أدناه. وأُنبّه هنا إلى أنّ هذا كلَّه لصوت الرفيق نفسه، لا لتلاوة القرآن؛ فالقرآن لا يُركَّب صوته أبدًا.
د. الطبقة التي تربط المكوِّنات
بعد اكتمال المكوِّنات الثلاثة، احتجتُ إلى ما يربط بينها ويُديرها. بحثتُ في ذلك ودقّقت، ووجدتُ أنّ Google تُوفّر حلًّا وكذلك xAI، لكنّني حين اطّلعتُ على دورة LiveKit على DeepLearning.ai أدركتُ أنّها الأنسب لمهمّتي وهدفي، خصوصًا حين وجدتُ أنّ LiveKit خادمٌ حيٌّ مفتوح المصدر — وهذا شعاري: المفتوح المصدر هو الغالب في النهاية. فاخترتُه لإدارة الجلسات واختبرتُه كثيرًا، ثمّ حرصتُ على استقلال المنتج تمامًا، فعزلتُه عن واجهتهم السحابية وواجهتهم البرمجية، وشغّلتُ خادم LiveKit محلّيًّا عندنا.
ولم يكن استعماله كما هو كافيًا؛ فقد أدخلتُ عليه تعديلاتٍ كبيرة، وأضفتُ طبقاتٍ كثيرة وحذفتُ أخرى.
وهذا هو الجوهر: ألّا تأخذ الشيء كما هو، بل تُفكّكه جزءًا جزءًا، فتأخذ ما ينفعك وتترك ما لا ينفعك، حتّى لا يُبطّئ تجربةَ المستخدم.
٤. طبقة الأدوات على MCP: القدرةُ الجديدة لا تمسّ الوكيل
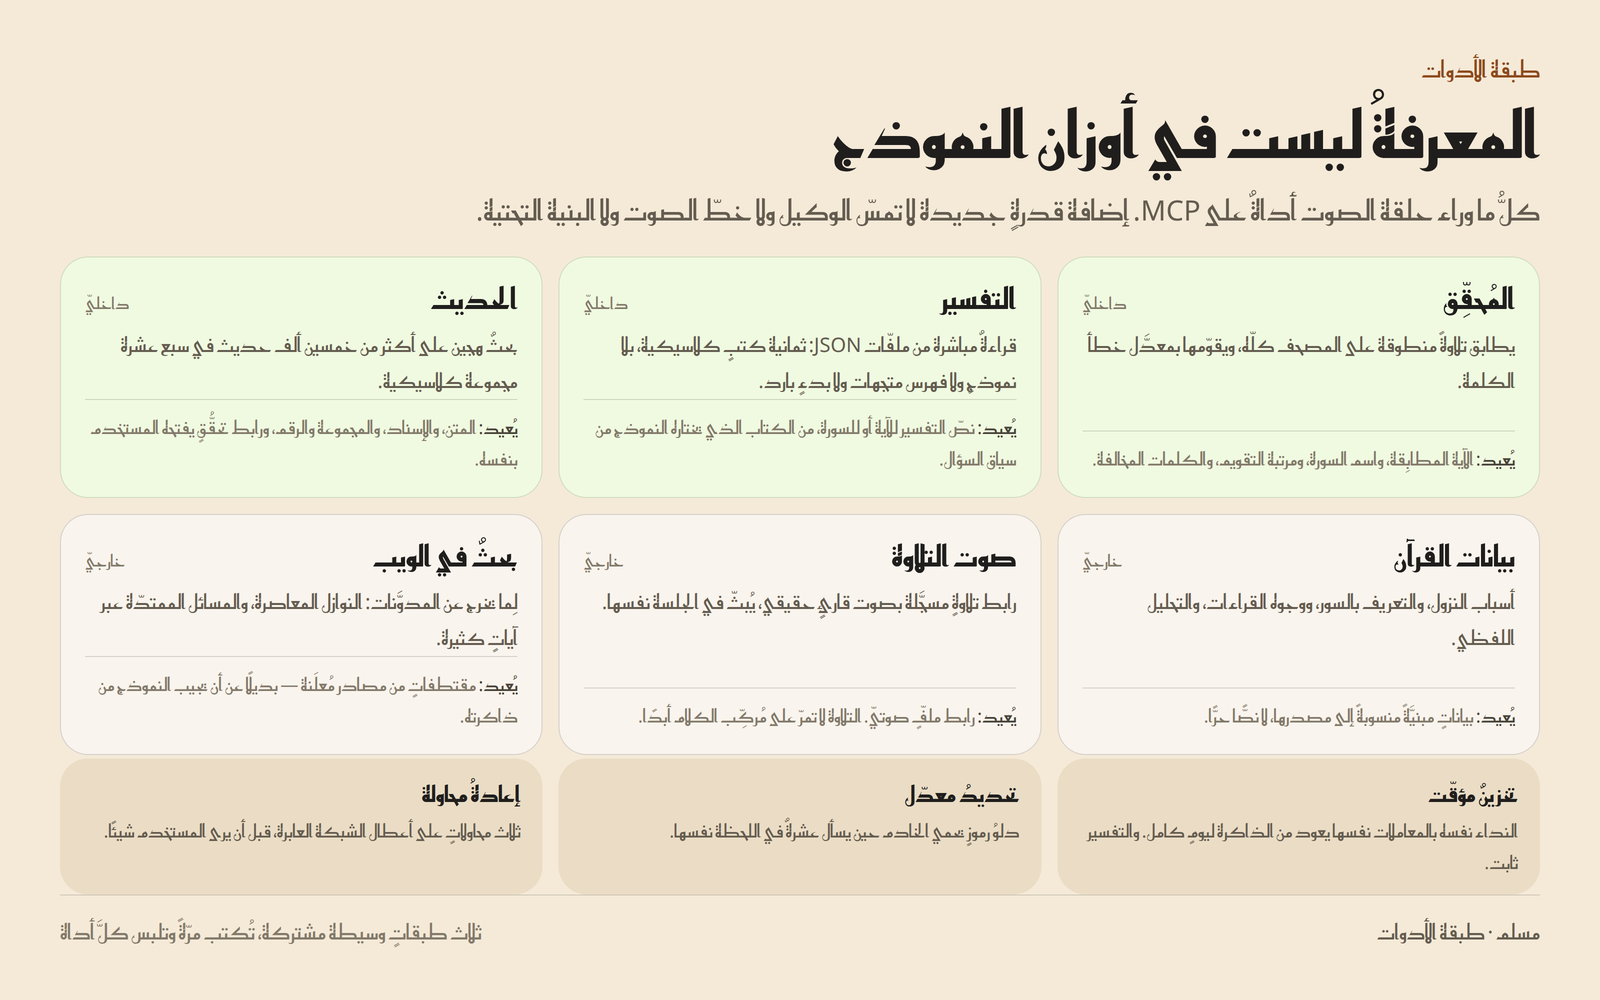
كلُّ ما وراء حلقة الصوت أداةٌ على بروتوكول MCP (Model Context Protocol). ستّة خوادم أدوات: التحقّق من التلاوة، والتفسير، والحديث، وبيانات القرآن، وصوت التلاوة، والبحث في الويب. وإضافةُ قدرةٍ جديدة تعني خادم أدواتٍ جديدًا فقط — لا تعديل في الوكيل، ولا في خطّ الصوت، ولا في البنية التحتية.
وأودّ أن أقف هنا وقفة: التولز وخوادم MCP والاسترجاع ليست عندي مكوِّنًا هامشيًّا، بل هي جزءٌ رئيسيّ من الوكيل، بل لعلّها أهمُّ أجزائه. لذلك بدأتُ بترتيب مصادري ترتيبًا موثوقًا تامًّا، وأعتمد فيها على أربعة أصول: التفاسير، والحديث، والقراءات والتلاوة، والبيان الشرعيّ.
من «الفتوى» إلى «البيان»
الفتوى ليست أمرًا هيّنًا، ولا يصحّ أن تُؤخذ وتُنشر على أنّها الحكم التامّ؛ فالفتاوى تتغيّر بتغيّر الحال والمكان والزمان، وهذا ممّا لا نقاش فيه. ولستُ مُفتيًا، ولا أرى أنّ أيّ نموذجٍ أو وكيلٍ — مهما بلغ — يقدر اليوم على الإفتاء في ديننا؛ وهذا أمرٌ لا جدال فيه عندي.
لذلك حوّلتُ المسار من فتوى إلى بيان: أن يستبين السائل أمرًا من أمور دينه، فيأتيه الجواب بمصدرٍ موثَّقٍ مرتَّبٍ يُعرَض له كاملًا: مَن قاله، وفي أيّ موضعٍ قاله، وفي أيّ حالٍ قِيل. وهذا بابٌ أتعامل معه بأشدّ ما يكون من التحرّي، والعمل فيه ماضٍ على هذا الأساس وحده.
الطبقات الوسيطة
نستعمل FastMCP، بنقل SSE للخوادم المحلّية وstreamable-http للبعيدة. وأنفعُ ما فعلناه ثلاثُ طبقاتٍ وسيطة (middleware) تُكتب مرّةً وتُلبَس لكلّ أداة:
mcp = FastMCP("server-name")
mcp.add_middleware(ResponseCachingMiddleware( # التفسير لا يتغيّر — خزّنه ليومٍ كامل
call_tool_settings=CallToolSettings(ttl=86400)))
mcp.add_middleware(RateLimitingMiddleware( # دلو رموزٍ يحمي الخادم من الذروة
max_requests_per_second=15.0, burst_capacity=30))
mcp.add_middleware(RetryMiddleware( # أعطال الشبكة العابرة لا يراها المستخدم
max_retries=3, retry_exceptions=(ConnectionError, TimeoutError, OSError)))
ملاحظة عملية: التفسير عندنا ليس RAG أصلًا. فالنموذج يعرف رقم السورة والآية، والأداة تقرأ ملفّ JSON مباشرةً:
data/tafsir_api/tafsir/{كتاب}/{سورة}/{آية}.json → { "text": "...", "ayah": 255, "surah": 2 }
والنتيجة: دقّةٌ تامّة على المرجع المباشر، وزمنٌ دون المللي ثانية، وصفرُ اعتمادياتٍ على التعلّم الآليّ، ولا بدءٌ بارد. ثمانية كتبٍ كلاسيكية بهذه الطريقة (الميسّر، والسعدي، وابن كثير، والوسيط، والبغوي، والقرطبي، وتنوير المقباس، والطبري). فقبل أن تبني فهرس متّجهاتٍ لسؤالٍ له إجابةٌ حتميّة، اسأل نفسك: هل هذا استرجاعٌ أم مجرّد بحثٍ عن مفتاح؟
٥. دراسة حالة: التحقّق من التلاوة — لماذا أخرجنا النموذج اللغويّ من المسار كلّه
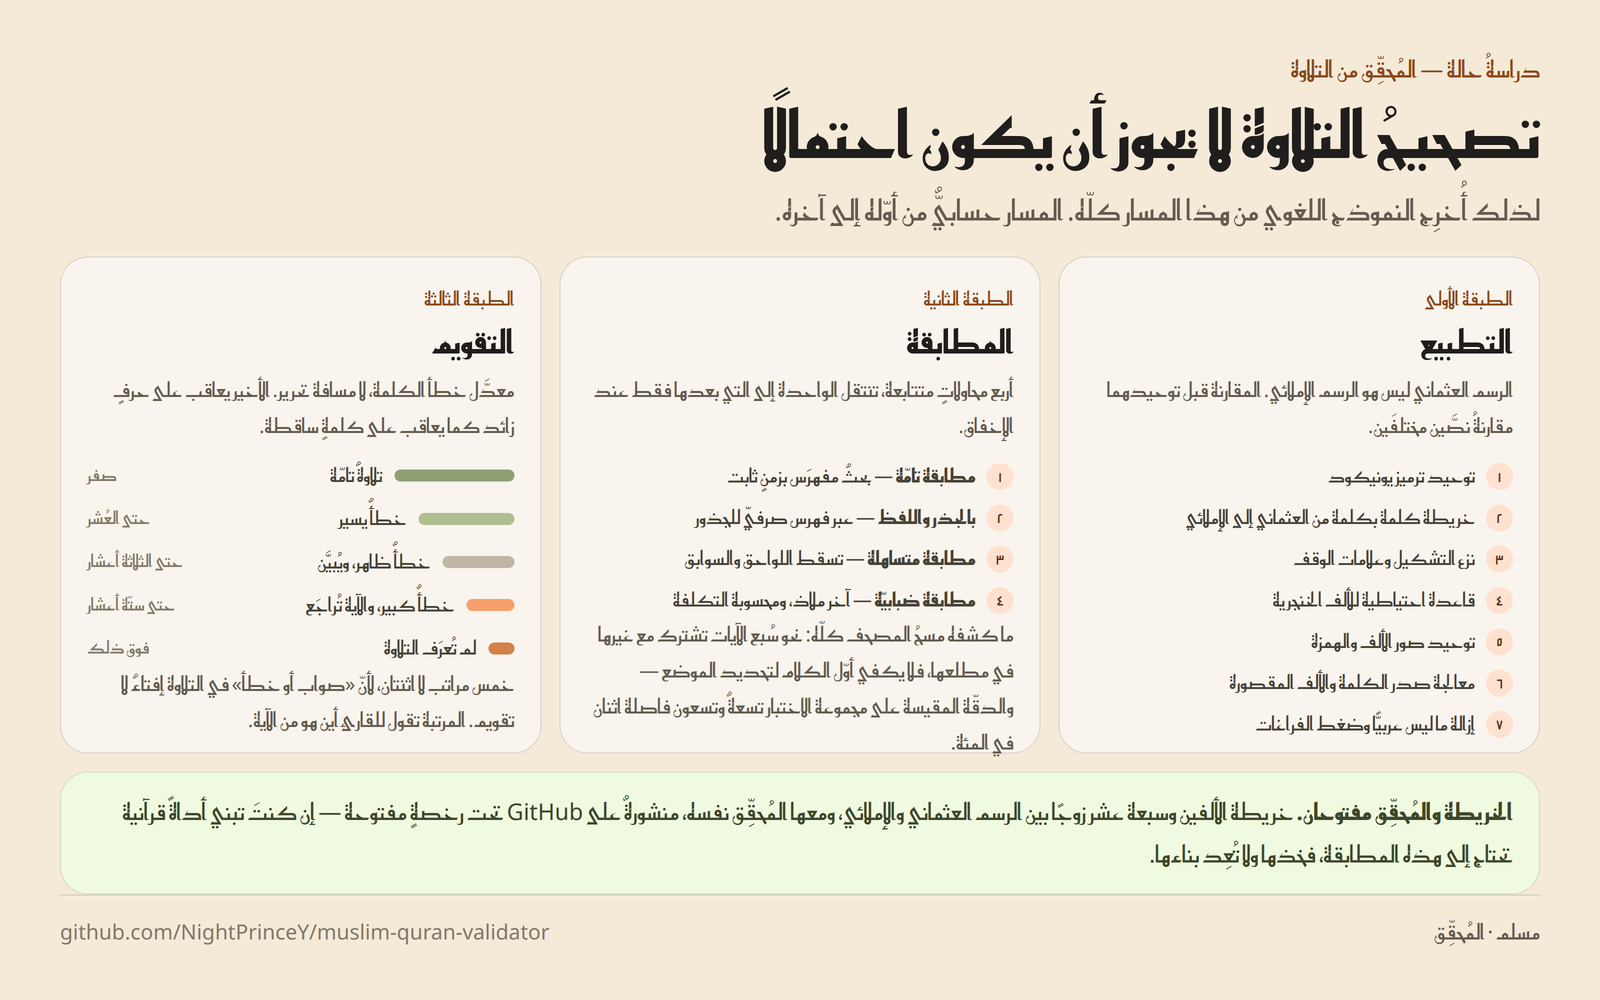
هذه أكثر قطعةٍ استغرقت وقتًا، وأكثر ما أرجو أن ينفعكم فيها.
المستخدم يتلو، والنظام يقول له: أين أخطأت. وتصحيح التلاوة لا يجوز أن يكون احتمالًا، فلا موضعَ لنموذجٍ لغويٍّ في هذا المسار. المسار حسابيٌّ من أوّله إلى آخره، ويعمل على مستوى الكلمة على مخرَج تعرُّف الكلام بالاعتماد على المحاذاة (alignment)؛ وهو اختيارٌ مقصود، لأنّ الحكم على مستوى الكلمة قاطعٌ يمكن التحقّق منه، وهو ما يليق بالتلاوة.
أ. الرسم العثماني ليس هو الرسم الإملائي
هذه أوّل صخرة. أنت تقارن مخرَج نظام تعرُّف الكلام (رسمٌ إملائيّ) بنصّ المصحف (رسمٌ عثمانيّ). والمقارنة قبل التوحيد مقارنةُ نصَّين مختلفَين، لا نصٍّ صحيحٍ بخطأ.
فبنينا مطبِّعًا (normalizer) من سبع خطوات، محورُه خريطةٌ كلمةً بكلمة فيها ٢٠١٧ زوجًا بين الرسمَين، مُستخرَجةٌ بمحاذاة المصحف كلِّه:
- توحيد ترميز يونيكود (NFC)
- البحث في خريطة العثماني ← الإملائي على مستوى الكلمة
- نزع التشكيل وعلامات الوقف
- قاعدة احتياطية للألف الخنجرية (U+0670)
- توحيد صور الألف والهمزة
- معالجة صدر الكلمة والألف المقصورة
- إزالة ما ليس عربيًّا وضغط الفراغات
ولماذا خريطةُ كلماتٍ لا قاعدةٌ عامّة؟ لأنّ القواعد العامّة للألف الخنجرية تُخطئ في حالاتٍ معروفة. فالخريطة تحسم هذه الحالات نصًّا، وتبقى القاعدة احتياطًا لما خرج عنها. والخريطة منشورة، فخذوها ولا تُعيدوا بناءها.
ب. مطالع الآيات المشتركة
هذه مفاجأةٌ لم نتوقّعها: مسحنا المصحف كلَّه فوجدنا أنّ نحو سُبع الآيات تشترك مع غيرها في مطلعها. فلا يكفي أوّل الكلام لتحديد الموضع، ولا بدّ من مطابقةٍ متدرّجةٍ على أربع طبقات: تامّة ← بالجذر واللفظ ← متساهلة ← ضبابيّة، تنتقل الواحدة إلى التي بعدها فقط عند الإخفاق، لأنّ الضبابيّة مُكلِفة.
ج. معدَّل خطأ الكلمة (WER)، لا مسافةُ تحرير
هذه من أنفع النصائح: مسافة ليفنشتاين (Levenshtein) خاطئةٌ لهذا الغرض، لأنّها تعاقب على حرفٍ زائدٍ كما تعاقب على كلمةٍ ساقطة، والقارئ لا يخطئ بالحروف بل بالكلمات. فاستعملنا WER، وصنّفنا النتيجة في خمس مراتب لا اثنتين:
- صفر — تلاوةٌ تامّة
- حتى العُشر — خطأٌ يسير
- حتى الثلاثة أعشار — خطأٌ ظاهر، ويُبيَّن
- حتى ستّة أعشار — خطأٌ كبير، والآية تُراجَع
- فوق ذلك — لم تُعرَف التلاوة
خمسٌ لا اثنتان، لأنّ «صواب أو خطأ» في التلاوة إفتاءٌ لا تقويم. فالمرتبة تقول للقارئ أين هو من الآية، ولا تصدر عليه حكمًا.
والدقّة المقيسة: ٩٩٫٢٪ على مجموعة اختبارٍ من ١٢٤ حالة في اثنتي عشرة فئة.
٦. العربية ليست إضافةً لاحقة
اخترنا كلَّ مكوِّنٍ لأنّه يُحسن العربية، لا لأنّه مشهور.
- التلاوة لا تُركَّب أبدًا. حين يطلب المستخدم آيةً مُتلوَّة، نبثّ تسجيلًا حقيقيًّا لقارئٍ مُجاز، ويُذكر اسمه. فالقرآن محتوًى لا واجهةَ استخدام؛ ولا يُستعمل صوتُ تلاوةٍ نغمةَ تنبيه، ولا أذانٌ نغمةَ مُنبِّه.
- الأرقام تتبع لغة الواجهة: أرقامٌ عربية-هندية في العربية (٤ مصادر)، وغربيةٌ في الإنجليزية. وأرقامُ الآيات والأحاديث كذلك — فالاقتباس نصٌّ لا كود.
- التشكيل يحتاج فراغًا: ارتفاع السطر لا يقلّ عن ١٫٨٥ لنصّ الواجهة العربيّ، و٢٫١٥ للنصّ المشكول. فالعربية المزحومة تُقرأ كأنّها استخفافٌ باللغة.
- الخطّ: خطُّ المصحف منفصلٌ عن خطّ الواجهة (Amiri للنصّ الشرعيّ وحده، ولا يُستعمل على زرٍّ أبدًا).
- التخطيط يُؤلَّف RTL ثم يُعكس إلى الإنجليزية، لا العكس، وباستعمال الخصائص المنطقية (
padding-inline-start) لا left/right.
فخٌّ عمليّ كلّفنا وقتًا — ثنائيّة الاتجاه (bidi) تُفسد الأرقام
الأرقام العربية-الهندية يُعاد ترتيبها حين تجاورها محارفُ محايدةٌ مثل + أو الشرطة. كتبنا ٥٠٬٠٠٠+ فظهرت رقمًا آخر تمامًا في الصورة المُصدَّرة. والحلّ: اكتبها كلمات («أكثر من خمسين ألفًا»)، أو اعزلها بـ <bdi>. ولا تثق بسلسلة المصدر — اقرأ الناتج المرئيّ مُكبَّرًا.
٧. الأرقام، كما قِيست
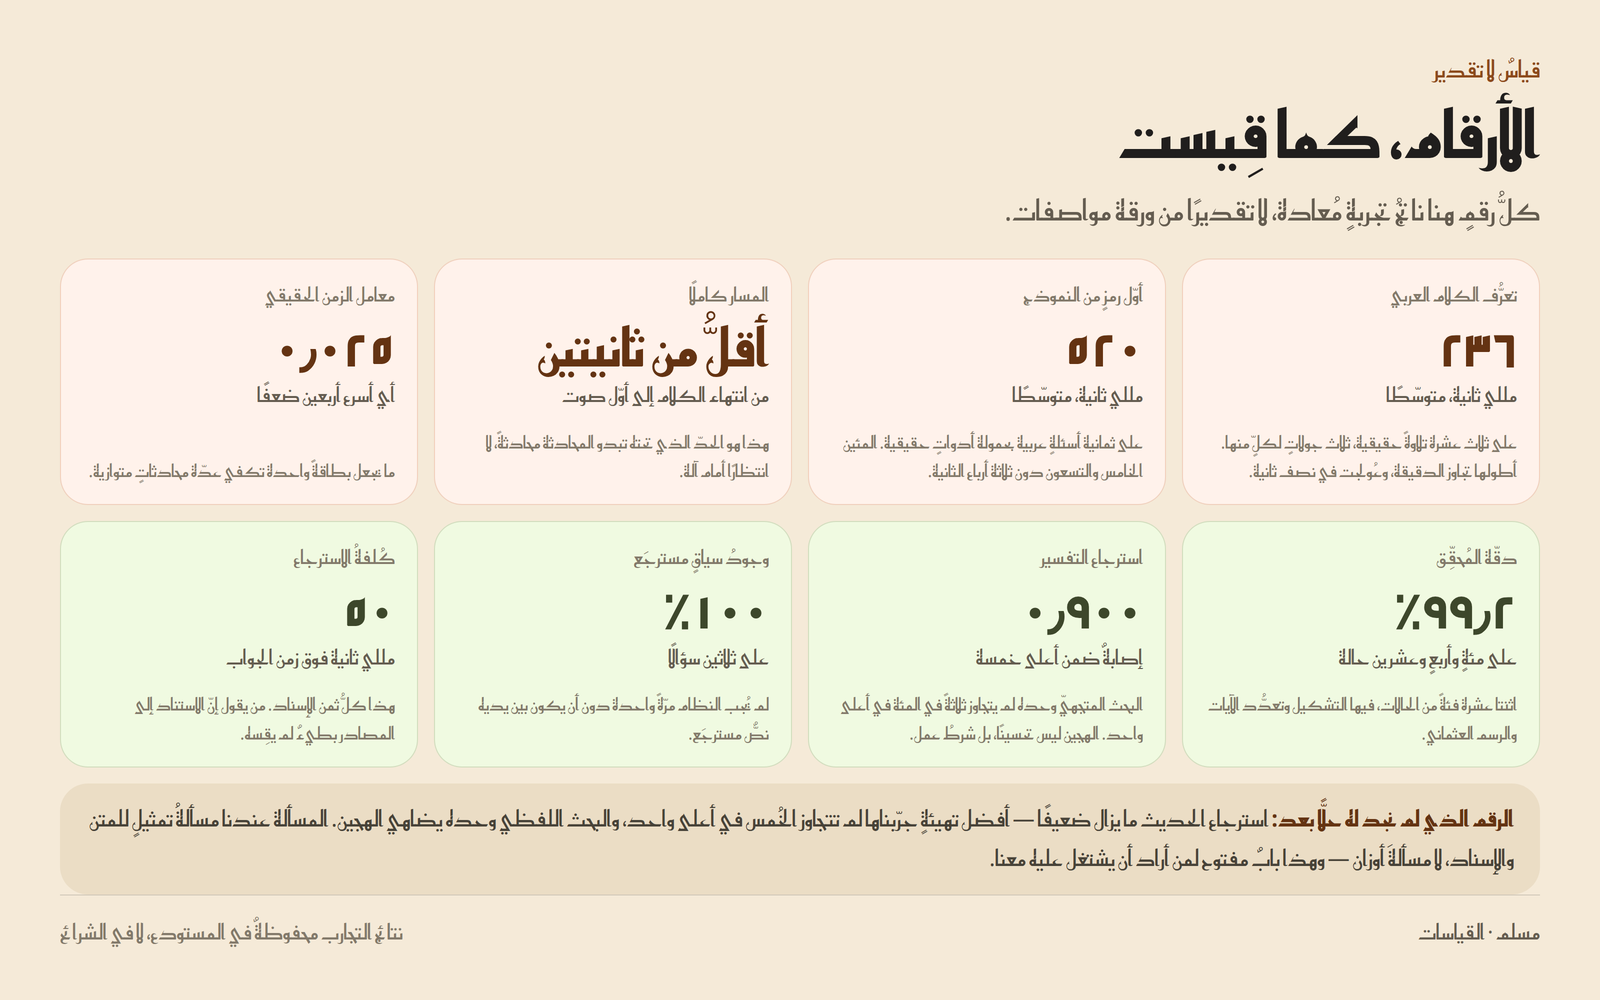
كلُّ رقمٍ هنا ناتجُ تجربةٍ مُعادة، لا تقديرًا من ورقة مواصفات:
- تعرُّف الكلام: متوسّط ٢٣٦ مللي ثانية، ومعامل زمنٍ حقيقيّ ٠٫٠٢٥ (أسرع أربعين ضعفًا من الزمن الحقيقيّ). قيست على ثلاث عشرة تلاوةً حقيقية، بثلاث جولاتٍ لكلٍّ منها.
- أوّل رمزٍ من النموذج: متوسّط ٥٢٠ مللي ثانية، والمئين الخامس والتسعون دون ثلاثة أرباع الثانية.
- المسار كاملًا: أقلُّ من ثانيتين من انتهاء الكلام إلى أوّل صوت. وهذا هو الحدّ الذي تحته تبدو المحادثة محادثةً.
- كُلفة الاسترجاع: ٥٠ مللي ثانية فقط فوق زمن الجواب. فمَن يقول إنّ الاستناد إلى المصادر بطيءٌ لم يقِسه.
- وجود سياقٍ مُسترجَع: ١٠٠٪ على ثلاثين سؤالًا — لم يُجب النظام مرّةً واحدةً من ذاكرته وحدها.
- استرجاع التفسير: إصابةٌ ضمن أعلى خمسةٍ ٠٫٩٠٠. والبحث المتّجهيّ (FAISS) وحده لم يتجاوز ثلاثةً في المئة في أعلى واحد. فالبحث الهجين ليس تحسينًا، بل شرطُ عمل — وهذه أهمّ نتيجةٍ خرجنا بها من تجارب الاسترجاع.
٨. قراراتُ منتجٍ قد تخالف المألوف
هذه ليست تقنية، لكنّها في نظري جوهر الموضوع:
- لا سلاسل (streaks)، ولا نقاط، ولا شارات، ولا عدٌّ لعبادة، ولا لوحة متصدّرين. فلا يُقاس ما بين العبد وربّه، ولا يُحوَّل إلى لعبة.
- لا لونَ أحمر في النظام كلّه. فالخطأ يُذكر بالحبر الأسود مع أيقونة. وحقلٌ أحمر بجوار آيةٍ يصرخ أعلى بكثيرٍ ممّا تستحقّ الغلطة، ولا شيء هنا حالةُ طوارئ.
- يمكنك أن تسأل قبل أن تسجّل الدخول. فالحساب يظهر بعد أن ترى القيمة، ويُصاغ على أنّه حفظٌ لا انضمام.
- كلُّ رفضٍ يترك منتجًا يعمل. رفضتَ الميكروفون؟ اكتب، والمسار المكتوب يجيب بالمصادر نفسها. رفضتَ التنبيهات؟ لم تفقد شيئًا.
- تنبيهٌ واحدٌ فقط: محادثةٌ لم تكتمل. ولا تنبيه لوقت صلاة، ولا «اشتقنا إليك».
- إعلانُ الحدّ ثابت: «هذا مبنيٌّ على المصادر المعروضة، وليس فتوى». وهو إشعارٌ لا تحذير، ولا يُوضع بجواره مثلّثُ خطر.
٩. ما هو مفتوحٌ لكم الآن
ممّا نُشر تحت رخصٍ مفتوحة، وأدعوكم إلى استعماله والإسهام فيه:
١٠. خلاصةٌ في عشر جُمَل، لمن يبني أداةً قرآنية
- ليس كلُّ كبيرٍ صالحًا لمهمّتك — اختر كلّ مكوِّنٍ من هدفك، لا من شُهرته.
- وحِّد الرسم العثماني والإملائي قبل أيّ مقارنة، وبخريطة كلماتٍ لا بقاعدةٍ عامّة.
- استعمل WER لا مسافة تحرير في تقويم التلاوة.
- درِّج النتيجة على مراتب، فـ«صواب أو خطأ» في التلاوة إفتاءٌ لا تقويم.
- لا تفترض أنّ مطلع الآية يكفي لتحديدها — سُبعُ الآيات تشترك في مطالعها.
- لا تبنِ RAG لسؤالٍ له إجابةٌ حتميّة. فقراءةُ ملفٍّ بالمفتاح أدقُّ وأسرع.
- البحث الهجين شرطُ عملٍ لا تحسين حين تبني استرجاعًا فعليًّا.
- لا تجعل التلاوة مُركَّبة. فالقرآن محتوًى، لا صوتُ واجهة.
- ضع النموذج خلف مفتاحٍ في البيئة منذ اليوم الأوّل، وإلّا فكلُّ تجربةٍ إعادةُ نشر.
- اعرض المصدر قبل الجواب. فلو لم تأخذوا من هذا كلِّه إلّا واحدة، فلتكن هذه.
وأخيرًا
أشكر فريق مجتمع إتقان على الدعوة الكريمة، وأنا سعيدٌ جدًّا بلقاء «اسألني ما تشاء» (AMA). وأرحّب خصوصًا بالأسئلة في:
- تعرُّف الكلام وتركيبه في العربية الفصحى المشكولة
- ضبط النماذج العربية (fine-tuning) وتدريبها بموارد محدودة
- تصميم طبقة أدواتٍ على MCP لتطبيقٍ قرآني
- تطبيع النصّ القرآني ومطابقة التلاوة
- تطوير استرجاع الحديث الشريف وتحسينه
- تصميم واجهةٍ عربيةٍ أوّلًا، وحدودُ ما ينبغي أن يقوله نظامٌ كهذا وما لا ينبغي
وأدعوكم أن تجرّبوا «مسلم» بأنفسكم على muslim.yahyaelnawasany.com، وأن تُصارحوني بما ترونه فيه؛ فنقدُكم أنفعُ لي من الثناء، وكلُّ ملاحظةٍ منكم تُصلح ما لم أكن لأراه وحدي. وإن وجدتم فيه خيرًا، فدُلّوا عليه من تحبّون وانشروه في مجالسكم؛ فقد قال صلّى الله عليه وسلّم: «مَن دلَّ على خيرٍ فله مثلُ أجر فاعله» (رواه مسلمٌ في صحيحه). فما بُني هذا العمل إلّا ليُنتفع به.
وأكتب آرائي ومقالاتي وأعرض أعمالي على موقعي الشخصيّ yahyaelnawasany.com، وفيه غرفتان: الورشة لأعمالي الهندسية ومشاريعي المفتوحة وأبحاثي، والمَوقِد لما أكتبه في التقنية وغيرها. وما زال البيتُ يُبنى.
وأمرٌ شخصيّ أختم به: فقد مَنّ الله عليّ بالإعفاء النهائيّ من الخدمة العسكرية، وبدأتُ من ثَمَّ أنظر في فرص العمل وأدرسها. فإن كان عند أحدكم فرصةٌ يراها تناسبني، أو بابٌ يدلّني عليه، فسأكون له من الشاكرين، وجزاه الله خيرًا.
جزاكم الله خيرًا، وبارك في جهودكم.
يحيى النوساني
yahyaelnawasany.com · muslim.yahyaelnawasany.com · github.com/NightPrinceY · huggingface.co/NightPrince


