السلام عليكم ورحمة الله وبركاته،
إخوتي في مجتمع إتقان، نشارككم اليوم إطلاق SAWT V4، نموذجنا المفتوح للترميم الصوتي التوليدي بتردد 48 كيلوهرتز وبأوزان ومعمارية كاملة.
عندما نشرنا نموذج zipformer v3 قبل فترة، عرضنا لمحة تجريبية أولية (v0.2). اليوم، يكتمل النموذج بكامل أوزانه وشيفرته البرمجية وتقريره التقني على منصة هجينغ فيس: huggingface.co/Quran-Lab/sawt-v4.
لماذا بنينا SAWT؟
يحتفظ التاريخ بقرن كامل من أندر التلاوات وأعذبها على أشرطة قديمة، أو في قاعات واسعة ذات صدى هائل، أو عبر تسجيلات مضغوطة ومنخفضة الجودة على الإنترنت.
النماذج التوليدية العامة للترميم الصوتي تعاني من علّة قاتلة: الهلوسة الصوتية. في الكلام العادي قد يُغتفر تبديل حركة أو تشويه مقطع صوتي خفيف، لكن في تلاوة القرآن الكريم تغيير الصوت أو الحرف يُعدّ تحريفاً لا يُقبل بحال.
لذا بنينا SAWT على قاعدة واحدة لا مساومة فيها: استعادة كامل النطاق الصوتي الترددي وجودة الاستوديو دون توليد كلمة واحدة لم تُقل، ودون أي انحراف في الفونيمات الصوتية.
كيف يعمل النموذج: المرساة الحتمية والمولّد
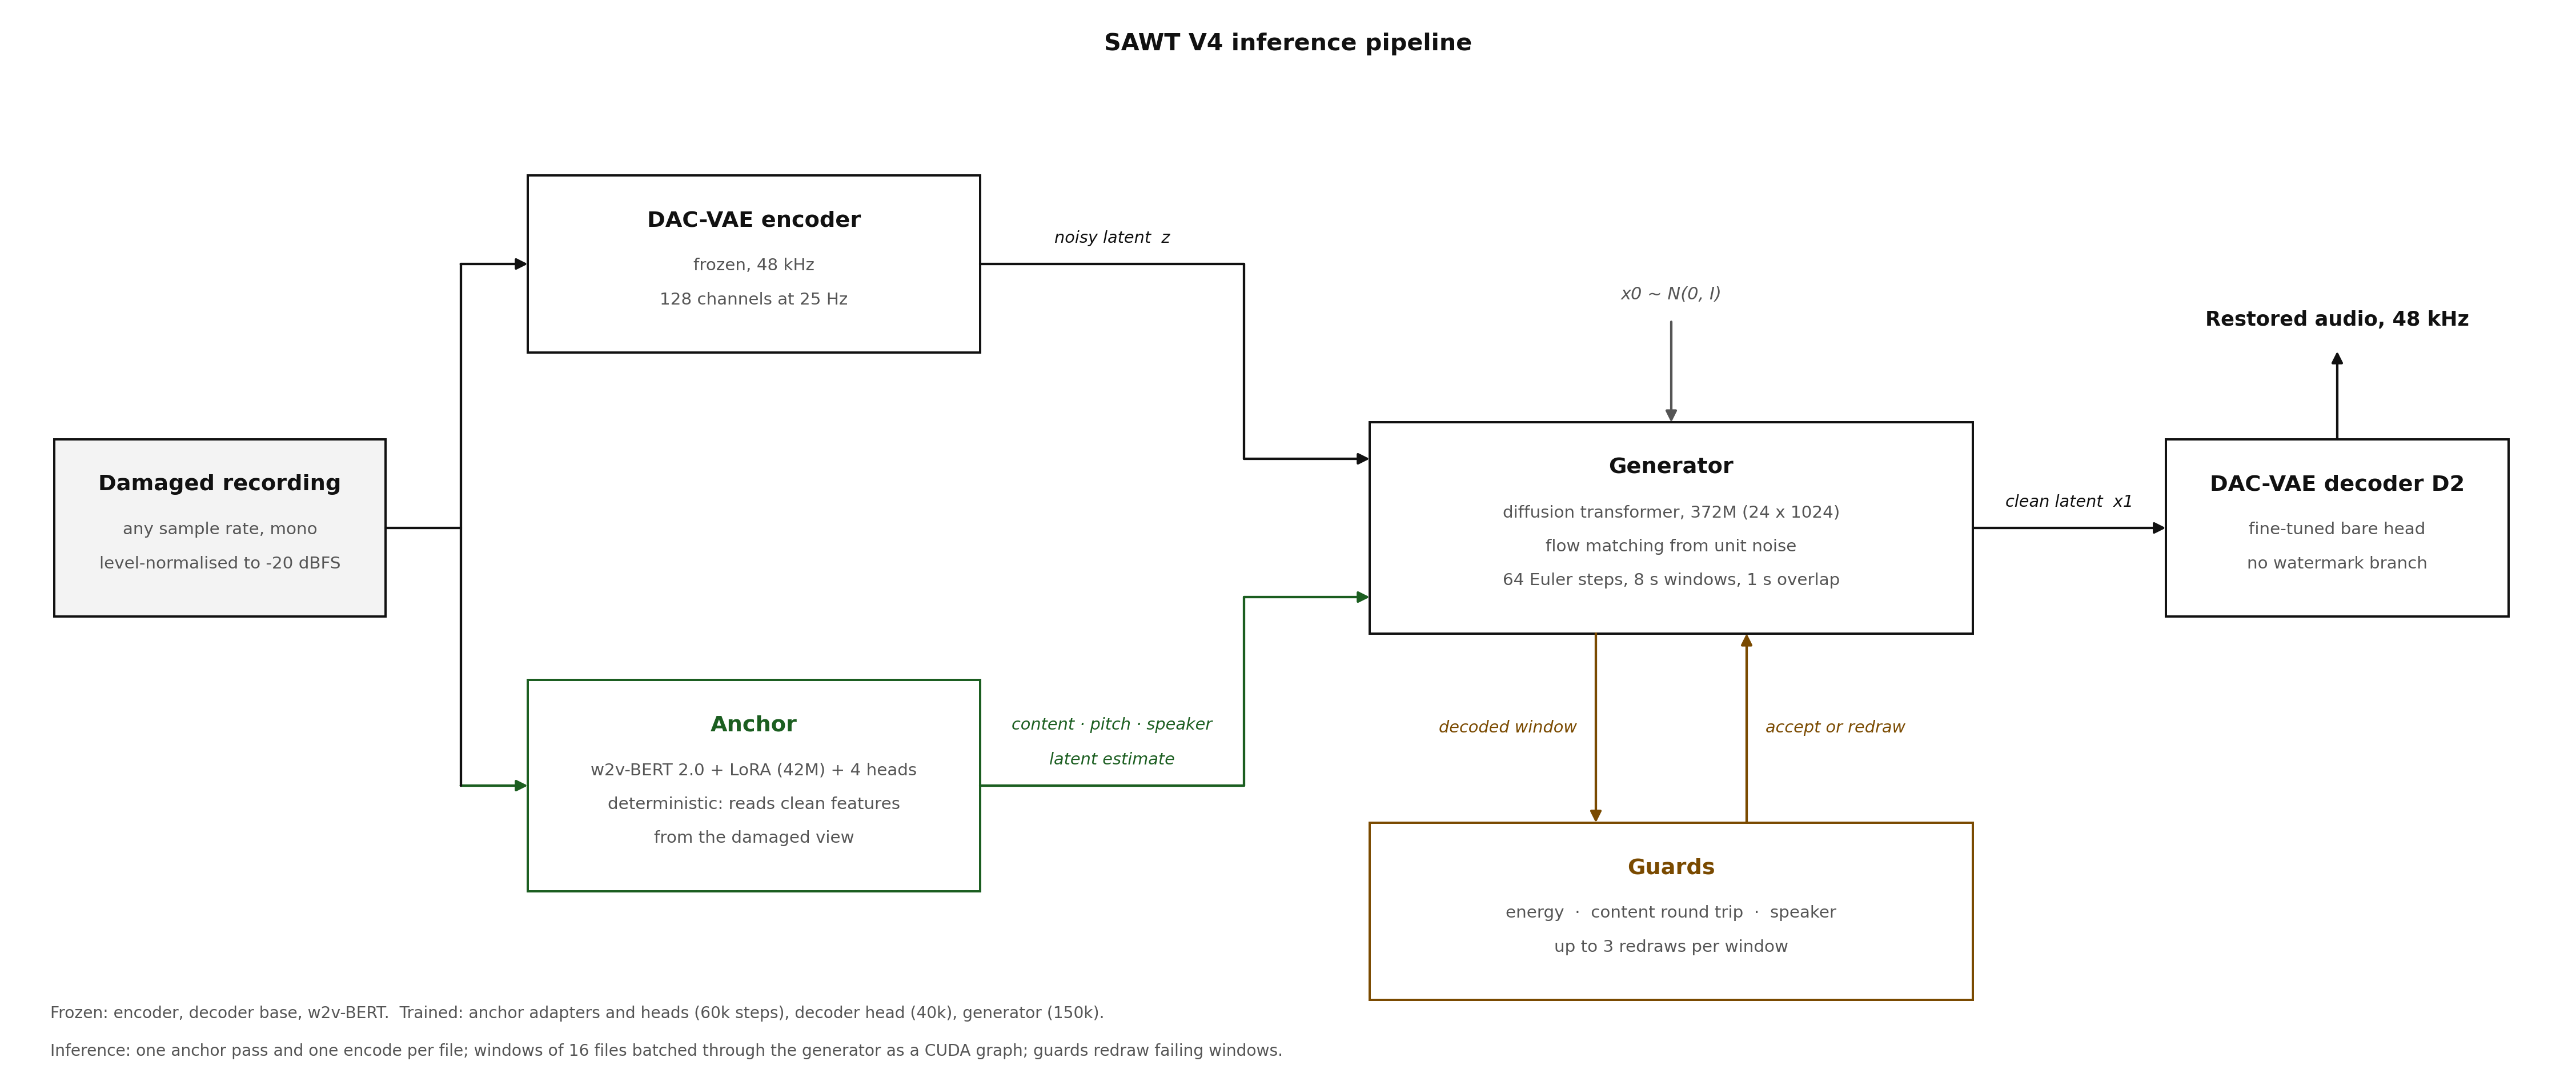
تفصل المعمارية بين محتوى الكلام وقوامه الصوتي فصلاً صارماً:
- المرساة الحتمية (Deterministic Anchor): مبنية على نموذج w2v-BERT 2.0 مع LoRA وأربعة رؤوس مخصصة، تقرأ الإشارة المشوهة بتردد 16 كيلوهرتز، وتستخرج منها ميزات المحتوى، وطبقات التمثيل، وطبقة الصوت (Pitch)، والمتجه الصوتي للمتحدث، وتقدير التمثيل الكامن النظيف. المرساة حتمية تماماً؛ هي التي تحدد ما قيل وهوية من قاله.
- المولّد التوليدي (Latent Flow-Matching Generator): محول انتشار (Diffusion Transformer) من 24 طبقة يعمل على التمثيل الكامن لنموذج DAC-VAE المجمد بتردد 48 كيلوهرتز (128 قناة عند 25 هرتز). يستقبل توجيه المرساة إطاراً بإطار ليعيد بناء النقاء الصوتي، وتفاصيل الغرفة، والترددات العالية حتى 24 كيلوهرتز، دون أن يتدخل إطلاقاً في اختيار الكلمات أو الحروف.
- حراس جودة التنفيذ (Runtime Guards): تُفحص كل نافذة معالجة (8 ثوانٍ) قبل اعتمادها؛ فإن حدث انهيار في الطاقة، أو انحراف في المحتوى عن الأصل (مسافة الجيب التمام أقل من 0.85)، أو قفزة غير طبيعية في بصمة المتحدث، يُعاد توليد النافذة فوراً.
- نمط التلاوة (
--select-k 3 --select-by asr): يولد ثلاثة خيارات لكل نافذة، ثم يختار تلقائياً الخيار الأكثر مطابقة للنطق القرآني عبر نموذج التعرّف الصوتي الخاص بنا المدمج مع الحزمة.
نتائج القياس والتقييم
خضع SAWT V4 لبروتوكول تقييم مسجّل مسبقاً (Pre-registered) يتضمن 16 معيار نجاح جُمدت شروطها قبل بدء التقييم النهائي:
- 120 تسجيلاً حقيقياً من الأرشيف القرآني: نسبة خطأ الفونيمات مقارنة بالنص القرآني بلغت 0.071 (وتنخفض إلى 0.068 في نمط التلاوة)، مقارنة بنسبة 0.062 للتسجيل الأصلي (وهي الحد الأدنى لنموذج التعرف نفسه على الصوت النقي). ثبات هوية المتحدث بلغ 0.941، وانخفضت أرضية الضجيج إلى -69.6 dBFS.
- إزالة الصدى الشديد في القاعات الكبيرة: تراجعت ذيول الصدى الممتدة من 6 إلى 7 ثوانٍ لتصل إلى أرضية نقية بين -64 و-69 dBFS مع بقاء الكلمات سليمة تماماً.
- مقارنة بنماذج الكلام العام: بمقارنته مع نموذج Miipher من Google على مجموعة LibriTTS-R، أظهر SAWT انحرافاً أقل في النص (0.042 مقابل 0.068)، وتطابقاً أعلى في هوية المتحدث (0.988 مقابل 0.962)، ونسبة كلمات مفقودة أقل بكثير (0.7% مقابل 1.9%).
- تعدد اللغات: دُرّب على نحو 900 ساعة استوديو عالية النقاء عبر 35 لغة، ويرمم لغات لم يرها في التدريب.
- السرعة ومتطلبات التشغيل: يعمل بسرعة تفوق الوقت الفعلي بـ 10 إلى 16 ضعفاً على بطاقة RTX 4090 باستهلاك أقل من 15 جيجابايت VRAM.
موضع SAWT في منظومة Quran Lab
كما بيّنا سابقاً في نقاشات المجتمع، فإن SAWT لا يوضع أمام محرك التسميع الآني في التطبيقات؛ لأن نموذج التعرّف على الهاتف مُدرّب أصلاً على قراءة الصوت المشوّه ولا يحتاج إلى معالجة مسبقة.
قيمة SAWT تتركّز في مسارين أساسيين:
- بناء بيانات التدريب: تنقية آلاف الساعات من التلاوات التاريخية والتسجيلات الميدانية لتتحول إلى مادة تدريب صالحة لنموذج التخليق الصوتي (QuranTTS)، والذي نستخدمه لتوليد بيانات الأخطاء الصوتية والتجويدية اللازمة لتطوير نموذج التسميع (ASR).
- حفظ التراث القرآني: إعادة التلاوات التاريخية النادرة والتسجيلات القديمة إلى نقاء الاستوديو لتكون متاحة للسامعين والباحثين بأبهى صورة.
الروابط والرخصة
الرخصة (SAWT License 1.0): متاح للاستخدام والبحث والتطوير والاستضافة كوقف عام. لا يجوز بيع النموذج أو أي ميزة تعتمد عليه أو وضعه خلف اشتراكات مدفوعة، ويُسمح فقط باسترداد تكلفة الاستضافة والتشغيل المباشرة.
جربوا النموذج على تسجيلاتكم وأرشيفكم، وشاركونا ملاحظاتكم وحالات الاختبار الصعبة.
