في هذا الموضوع أشرح تجربتي في تنفيذ البحث الدلالي Semantic Search في نصوص القرآن الكريم.
هدفي من التجربة اختبار الربط بين المعاني القرآنية المختلفة، حتى وإن اختلفت الصياغة اللفظية، وتقييم دقة النتائج مقارنة بالبحث التقليدي بالكلمات.
فالبحث الدلالي يعني أن نبحث في المعنى لا في الكلمة نفسها، فعندما نود البحث مثلًا عن آيات تتحدث عن "جزاء الظالمين" ستظهر نتائج قريبة من الفكرة وفيها مرادفات مثل "المجرمين" و"من كان كُفِر" وليس بالضرورة مشابهة لفظيًا لما نبحث عنه.
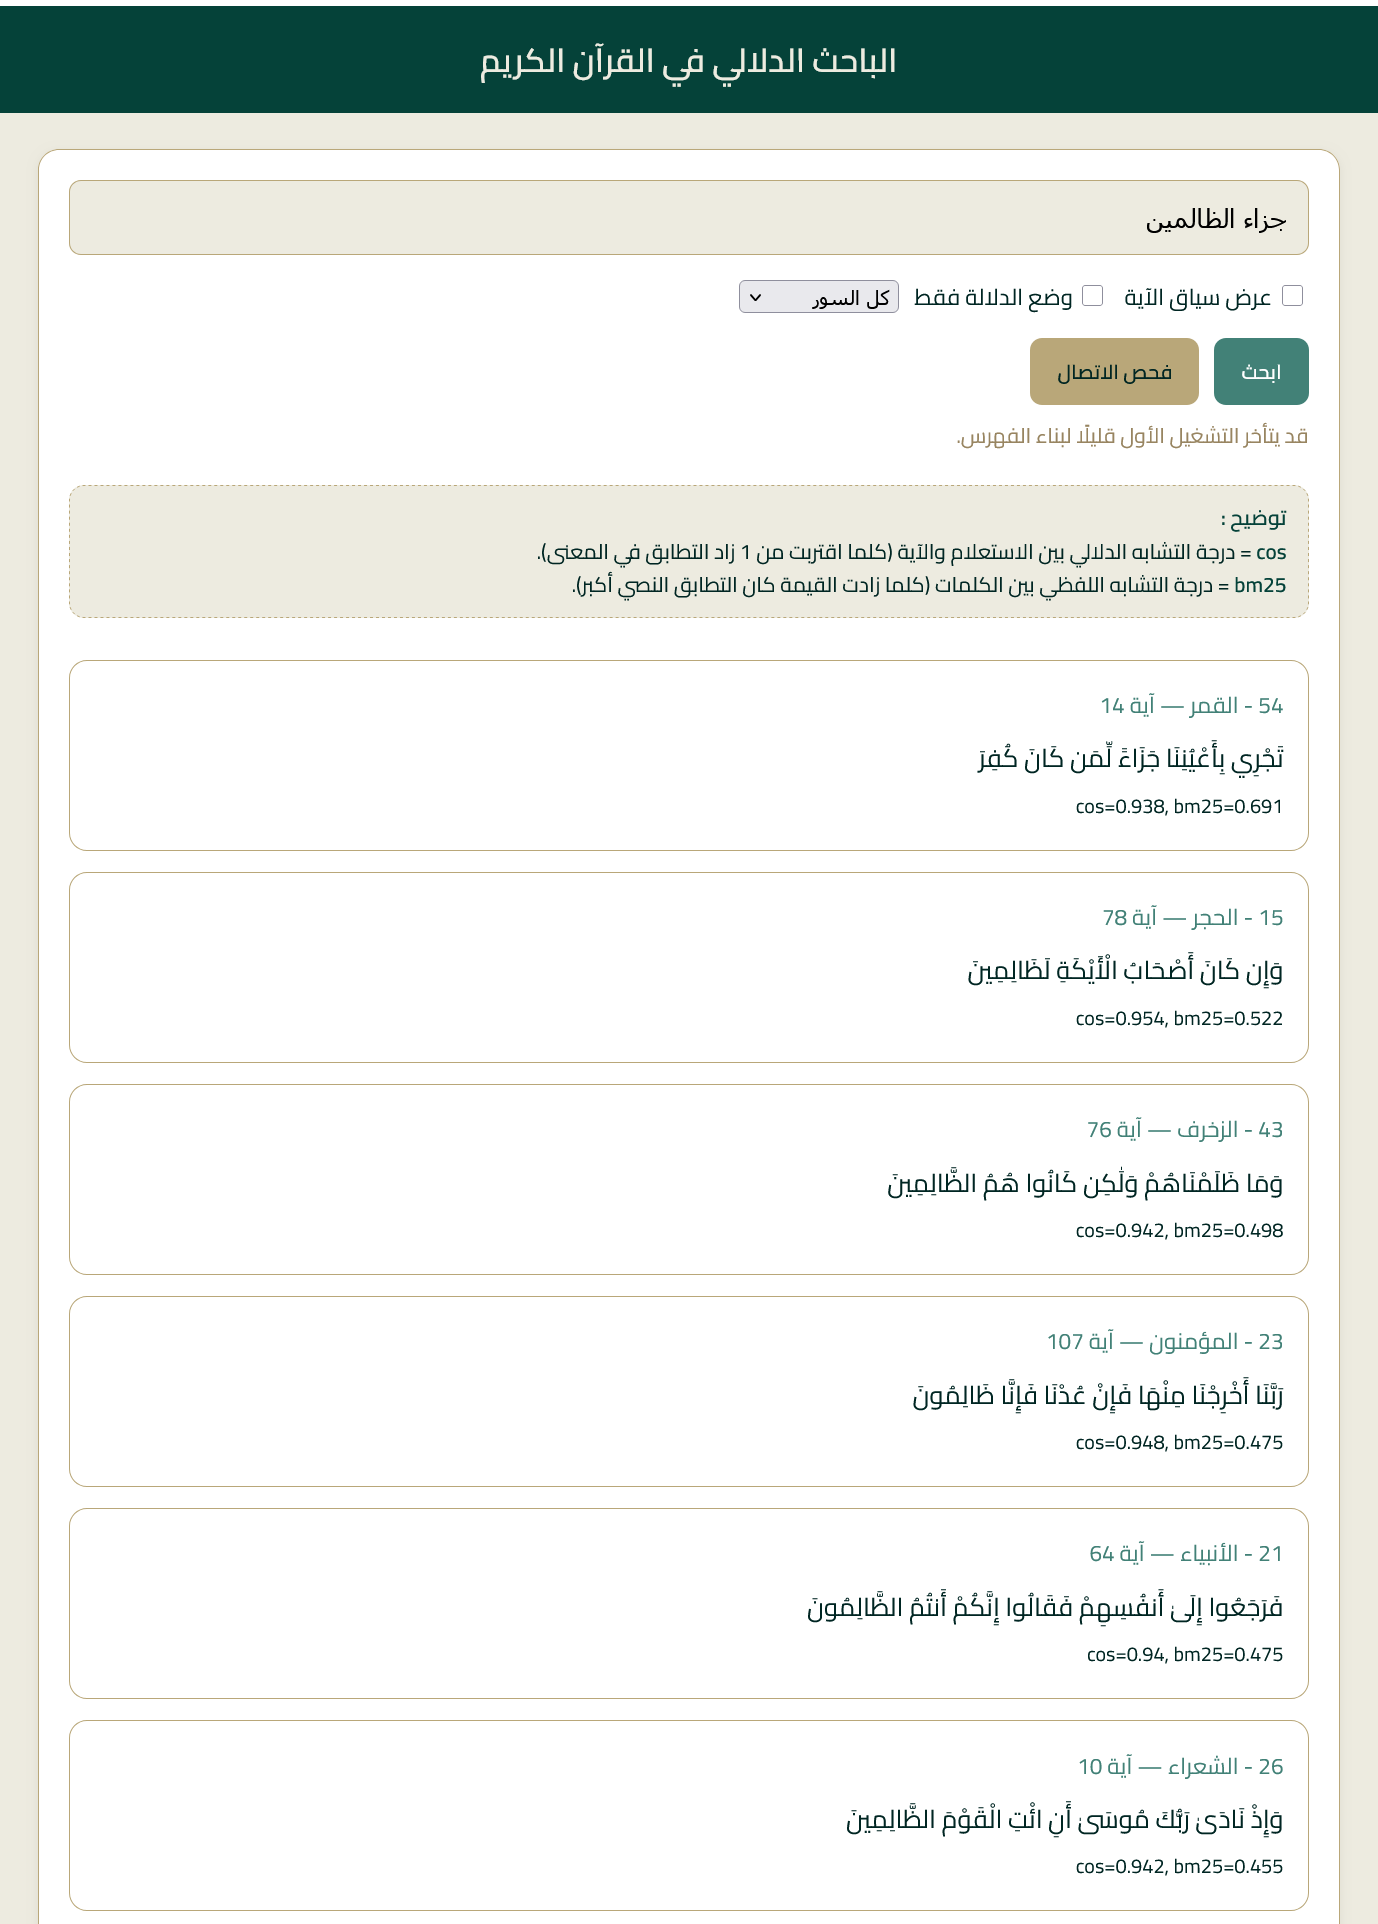
الفرق بين البحث الدلالي واللفظي
يعتمد البحث الدلالي على النماذج اللغوية العميقة التي تفهم العلاقة بين الكلمات من خلال تحويل النصوص إلى تمثيلات رقمية Embeddings يمكن مقارنتها حسابيًا.
يُقاس هذا القرب باستخدام معامل Cosine Similarity الذي يعطي قيمة بين 0 و1، حيث تقترب القيمة من 1 كلما زاد التشابه الدلالي بين النصين
كل آية واستعلام يحولان إلى متجهات عددية، وبمقارنتها نحصل على درجة التشابه في المعنى بدل التشابه في الألفاظ.
أما البحث اللفظي فيعتمد على مقارنة الكلمات نفسها دون فهم المعنى، فيقيس مدى تطابق الألفاظ بين الاستعلام والنصوص ويستخدم خوارزميات مثل BM25 تحسب وزن كل كلمة بناءً على تكرارها داخل الآية وندرتها في بقية النصوص.
استخدمت في المشروع أسلوبًا هجينًا يجمع بين الأسلوبين
النماذج والتقنيات
بحثت بين النماذج المفتوحة واخترت نماذج توازن بين الدقة في فهم سياق اللغة العربية والسرعة في توليد التضمينات، لتناسب تشغيل المشروع على جهازي الشخصي:
intfloat/multilingual-e5-base: نموذج متعدد اللغات من مكتبة SentenceTransformers، خفيف وسريع، يحول النصوص العربية لمتجهات عددية تمكن من قياس قرب المعنى.
hkunlp/instructor-large (اختياري عند توفر GPU)
نموذج متقدم من عائلة INSTRUCTOR يفهم هدف النص قبل التضمين عبر تعليمات لغوية، ما يرفع دقة الفهم الدلالي.
FAISS مكتبة من Meta للفهرسة والبحث السريع بين المتجهات العددية Embeddings الناتجة عن النماذج اللغوية.
- rank-bm25 مكتبة بايثون توفر خوارزمية BM25Okapi للبحث اللفظي، تعتمد على تكرار الكلمات في النصوص لتقدير أهميتها، وتساعد في ترتيب النتائج بحسب تطابق الألفاظ مع استعلام البحث.
طريقة التنفيذ
المشروع مكون من واجهتين:
الواجهة الخلفية Backend
استخدمت FastAPI لبناء واجهة برمجية سريعة لمعالجة النصوص وتنفيذ البحث.
عند التشغيل:
- يُحمَّل النموذج intfloat/multilingual-e5-base
- تُحدّد إعدادات النموذج والمنفذ Port وعدد النتائج الافتراضية عبر ملف .env
- تُحوَّل الآيات إلى متجهات أو تضمينات رقمية
- تُفهرس المتجهات عبر FAISS
- تُنشأ نسخة نصية منها لـ BM25 للبحث اللفظي
وعند الاستعلام:
- يُحوَّل النص إلى تضمين ويُبحث عنه دلاليًا في FAISS.
- تُحسب درجة التشابه اللفظي باستخدام BM25.
- يتم دمج النتيجتين وفق المعادلة التالية:
hybrid_score = 0.6 * cosine_score + 0.4 * bm25_score
يوازن هذا الدمج بين الفهم الدلالي والدقة اللفظية لنتائج أكثر واقعية
أخيرًا تُعرض النتائج مرتبة حسب الأعلى دلالة، ويمكن تفعيل خيار "وضع الدلالة فقط" لتعطيل البحث اللفظي باستخدام bm25.
الواجهة الأمامية Frontend
واجهة بسيطة مبنية باستخدام HTML وCSS وجافا سكريبت لعرض النتائج ببساطة.
ترسل الطلب إلى نقطة الوصول /search التي يقدمها الخادم الخلفي وتظهر:
- نتائج البحث
- cos: القرب الدلالي للنتيجة (من 0 إلى 1)
- bm25: التشابه اللفظي للنتيجة (من 0 إلى 1)
- يمكن أيضًا عرض سياق الآية (السابقة واللاحقة).
الكود البرمجي للمشروع
الكود البرمجي متاح على GitHub على الرابط التالي:
https://github.com/engsaleh/quran_semantic_search
يمكن تشغيل المشروع محليًا بالخطوات الموضحة في ملف README.md داخل المستودع.
تحسينات مستقبلية
المشروع هو تجربة أولية ويمكن تحسينه لعرض نتائج أدق مستقبلًا من خلال:
إضافة قائمة كلمات توقف عربية (stop words) لاستبعاد الكلمات الشائعة وتحسين جودة المطابقة.
تعديل وزن البحث الدلالي ديناميكيًا وفق طول الاستعلام ونوعه.
تفسير النتائج بإيضاح سبب ارتباط كل آية بالاستعلام لتسهيل الفهم.
دمج التفاسير والترجمات لتوسيع السياق وتعزيز الفهم متعدد اللغات.
تجربة نماذج لغوية أعمق متخصصة في النصوص القرآنية.
