أشارككم اليوم تجربتي في بناء نموذج أولي (Prototype) لتطبيق بيان، وهو محرك بحث دلالي (Semantic Search) يعتمد على فهم المعنى والسياق بدلاً من التطابق اللفظي للكلمات.
الهدف من التجربة كان تجاوز مشكلة البحث التقليدي الذي يفشل غالبًا في الإجابة عن أسئلة مفاهيمية إذا لم ترد الكلمة صراحة في النص.
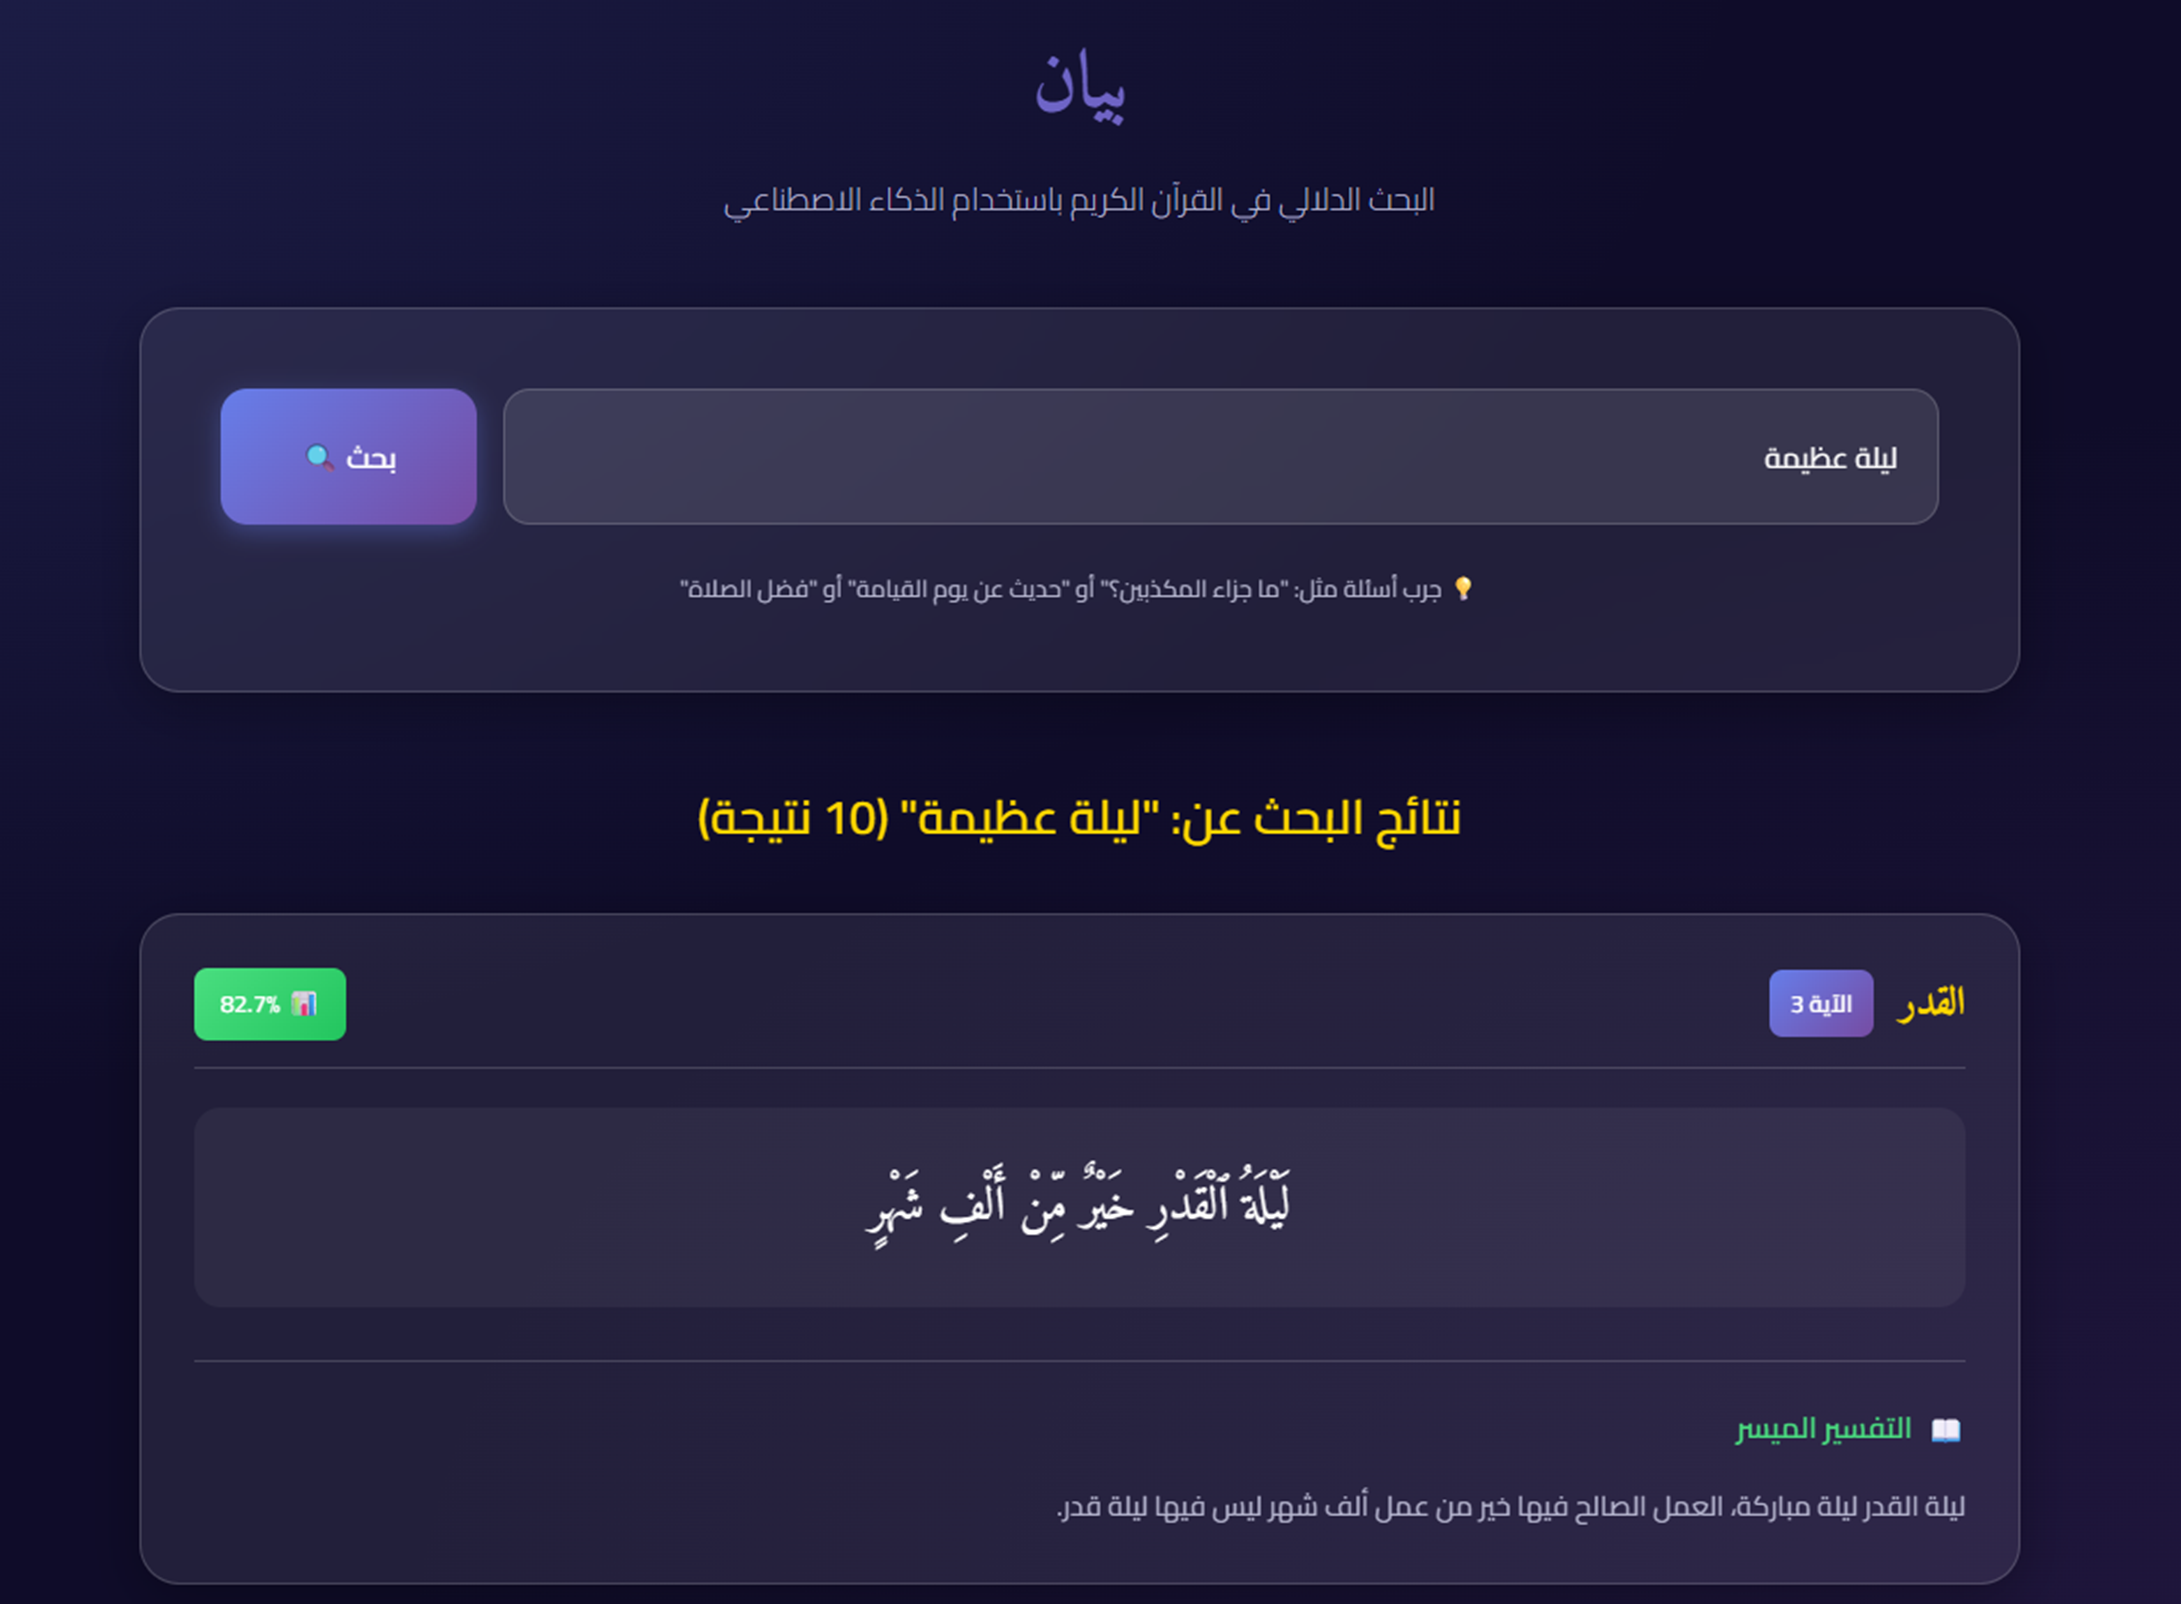
المنهجية التقنية
اعتمدت في هذا المشروع على لغة PHP مع قاعدة بيانات MySQL، واستخدمت نموذج Gemini Embedding-001 لتوليد التضمينات (Vectors). وفيما يلي التفاصيل الدقيقة للمنهجية التي اتبعتها، والتي أطرحها للنقاش:
1. هيكلة البيانات (Database Structure)
قمت بتصميم قاعدة بيانات علائقية تتضمن جداول مخصصة لضمان سرعة الاسترجاع:
- جدول السور (surahs): لتخزين البيانات الوصفية (مثل اسم السورة، عدد الآيات).
- جدول الآيات (verses): وهو العصب الرئيسي، حيث لا يخزن فقط النص القرآني، بل يتضمن حقولاً لتخزين التفسير الميسر و Vector Embeddings لكل آية، مما يدمج البيانات النصية والدلالية في مكان واحد.
2. مصدر البيانات والتجهيز (Data Preparation)
بدلاً من عمل Embedding لنص الآية القرآني مباشرة (الذي قد يكون بليغًا وموجزًا جدًا بحيث لا يلتقطه البحث الدلالي العام بسهولة)، قمت بالاعتماد على التفسير كمصدر أساسي للمعنى، حيث:
- المصدر: التفسير الميسر (عن طريق Quran.com API).
- آلية التخزين: لم أعتمد على الجلب المباشر وقت البحث؛ بل قمت ببناء Scripts مخصصة تقوم بجلب البيانات مرة واحدة وتخزينها محلياً في قاعدة البيانات.
- آلية التضمين: قمت بتوليد Vector للنص الكامل للتفسير الخاص بكل آية وتخزينه في قاعدة البيانات. لم أقم بدمج نص الآية مع التفسير في هذه المرحلة لضمان أن يكون البحث مركزًا على الشرح والمعنى.
3. تقنية توسيع الاستعلام (Query Expansion)
واجهت مشكلة أن استعلام المستخدم قد يكون قصيرًا جدًا أو عاميًا، مما يضعف دقة النتائج. ولحلها، قمت بتطبيق تقنية برمجية قبل إجراء البحث:
- عندما يكتب المستخدم سؤالاً، لا أقوم بتحويله إلى Vector فورًا.
- أقوم أولاً بإرسال السؤال إلى Gemini مع Prompt: "اشرح ما هو [سؤال المستخدم] في سياق القرآن الكريم بجملة واحدة مركزة".
- الناتج من هذه العملية (الشرح) هو ما يتم تحويله إلى Vector ومقارنته مع التفسير المخزن. هذه الخطوة رفعت الدقة بشكل ملحوظ لأنها توفر سياقًا لغوياً أغنى للمقارنة.
3. الخوارزمية (Algorithm)
- استخدمت خوارزمية Cosine Similarity الرياضية لحساب المسافة بين Vector السؤال الموسع و Vectors التفاسير المخزنة، ثم ترتيب النتائج تنازليًا حسب نسبة التشابه.
بيئة التطوير
كتجربة جانبية، تم بناء المشروع باستخدام برنامج Google Antigravity الذي ساعد في:
- بناء الهيكل الأساسي: حيث قام البرنامج بإنشاء هيكلية ملفات PHP والـ API بشكل كامل.
- توليد التضمينات: التعامل مع الـ Vectors يحتاج دقة، وقد ساعدني الـ Agent في كتابة دوال الربط مع Gemini API بسلاسة.
تحديات للنقاش
رغم استخدام التقنيات الموضحة، لا تزال هناك تحديات أود سماع آرائكم وخبراتكم حولها:
- كيف يمكننا بناء معيار آلي (Automated Benchmark) لقياس دقة البحث في التطبيقات القرآنية بدلاً من الاعتماد على التقييم اليدوي الذاتي؟
- هل هناك أساليب أخرى (مثل Hybrid Search الذي يجمع بين Lexical و Semantic) جربتموها وأعطت نتائج أفضل مع النصوص العربية؟
- بناءً على تجاربكم، هل هناك نماذج Embedding أخرى تدعم اللغة العربية بكفاءة أعلى من نماذج Gemini الحالية في سياق النصوص الدينية؟
بانتظار آرائكم حول الموضوع.
يمكنكم الاطلاع على الكود المصدري الكامل للمشروع، بما في ذلك هيكلية قاعدة البيانات وسكربتات التضمين، عبر المستودع المفتوح على GitHub.
