في رحلة تطوير البرمجيات، وتحديداً تلك التي تتعامل مع النصوص العربية المقدسة، تمر عليك لحظات إدراك تغير مجرى العمل بالكامل. مؤخراً، استوقفني مقال رائع للمهندسة @دينا أحمد بعنوان "ما الذي يجعل معالجة القرآن الكريم على مستوى الكلمة تحديًا تقنيًا؟"، وتحديداً عند هذه الفقرة التي تضع اليد على الجرح:
"التشكيل كبيانات حرجة لا كزينة بصرية
الحركات والتشكيل ليست metadata اختيارية بل جزء أساسي من هوية الكلمة. كلمة "عَلَم" بفتح اللام تختلف تماما عن "عَلِمَ" بكسر اللام، رغم تطابق الحروف الأساسية. عند التخزين في قاعدة البيانات، التشكيل يجب أن يكون جزءًا من المفتاح الأساسي Primary Key أو Composite Key أو على الأقل من هوية الكلمة المنطقية. فبعض النماذج تتعامل مع التشكيل كضوضاء وتزيله؛ وهذا يدمر المعنى والنطق معا."
هذه الكلمات لخصت تماماً التحدي الذي كنت أواجهه مع منصة AlKetab API، التي يستخدمها الآن بفضل الله أكثر من خمسين مطوراً لبناء تطبيقات قرآنية ذكية.
"ليش الكذب؟".. التغريدة التي أيقظت المطور بداخلي
كنت أدرك نظرياً أن الذكاء الاصطناعي بحاجة لأدوات تميز التشكيل، لكنني أجلت العمل عليها لتعقيدها. حتى جاءتني تلك الملاحظة الصادمة من مستخدم بسيط على تويتر، نسف فيها ادعائي بأن محرك البحث "بدون هلوسة". قال لي بالحرف:
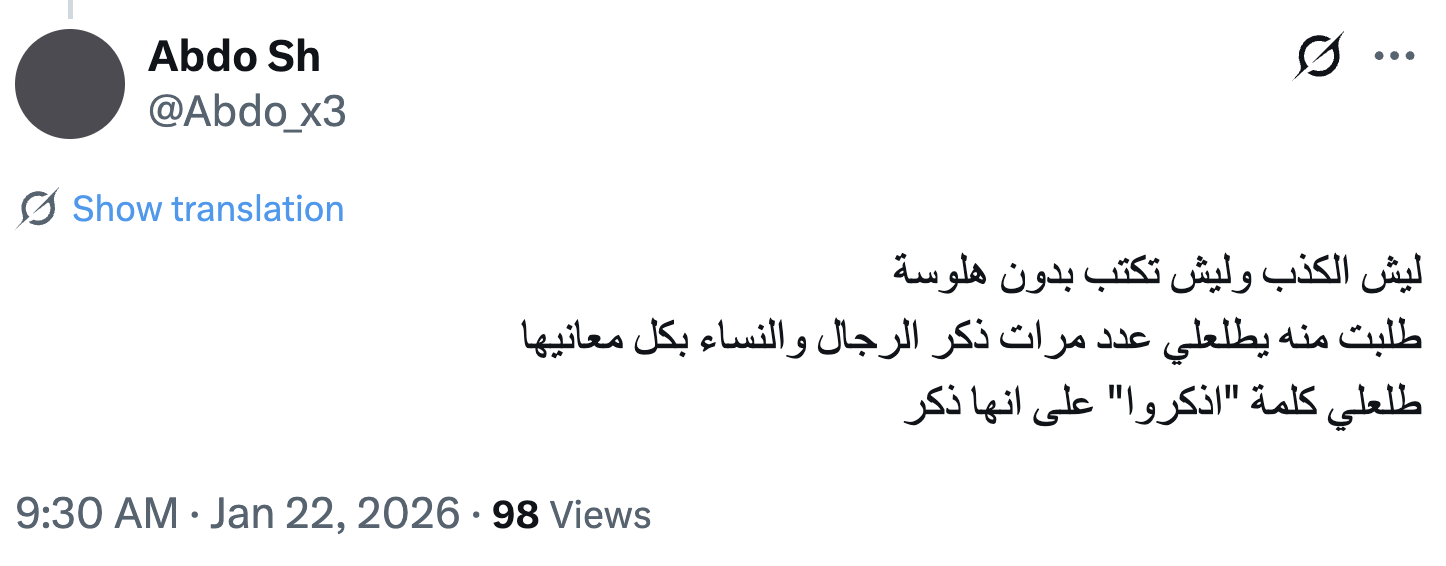
"ليش الكذب وليش تكتب بدون هلوسة.. طلبت منه يطلعلي عدد مرات ذكر الرجال والنساء بكل معانيها.. طلعلي كلمة 'اذكروا' على انها ذكر!"
كانت صدمة، لكنها محقة. المستخدم طلب إحصائية عن "الذكور" (Men/Males)، ونظراً لأن النظام كان يعتمد على البحث بالجذر (Root-based Search)، فقد خلط النظام بين:
- ذَكَر (بمعنى جنس الرجل).
- ذِكْر (بمعنى التذكر أو ذكر الله).
كلاهما يشتركان في الجذر اللغوي (ذ-ك-ر). بالنسبة لمحرك بحث كلاسيكي أو نموذج لغوي يرى التشكيل "ضوضاء"، الكلمتان واحد! وهنا تحتم عليّ التوقف عن التأجيل، والبدء فوراً في منح الذكاء الاصطناعي "نظارة" ليرى التشكيل.
الحل: الأداة السادسة (get_root_vocalizations)
لحل هذه المعضلة، قمت بتطوير أداة جديدة ضمن حزمة أدوات البحث الدقيق (Tool-Augmented Retrieval)، وهي:
الأداة: get_root_vocalizations
الغرض: التمييز بين الكلمات التي تشترك في نفس الجذر ولكن تختلف في المعنى والحركة.
لماذا هي ضرورية؟
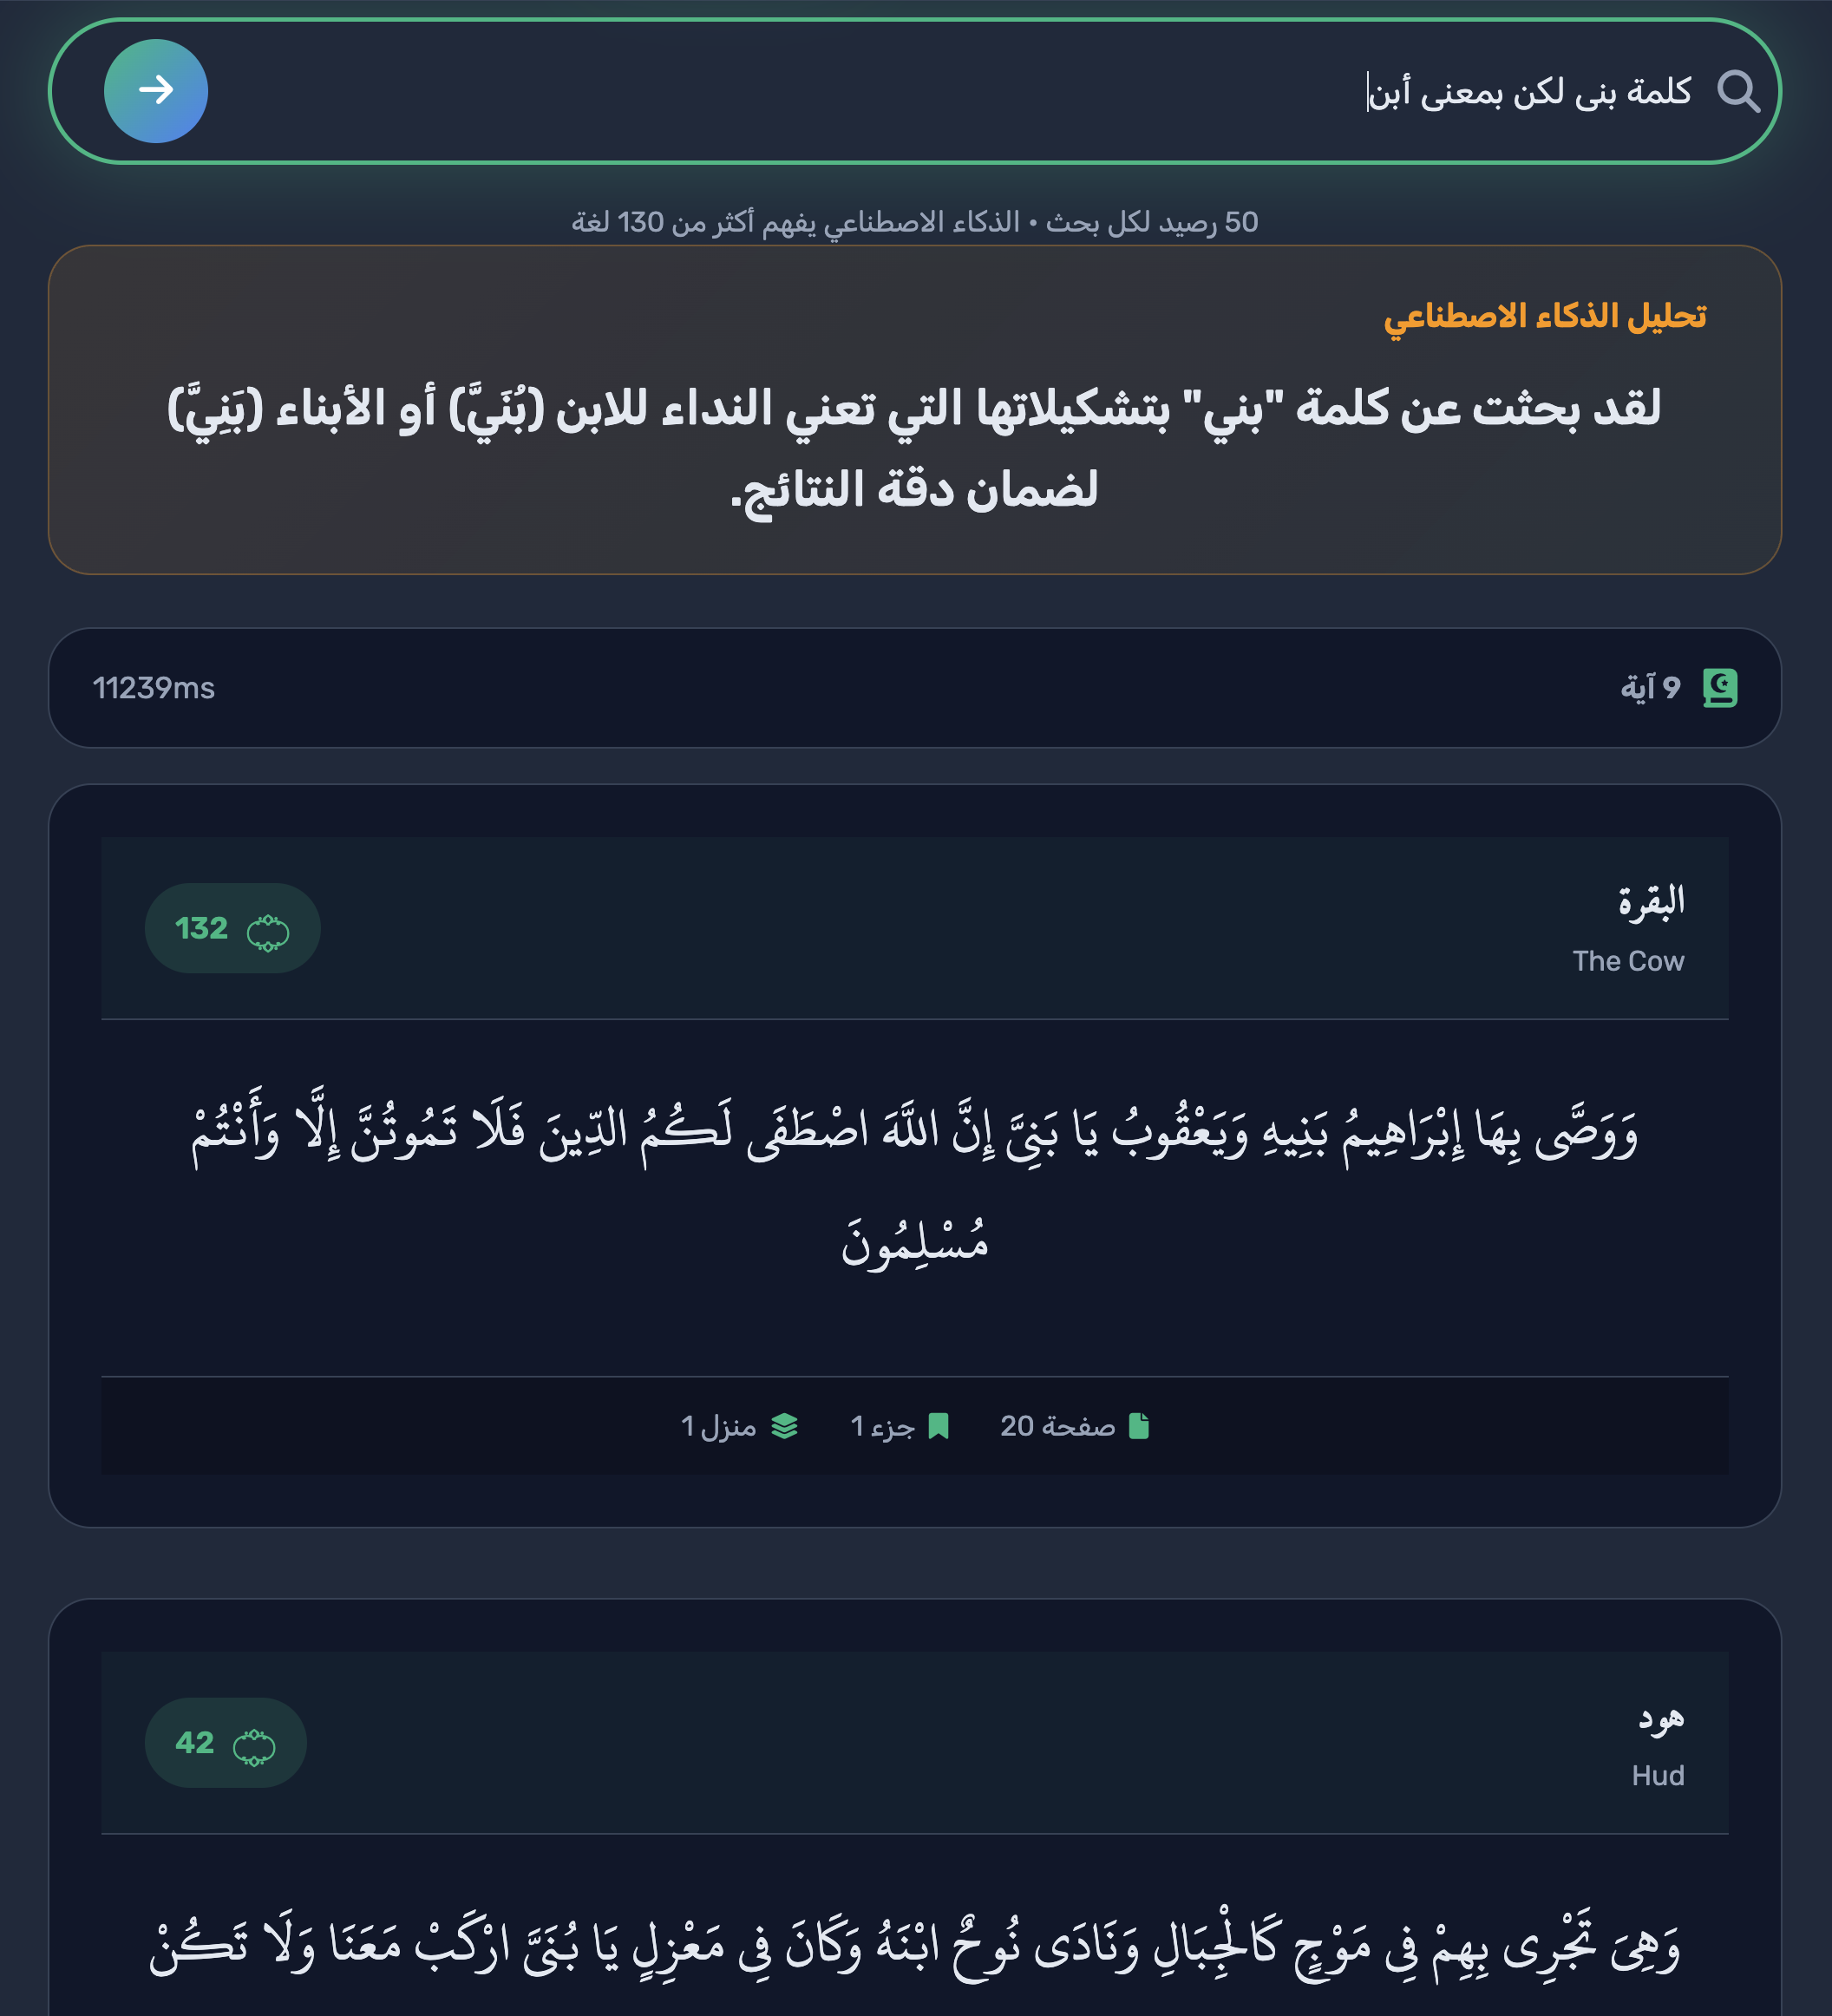
الجذور العربية "مخادعة" للذكاء الاصطناعي. الجذر الواحد قد يولد كلمات لا علاقة لها ببعضها في المعنى إلا برابط اشتقاقي بعيد. بدون التشكيل، سيخلط الـ AI بين "بَنِي" (قبيلة/أبناء) و "بُنِيَ" (الأبن/تم بناؤه)، أو بين "ذَكَر" و "ذِكْر".
كيف يعمل السحر الآن؟
بعد تفعيل هذه الأداة، تغيرت آلية البحث جذرياً لتصبح أكثر ذكاءً ودقة:
سيناريو البحث الجديد:
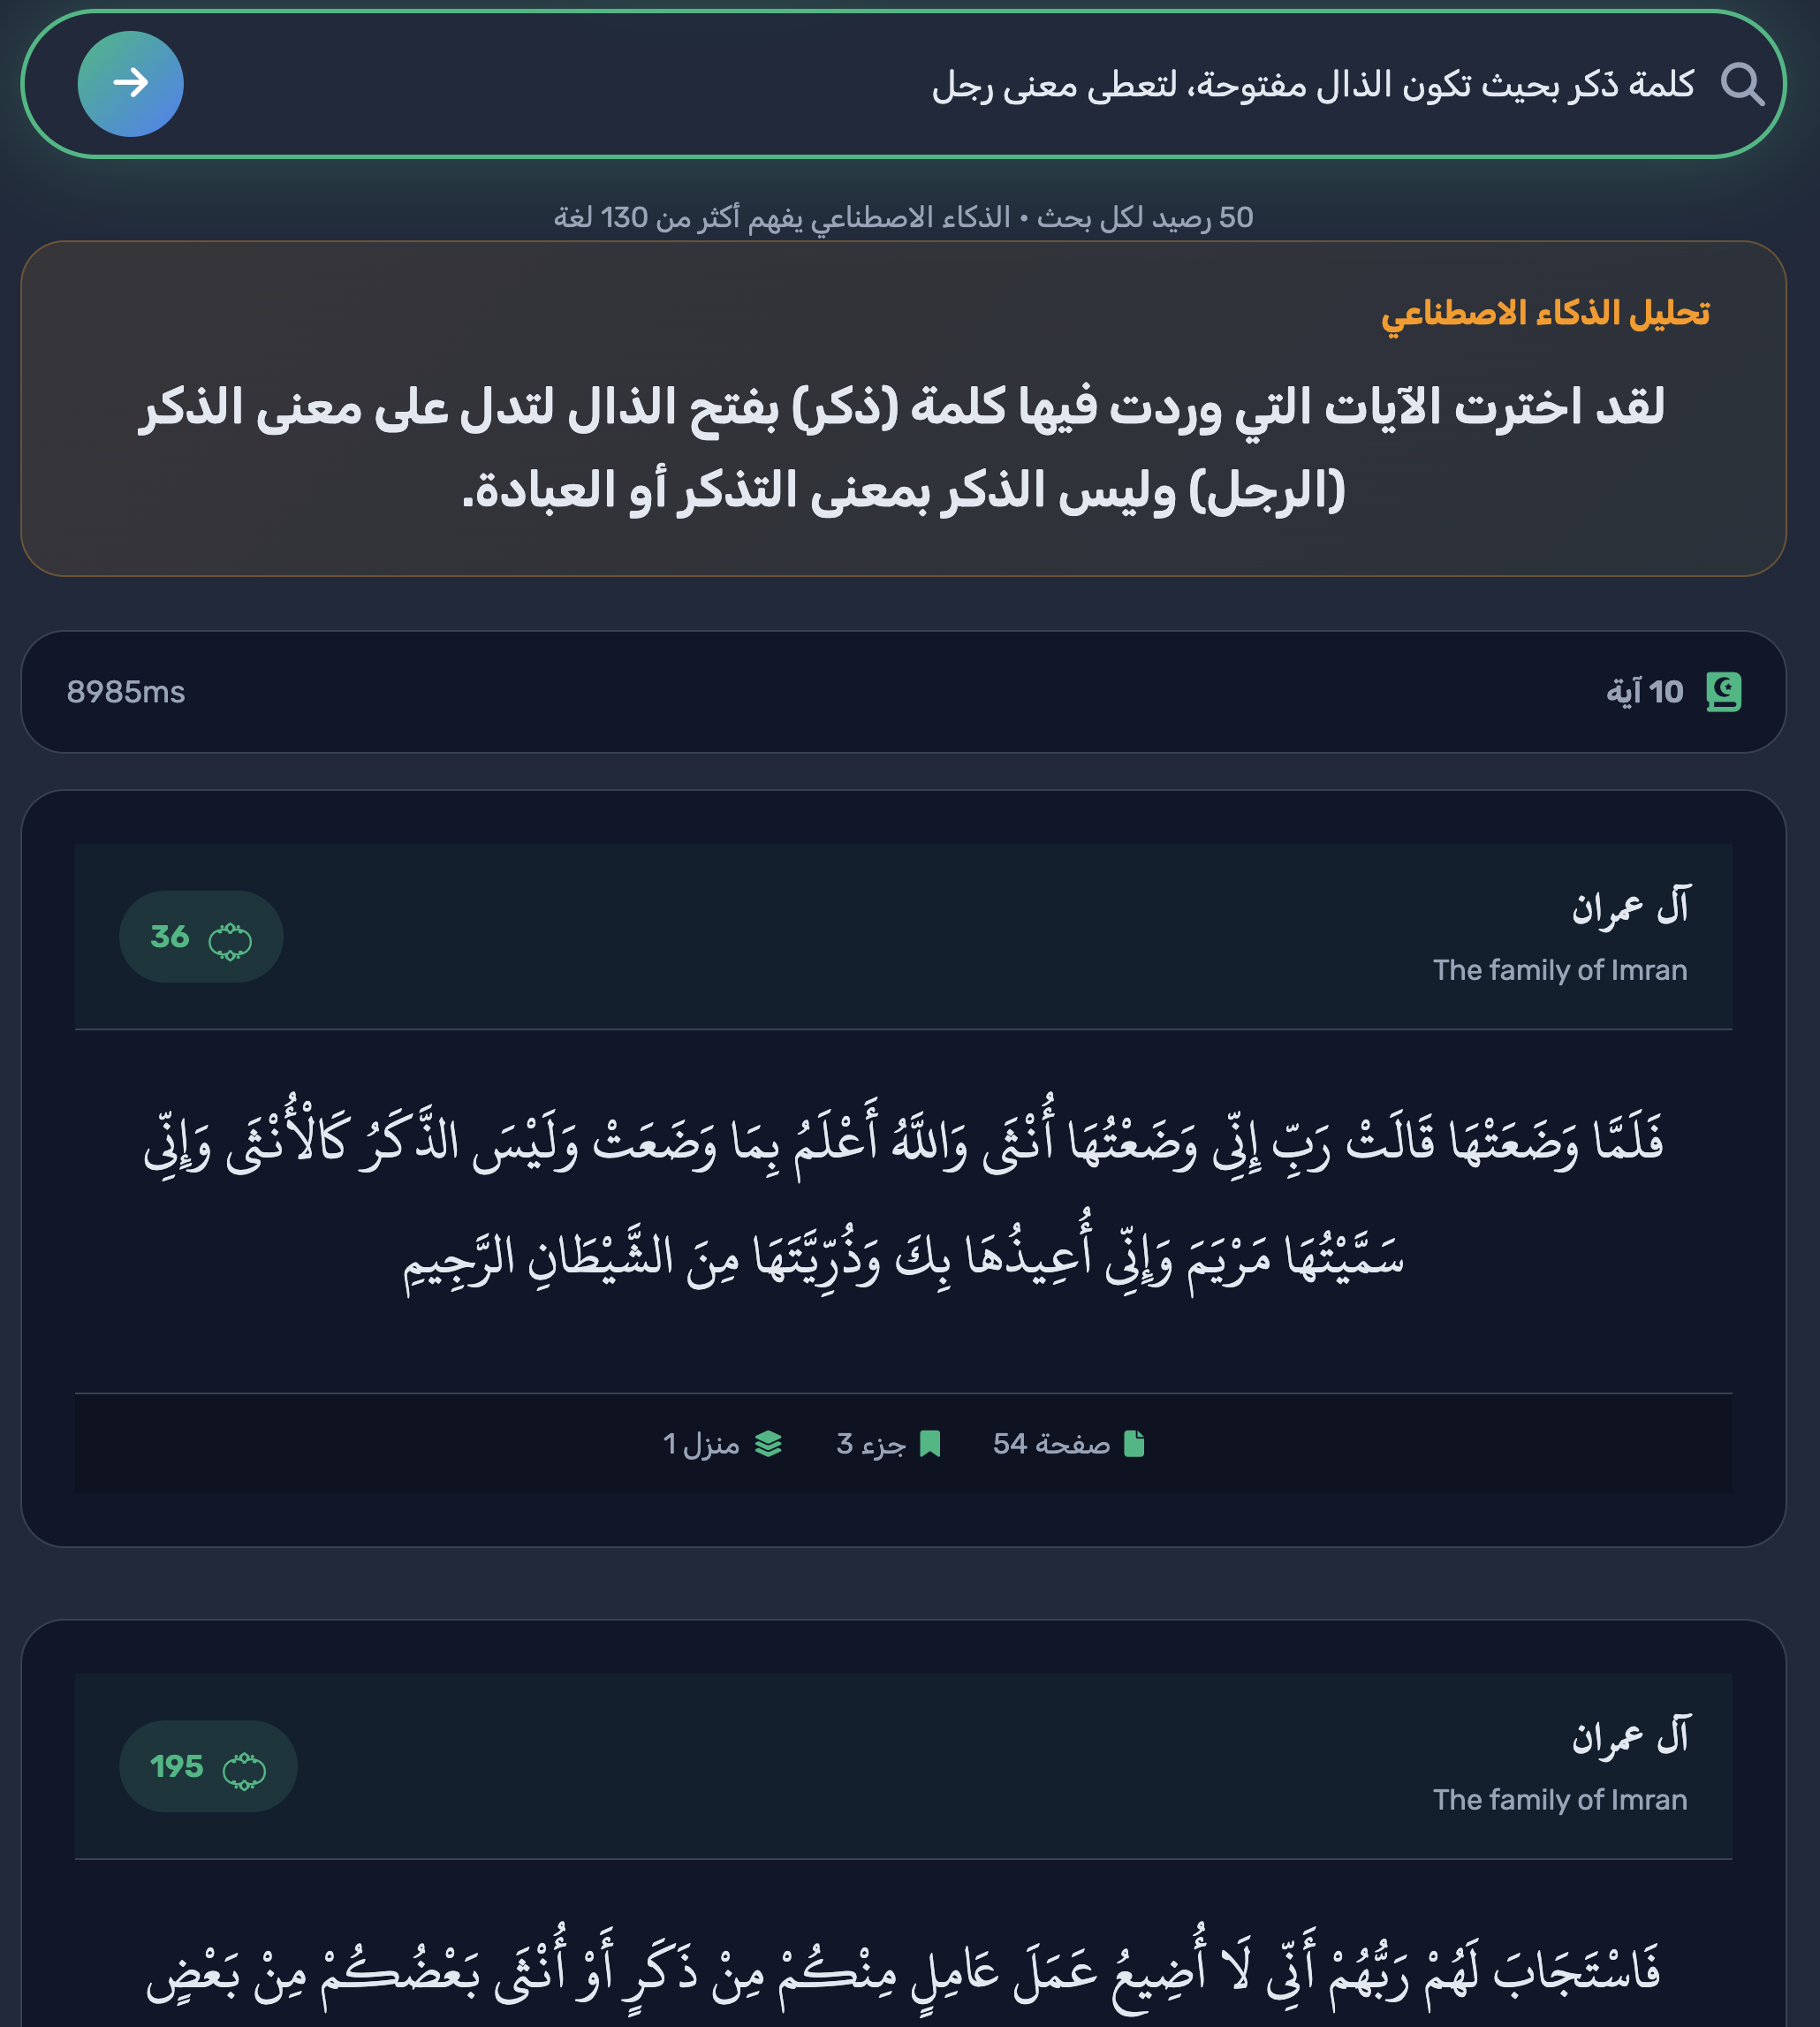
عندما يطلب المستخدم: "آيات عن الذكور" (يقصد المعنى الجنسي، وليس التذكر).
الخطوة الأولى: الذكاء الاصطناعي يفهم أنه بحاجة لفصل المعاني داخل الجذر، فيستدعي الأداة:
get_root_vocalizations(root="ذكر")
الخطوة الثانية: تعيد الأداة كافة الصيغ المُشكَّلة الموجودة في القرآن لهذا الجذر:
- مجموعة الذِّكْر: [ذِكْرِ، ذِكْرًا، اذْكُرُوا...]
- مجموعة الجنس: [ذَكَرٍ، ذُكُورٍ، ذُكُورًا...]
الخطوة الثالثة (الترشيح الذكي): يقوم الذكاء الاصطناعي (بناءً على فهمه لسياق طلب المستخدم) باختيار الكلمات المناسبة فقط:
- يختار: ذَكَرٍ، ذُكُورٍ.
- يستبعد: ذِكْر، اذكروا.
الخطوة الرابعة (البحث الدقيق): ينفذ البحث عن هذه الكلمات المحددة بتشكيلها:
البحث عن: "ذَكَرٍ" OR "ذُكُورٍ"
النتيجة: يعود النظام للمستخدم بالآيات التي تتحدث عن "الذكور" حصراً، وتختفي آيات "الذكر والتسبيح" من النتائج. دقة 100%.
آفاق جديدة للبحث القرآني
هذا التحديث لم يحل مشكلة "الذكر والأنثى" فحسب، بل فتح آفاقاً جديدة بالكامل:
- يمكنك الآن البحث عن "بُنَي" (بمعنى أبناء)
- يمكن التمييز بين "عِلْم" و "عَلَم"
لقد أصبح البحث بالذكاء الاصطناعي في AlKetab API أقوى بمراحل، وكل هذا لأننا عملنا أخيراً بالقاعدة الذهبية: في القرآن الكريم واللغة العربية بشكل عام، التشكيل هو بيانات حرجة، وليس مجرد زينة بصرية.

