تحية طيبة لمجتمع اتقان المتميز .. ولجميع القائمين على هذا الصرح المبارك
أحببت أن أنقل اليكم تجربتي ورحلتي لبناء تطبيق " متنافسون " القرآني والتي استمرت لعدة اشهر . والتي اكتسبت فيها من المهارات في علوم الذكاء الاصطناعي مالم اكتسبه من خلال عشرات الدورات الدولية وذلك طبعا بفضل الله أولا وببركة القرآن الكريم .
الفكرة العامة للتطبيق :
كانت الفكرة باختصار هي انشاء تطبيق مميز وتفاعلي Interactive للقرآن الكريم بطريقة مبتكرة ويشجع المستخدم النهائي على تحسين مهاراته في القرآن الكريم : سواء في الحفظ أو اتقان التجويد ومخارج الحروف وباستخدام أحدث أدوات الذكاء الاصطناعي المتوفرة .
طبعا قد يتساءل البعض " ما الجديد في الموضوع " ، الانترنت فيه العشرات من التطبيقات التي تناولت اكثر من خدمة للقرآن الكريم : مثل عرض الصفحات بأكثر من طريقة والتفسير بأكثر من لغة ..الخ
الجواب اني لم اجد أي تطبيق متكامل يتفاعل مع المستخدم في الوقت الحقيقي Real-time وبسرعة latency مقبولة ويقوم بالتصحيح للأخطاء التجويدية "ان صح التعبير عنه" فورا ويتفاعل ويشجع المستخدم ويتابعه بطريقة مبتكرة وموثوقة في نفس الوقت . ومن هنا جاءت فكرة تطبيق "متنافسون" والذي يقوم بالآتي :
- يقوم بالتصحيح لأخطاء قراءة القرآن الكريم لحظيا : سواء التجويد او مخارج الحروف بدقة مقبولة ( قابلة للتحسين باستمرار ) .
- يقوم بتوليد اختبارات جميلة مبتكرة لتثبيت الحفظ واتقان التجويد مع إعطاء درجات Score لكل جلسة: وتشجيع المستخدم باستمرار للمتابعة .
- يمكن المستخدم من تحدي شخص آخر بإرسال كود مشاركة وانشاء غرف للمنافسة ، ويقوم التطبيق بتوليد اختبارات لهذا التحدي وتحديد درجة لكل منافس .
- انشاء لوحة Leaderboard لكل المتنافسين مع تحديد المراكز الأولى . لغرض التشجيع باستمرار.
و كان تركيزي كان على لب الموضوع وهو تجهيز الـ Backend وبالتحديد : ميزة تصحيح أخطاء التجويد ومخارج الحروف لحظيا Real-Time وبدقة مقبولة ، وهي الميزة التي استهلكت تقريبا كل وقتي وجهدي وما زلت أحاول تحسينها .
محطات التطوير للتطبيق :
أولا : قبل التطور الكبير في نماذج LLM ووكلاء الذكاء الاصطناعي منذ حوالي 8 اشهر تقريبا :
حتى لا أطيل عليكم سوف اختصر اهم النقاط في هذه المحطة ( والتي كانت معظمها تدور حول كيفية تعليم التطبيق تصحيح التلاوة لحظيا ) :
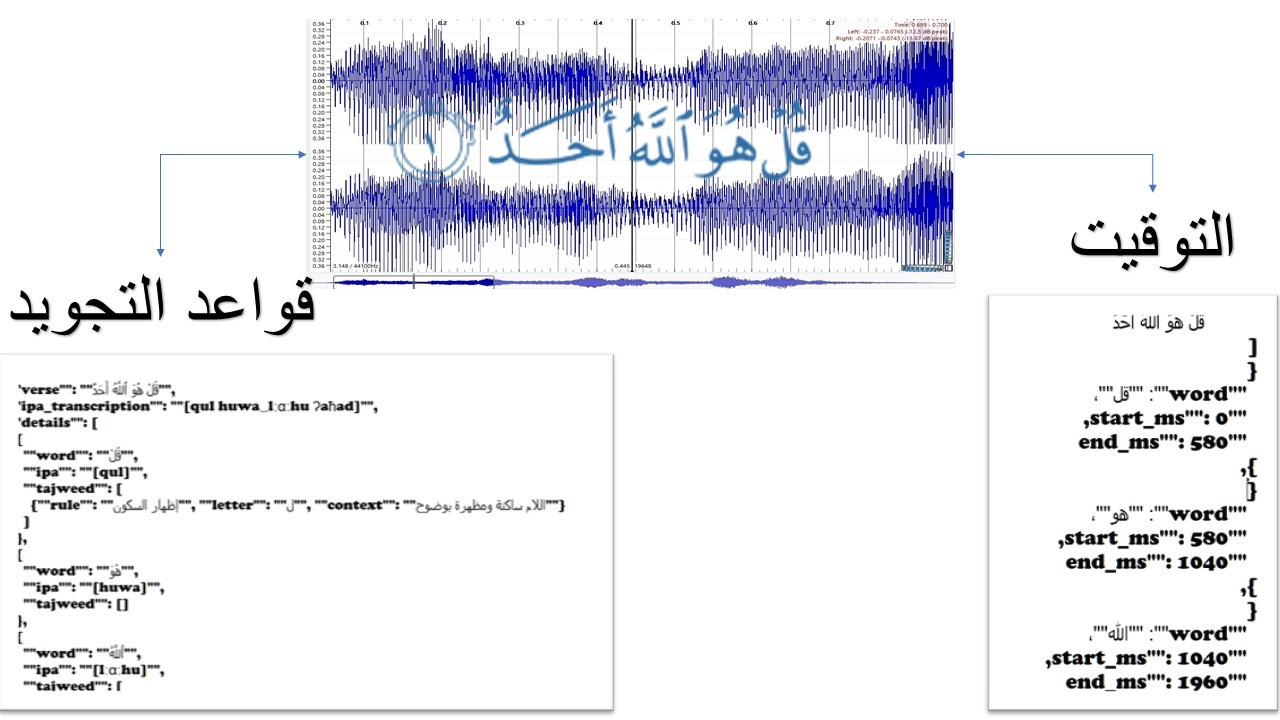
• تجهيز Dataset متكاملة : عكفت على تطوير أكثر من آلية لبناء dataset تجمع بين نصوص القرآن بالرسم العثماني ( قراءة حفص المشهورة ) و النطق الحرفي لها Transliteration بالصيغة العالمية IPA مع محاولة إيجاد طريقة لتعديل هذه الصيغة بما يتناسب مع قواعد التجويد والتشكيل الأساسي للكلمات في القرآن الكريم مع أيضا روابط صوتية لقراء معروفين للمطابقة الصوتية مع الصيغة العالمية IPA . حيث تم استخدام اكثر من نموذج LLM للتأكد من دقة البيانات وتحويل الصوت للقراء الى نص STT ولا أخفيكم ان هذه العملية وحدها كانت صعبة جدا في ذلك الوقت . والصورة أدناه توضح ملامح قاعدة البيانات التي أنشأتها .
• محاولة إعادة ضبط نماذج صوتية TTS مختلفة : وذلك للتفاعل مع المستخدم بالصوت والنص كلاهما او حسب اختياره . وتم اختيار مجموعة جزئية من الـ Dataset للقيام بهذه المهمة والتي للأسف لم تنجح لعدة أسباب يطول شرحها .
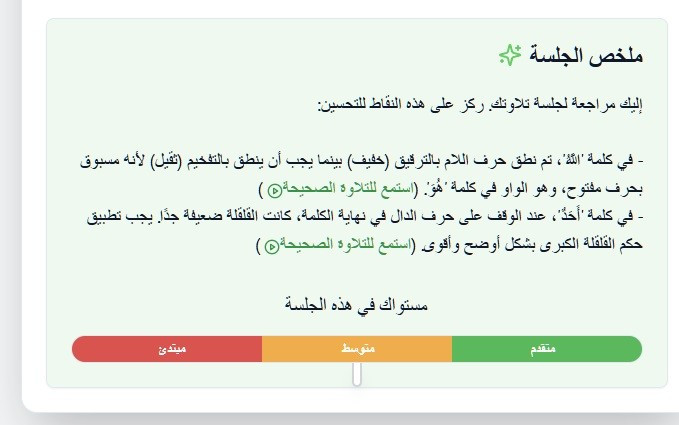
• محاولة استخدام الـ Function Calling مع هندسة التلقين Prompt Engineering لتعليم بعض النماذج القوية المشهورة من شركات OpenAI وقوقل : وكانت النتيجة بفضل الله ظهور اول تطبيق Prototype كما في الصورة أدناه ، يستطيع في الوقت الحقيقي تصحيح الأخطاء التجويدية بدقة نوعا ما مقبولة . مع وجود أخطاء Bugs قليلة تخص مكتبات التطبيق وغير مهمة .
ثانيا : بعد التطور الهائل في مجال وكلاء الذكاء الاصطناعي وادواته :
وكان هذا بعد توقف للمشروع استمر لعدة اشهر ، حيث قررت أن استخدم أكثر من طريقة مبتكرة لتطوير المشروع بالاستفادة من الـ Frameworks الجديدة لوكلاء الذكاء الاصطناعي والأدوات التي وفرت لي الكثير من الوقت والجهد ، والتركيز كان على الـ Multi_Agents وما يتبعها من تطورات موازية مذهلة للأدوات مثل الـ Skills والـ Reasoning القوية جدا وظهور الجيل الجديد من الوكلاء الذاتيين Autonomous Agents والذي غير قواعد تطوير وإعادة ضبط نماذج LLMs.
• إعادة هيكلة تصميم التطبيق : بعد دراسة متعمقة لقدرات بعض النماذج القوية والتي تتمتع بتفكير منطقي منظم Reasoning تم اختيار نموذج Gemini 2.5 pro وذلك لقدرته المذهلة في التفكير المنظم وإمكانية التحكم بقوة التفكير عبر معاملات Thinking_Budget والذي اثبت قدرته على التعامل مع هذه المهمة بتفوق ملحوظ مقارنة بجميع النماذج الأخرى من شركات مثل Anthropic أو OpenAI . وكانت إعادة الهيكلة تشمل تغييرات جذرية مثل :
o استخدام الـ Context_Caching لتحميل كل بيانات قواعد التجويد دفعة واحدة للنموذج ( مما يعني الاستغناء عن RAG او أي اعتماد على مصادر خارجية )
o استخدام Prompt Engineering + Context Engineering لضبط دقة تعامل النموذج مع قواعد التجويد ومخارج الحروف والتشكيل وخاصة الحروف المقطعة .
o الاستغناء عن نماذج STT + TTS للقيام بالتفاعل اللحظي ، واستبدالها بنموذج gemini-2.5-flash-native-audio وهو الجيل الجديد من النماذج التي تتعامل الصوت لحظيا Real-time .
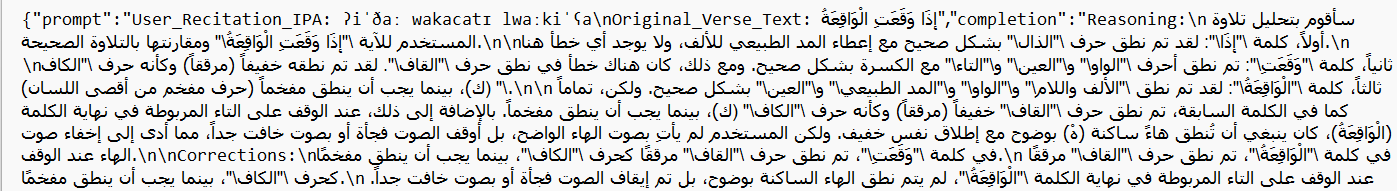
o استخلاص مخرجات النموذج القوي Gemini وطريقة تفكيره ( بطريقة مشابهة للـ Distillation ) لإعادة استخدامها في تدريب نماذج صغيرة SLM أخرى في المستقبل أو لعمل اطار RL لنفس التطبيق . والصورة أدناه توضح مثال للمستخرجات بصيغة JSON .
• تصميم Framework مبتكر لإعادة ضبط نماذج SLM قوية : محاولة إعادة ضبط نماذج صغيرة وقوية مثل Gemma 4 أو QWEN بانشاء اطار عمل قوي جدا يحسن نفسه باستمرار ( قد يطول شرح هذه النقطة قليلا ) للاطلاع على بعض تفاصيلها يرجى مراجعة الـ Post على الرابط :
[https://www.linkedin.com/posts/%D9%85%D8%AD%D9%85%D8%AF-%D8%A8%D8%B1%D9%86%D9%8A%D8%A9-4b770a132_aehaepaetabraepaesaeyaeraepaejabraepaesaepaedaefaeuaepaehaey-ugcPost-7475694117994283008-IQwI/?utm_source=share&utm_medium=member_desktop&rcm=ACoAACB_OksB4RTvbv-dW9o4pqe62D8j5J1I3kk](https://)
والفكرة الأساسية هي محاولة استخدام الـ Autonomous Agents مع بعض الأدوات القوية من شركات مختلفة ودمجها في اطار Framework واحد يحسن نفسه باستمرار وبدقة ممتازة ، لتدريب نماذج يمكن استخدامها في التطبيق وبدقة افضل .
وانا حاليا مازلت أحاول التقاط أي تحسين او تطوير للنماذج القوية الحالية أو أدوات الذكاء الاصطناعي والتي قد تخدمني بأي طريقة لتحسين دقة ميزة التصحيح اللحظي ( والتي اعتبرها هي الأساس في التطبيق ) وأسأل الله العون والتوفيق في هذه الرحلة .
ولا يفوتني أن أقول انني فعلا استفدت حاليا بعد انضمامي لمجتمع اتقان من بعض التجارب والمصادر الجميلة في الموقع وخاصة مشروع المعلم القرآني Quran Muaalem المتميز . والذي اخطط ان استفيد واتعلم من بعض ميزاته ان شاء الله .
وأعتذر على الاطالة وأتمنى ان تكون بعض محطات هذه الرحلة مفيدة للجميع ( وان كان التطبيق لم يكتمل للآن )
