وصف الميزة: يضيف هذا المستند توثيقًا كاملًا لميزة البحث الدلالي
(Semantic Search) التجريبية في تطبيق المصحف، وهي طبقة بحثٍ تفهم معنى
استعلام المستخدم لا لفظه فحسب، فتُرجِع آياتٍ متصلة بالمعنى حتى لو لم
ترد ألفاظ الاستعلام في النصّ القرآني حرفيًّا. يشرح المستند التقنية
المعتمدة، ودواعي اختيارها، وبنية قاعدة البيانات المتجهية للقرآن
وتفسيره، وسبب اختيار النموذج، ودعم المنصات، مع أمثلة عملية على
الاستعلامات للمستخدم النهائي.
التجربة الحية: open-mushaf-native--ai-preview-llyoepcn.web.app (صالح حتى 2026-09-05)
الفرع (Branch): open-mushaf-native--ai-preview-llyoepcn.web.app (صالح حتى 2026-09-05)
1. نظرة عامة على الميزة
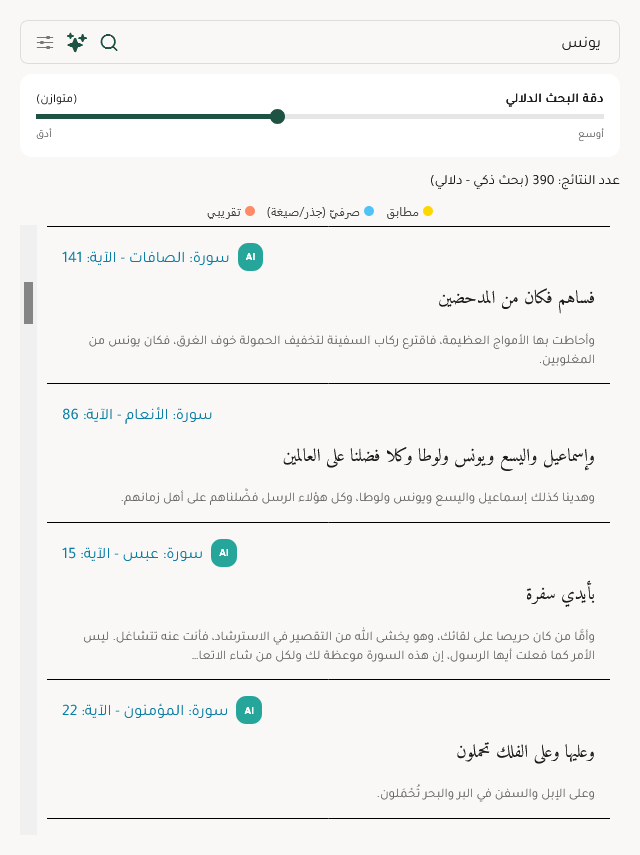
يضيف تبويب «بالذكاء الاصطناعي» في صفحة البحث طبقةً من البحث الدلالي
فوق البحث النصي الحرفي. فبدلًا من مطابقة الألفاظ حرفيًّا، يفهم النموذج
دلالة الاستعلام ويحوّله إلى متجهٍ عدديّ (Vector) ثم يقارنه بمتجهات
الآيات.
والحصيلة بحثٌ بالمعنى؛ إذ يستطيع المستخدم أن يطرح عبارةً لم تَرِد في
النص القرآني حرفيًّا، فيُرجَع إليه الآيات المتعلقة بدلالتها.
2. التقنية المعتمدة ودواعي اختيارها
2.1 البنية العامة: بحث هجين (Hybrid Search)
الاستعلام (Query)
   │
   ├── المسار النصي (Keyword Path) ── نشط دائمًا، مدمج في التطبيق
   │        محرّك quran-search-engine
   │
   └── المسار الدلالي (Dense Path) ── يتطلب توافر النموذج
            نموذج التضمين ATM-V2 → المتجه → المقارنة مع الفهرس المتجهي
   │
   ▼
  دمج النتائج (RRF)
يقوم البحث على مسارين متكاملين:
- المسار النصي (Keyword): دقيقٌ وسريع، ويعمل بلا اتصال، غير أنه لا
يُرجِع إلا الألفاظ الواردة حرفيًّا.
- المسار الدلالي (Dense): يفهم المعنى والمرادفات والتعابير، لكنه
يحتاج تحميل النموذج، وأداؤه أوضح على المعنى منه على الحرف.
لماذا الدمج؟ كلّ مسارٍ وحده قاصر: النصي لا يُدرك عبارةً مثل «كيف أتوب
من ذنوبي» لأن كلماتها غير واردة في النص، والدلالي قد يغفل عن الآية الحرفية
الدقيقة. وأما الدمج عبر RRF فيرتفع بالنتائج المتوافقة بين القائمتين،
ويضيف إلى النتائج ما انفرد به كل مسار.
2.2 خط سير المسار الدلالي
- البناء (Build-time): تُمرَّر كل آيةٍ مقرونةً بتفسيرها على نموذج
التضمين، فيُخرَج متجهٌ من 768 بُعدًا، ثم تُعالَج المتجهات بتقنية
المتوسط الموزون (Mean Pooling) والتطبيع على معيار لام-2
(L2 Normalization)، ثم تُكمَّم (Quantization) إلى أعداد صحيحة
(Int8، بعامل 127) وتُحفَظ في ملفّ quran_vectors.bin.
- الاستعلام (Runtime): يُضمَّن الاستعلام بالنموذج نفسه وبنفس خطوات
المعالجة، فيُنتَج متجهٌ من 768 بُعدًا.
- المقارنة: تُحسَب درجة تشابه جيب التمام (Cosine Similarity) بمسح
خطّي كامل على الآيات جميعًا (6236 × 768 ≈ 4.8 مليون عملية ضرب وجمع، أي
نحو 30-60 ميلي ثانية على الأجهزة المتوسطة).
- الانتقاء: تُستعمل خوارزمية النسبة المئوية Top-K؛ إذ يُبقى على
نحو 2% من الآيات (أي ما يقارب 125 آية من أصل 6236) بغضّ النظر عن القيمة
المطلقة للتشابه.
2.3 لماذا النسبة المئوية (Percentile Top-K) دون عتبة مطلقة؟
كانت التجربة السابقة تعتمد عتبةً مطلقة (MIN_COSINE_SCORE = 0.45)
تُسقِط أيّ نتيجةٍ دون هذا الحدّ. غير أنّ درجات النموذج الفعلية للاستعلامات
القصيرة (كأسماء الأنبياء مثلًا) تتراوح بين 0.25 و 0.48؛ فكانت العتبة
تحذف النتائج الصحيحة كلّها، حتى صار البحث عن «يونس» يعيد صفرَ نتيجة.
فكان الحلّ الاعتمادَ على النسبة المئوية: نُبقي أفضل 2% من الآيات مهما كانت
درجاتها، مع عتبةِ ضوضاءَ منخفضةٍ (0.12، وهي نحو ثلاثة انحرافاتٍ معيارية
فوق الضجيج العشوائي لفضاءٍ ذي 768 بُعدًا) لاستبعاد ما لا صلة له بالاستعلام
أصلًا.
2.4 لماذا لا نستخدم البادئات (query: / passage:)
نموذج ATM-V2 ليس من عائلة E5؛ إذ تستخدم بطاقته الرسمية دالة encode()
مباشرةً دون بادئات. وإضافةُ بادئةٍ إلى طرفٍ واحدٍ فقط (كأن تُضمَّن الآيات
ببادئةٍ دون الاستعلام، أو العكس) تُفسد توافق الفضاء المتجهي. لذلك جرى
اعتماد مبدأ: لا بادئات إطلاقًا، والاستعلام والآيات في فضاءٍ واحد
متطابق.
2.5 لماذا RRF؟
صيغة الدمج القياسية (Cormack et al. 2009) بالثابت k = 60:
score(d) = Σ 1 / (60 + rank_i)
أي أنّ النتيجة التي تظهر في المرتبة الأولى لأيّ مسارٍ تحصل على 1/61، وتتناقص
القيمة سريعًا مع الترتيب. وبهذا تتصدّر الآيات الحرفية الدقيقة، ثم تُدرَج
الآيات الدلالية ذات الصلة بأوزانٍ أقل، دون الحاجة إلى معايرةٍ يدويةٍ للدرجات
المتباينة بين المسارين.
3. استراتيجية قاعدة البيانات المتجهية للقرآن والتفسير
لا تُخزَّن كل آيةٍ منفردةً، بل مقرونةً بتفسيرها (تفسير الميسّر) على
الوجه الآتي:
"{نصّ الآية} | تفسير: {نصّ التفسير}"
والعلّة أنّ النموذج نُشِّئ على فهم النصّ بلغةٍ معاصرة. فالتفسير:
- يرفع درجة التشابه مع الاستعلامات الدلالية والتفسيرية.
- ويُمكّن البحثَ من إرجاع مقاطعَ موضوعية (كمفهوم «التوبة») حتى لو لم تتضمّن
ألفاظُ الآية الكلمةَ المبحوث عنها.
أما الملفات الناتجة فهي:
quran_vectors.bin — نحو 4.7 MB، متجهات Int8 بشكل صفوف 6236 × 768.quran_vectors_meta.json — نحو 2.5 MB، بيانات الآيات (gid, sura_id,
aya_id, النصّ).
تنسيق الملفّ الثنائي
- ترتيب البايتات: little-endian (متوافق مع معماريات ARM و iOS و
Android و x64).
- نوع البيانات:
int8 موقّع.
- الشكل:
(6236, 768) صفًّا تلو صفّ، وكلّ صفّ يقابل آيةً بترتيب gid.
- إعادة الحساب:
cosine = dot(q, r) / 127.
أداة البناء
yarn build:vectors # → python scripts/build_vectors.py
وتتحقق الأداة أولًا من توافر الملفات والنموذج قبل البدء، ثم تشفّر الآيات
وتُنتج الملفّين المضمّنين في المستودع.
4. اختيار النموذج
النموذج المعتمد هو
Omartificial-Intelligence-Space/Arabic-Triplet-Matryoshka-V2،
وأبرز خصائصه:
- النموذج الأساس: AraBERT v02.
- الأبعاد: 768.
- عدد المعاملات: نحو 135 مليونًا.
- الترخيص: Apache-2.0.
- بيانات التدريب: 558 ألف ثلاثيةٍ عربية (NLI) مع دالة MatryoshkaLoss.
- الورقة البحثية: GATE (arXiv:2505.24581).
ومسوّغات اختياره:
- ترخيصٌ نظيف (Apache-2.0) — وهو ما يلزم لسوقَي App Store و Play Store.
- حجمٌ مناسب للجوال — نحو 135 MB في صيغة INT8، يُنزَّل مرةً واحدة ثم
يعمل دون اتصال.
- أفضل أداءٍ عربيٍّ في فئته — درجة 0.85 على مقياس STS17 و 0.64 على
STS22.v2، أي بمتوسط 74.5 على التشابه الدلالي العربي.
- تفوّقٌ على Muffakir في قياساتنا — فنسخة Muffakir الأولى بلا ملفّ
ترخيصٍ (مخاطرةٌ تجارية)، والثانية بعدّاد 568 مليون معاملٍ (نحو 370 MB)
أضخمُ من أن يُحمَّل على الجوال.
ملاحظة تشغيل: النموذج غير مضمّن في التطبيق؛ يُنزَّل عند أول استخدام
من Hugging Face Hub ثم يُعاد استخدامه من التخزين المحلي.
4.1 التكميم إلى ONNX للعمل دون اتصال
النموذج الأصلي بصيغته الأصلية غير صالحٍ للتشغيل على الجوال أو المتصفح
دون اتصال، فجرى تكميمه (Quantization) إلى صيغة ONNX بدقة Int8، وهي
الصيغة التي تتيح تشغيله محليًّا بعد أول تنزيل، سواء عبر
onnxruntime-react-native على iOS و Android، أو عبر transformers.js
على الويب.
وقد أُضيفت سكربتاتٌ مخصّصة (scripts/convert_onnx.py و
scripts/build-model.ts) لإعادة إنتاج عملية التحويل والتكميم من النموذج
الأصلي إلى صيغة ONNX، بحيث يمكن لأيّ مطوّرٍ أن يُعيد بناء النسخة المحلية
من الصفر دون الاعتماد على نسخةٍ جاهزةٍ فحسب.
أما نتيجة هذا التحويل فمُستضافةٌ على Hugging Face في مستودعين:
5. دعم المنصات
تعمل الميزة على المنصات الثلاث، غير أنّ آلية تشغيل النموذج تختلف:
iOS / Android: عبر onnxruntime-react-native؛ يُنزَّل عند أول
استخدام أربعة ملفاتٍ من adelpro/atm-v2-int8-onnx مع شريط تقدم، ثم
يُستخدم الملفّ المحليّ على القرص، فيعمل دون اتصال بعد ذلك.
الويب (PWA): عبر transformers.js (WASM) من خلال jsDelivr؛ يُحمَّل
عند أول استخدام نموذج q8 من adelpro/atm-v2-web إلى ذاكرة Cache
Storage، ثم يُقرأ من ذاكرة المتصفح بعد ذلك.
التطبيق المحلي: لا يوجد مجلد ios/؛ فالمشروع بنمط Managed، وكل
الإعدادات في app.json عند تنفيذ expo prebuild.
إعادة التعيين: الإعدادات ← «إعادة تعيين البحث الذكي»، وتحذف هذه
الخيار النموذجَ المحليّ أو ذاكرة الكاش وتُنزّله من جديد.
حالة الاختبار الحالية
لم يُختبر حتى الآن إلا على الويب. فمسار الويب يعمل بمراحله كاملةً
(تحميل النموذج، التضمين، البحث). وأمّا المسار المحلي (Native) فهو مبنيٌّ
على المنطق نفسه والفهارس نفسها، لكن يلزم التحقق منه على جهازٍ حقيقيّ قبل
الاعتماد عليه في الإصدار التجريبي.
6. كيف يستخدم المستخدم النهائي الميزة؟
- افتح صفحة البحث
/search.
- انتقل إلى التبويب «بالذكاء الاصطناعي».
- عند أول استخدام يُطلَب تحميل النموذج (نحو 135 MB) ويظهر شريط تقدم أزرق؛
وبعد اكتمال التحميل يعمل البحث حتى دون اتصال.
- اكتب سؤالك أو عبارتك ثم ابدأ البحث.
أمثلة على استعلامات تُبرز قدرة الميزة
الأسماء والمواقف (بحث دلالي عن القصص):
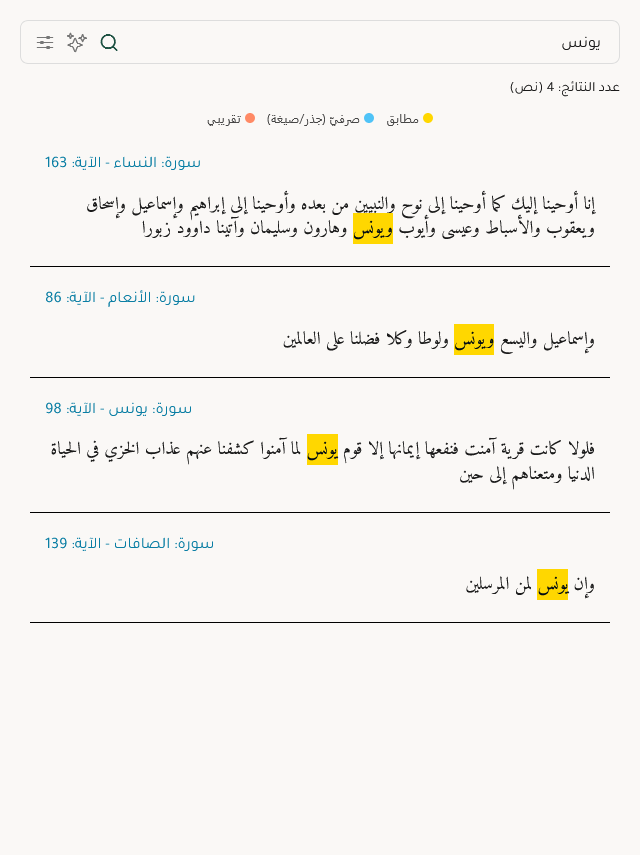
يونس → سورة الصافات 139–144 (قصة يونس عليه السلام).الحوت → آيات قصة الحوت دون أن ترد كلمة يونس حرفيًّا.موسى / نوح → آيات قصص الأنبياء.
التعابير (عبارات غير واردة حرفيًّا):
كيف أتوب من ذنوبي → آيات التوبة والاستغفار.قلبي قاسٍ لا يلين → آيات قسوة القلوب.لماذا أصابنا البلاء → آيات الابتلاء والصبر.العفو عمّن ظلمني → آيات العفو والصفح.
المعاني (مفاهيم تعبَّر عنها بألفاظ مختلفة):
الرياء → آيات الرياء والنفاق.كظم الغيظ → آيات كبح الغضب.الموت والبعث → آيات يوم القيامة.شكر النعمة → آيات الشكر.
كيف تُقيّم النتائج؟
- النتيجة الجيدة: آياتٌ صحيحةٌ موضوعيًّا وإن لم تتضمّن ألفاظَ الاستعلام،
وكونُ مصدرها المسارَ الدلالي dense (لا النصي keyword).
- النموذج ليس محرّك أسئلةٍ وأجوبة بل محرّك استرجاعٍ موضوعي؛ فالمتوقّع
«مواضيع ذات صلة»، لا «إجابة مطابقة» حرفيًّا.
- المعيار النهائي: نتائج غير صفرية وواضحة الصلة بدرجاتٍ تبلغ
نحو 0.25 فأكثر.
7. التحسينات التي أُدخلت خلال التجربة
- تصحيح عتبة التشابه — كانت العتبة المطلقة
0.45 تُسقط النتائج
الصحيحة (فكان البحث عن «يونس» يعيد صفرًا). فاستُبدلت بنسبةٍ مئوية
(DENSE_TOP_PERCENTILE = 0.02) مع عتبة ضوضاء (0.12).
- إزالة بادئات التضمين — لم يعد للاستعلام أو للآيات بادئاتٌ
(query: / passage:)؛ فالاستعلام والآيات في فضاءٍ واحدٍ متطابق.
- إعادة بناء الفهرس — بعد إزالة البادئات أُعيد توليد ملفّ
quran_vectors.bin على الفضاء الجديد؛ فكانت درجات آيات «يونس» بين
0.27 و 0.31، فأصبحت بين 0.44 و 0.48.
- سجلّ تشخيصي مشروط — سجلّ DIAG يعرض أعلى خمس درجاتٍ خامٍ لكل
استعلام، ولا يُفعَّل إلا عند ضبط EXPO_PUBLIC_DEBUG=true.
8. خلاصة التجربة: البحث بالمعنى والتعابير
الفارق الجوهري عن البحث النصي التقليدي:
البحث النصي يبحث عن الألفاظ الواردة في النصّ.
والبحث الدلالي يبحث عن المعنى، حتى لو لم يرد أيٌّ من ألفاظ السؤال
حرفيًّا في الآية.
- اكتب التعابير والعبارات كاملةً كما يتحدث بها المستخدم العادي، لا
ألفاظ القرآن حرفيًّا.
- استعلامٌ مثل «كيف أتوب من ذنوبي» — مع أنّ كلماته غير واردة في النصّ
— يُرجِع آيات التوبة والاستغفار.
- واسمٌ مثل «الحوت» يجد قصة يونس، و«الرياء» يجد آيات النفاق، و«كظم الغيظ»
يجد آيات كبح الغضب؛ كلّ ذلك بفهمِ الدلالة لا بمطابقة الألفاظ.
وهذا هو جوهر التجربة: نتائجُ تعكس المعنى الذي يقصده المستخدم، لا
الألفاظَ التي كتبها.
المراجع والملفات