السلام عليكم ورحمة الله وبركاته.
طورت تطبيق لمصحف الجماهيرية (من أشهر المصاحف الليبية في رواية قالون عن نافع) بطريقة تفاعلية حديثة، وقد وصلت فيه إلى إحداثيات دقيقة لكل آية: 6214 آية على 602 صفحة، متحقَّق منها بشريًّا وآليًّا، وتعمل داخل التطبيق.
والمطلوب الآن طبقة أدقّ فوقها: إحداثيات لكل كلمة، مرتبطة بكلمات النص في قاعدة بياناتي. وهذا ما جئت أستشيركم فيه.
أعرض أولًا ما أنجزته، لأن السؤال لا يُفهم بدونه
1. التطبيق
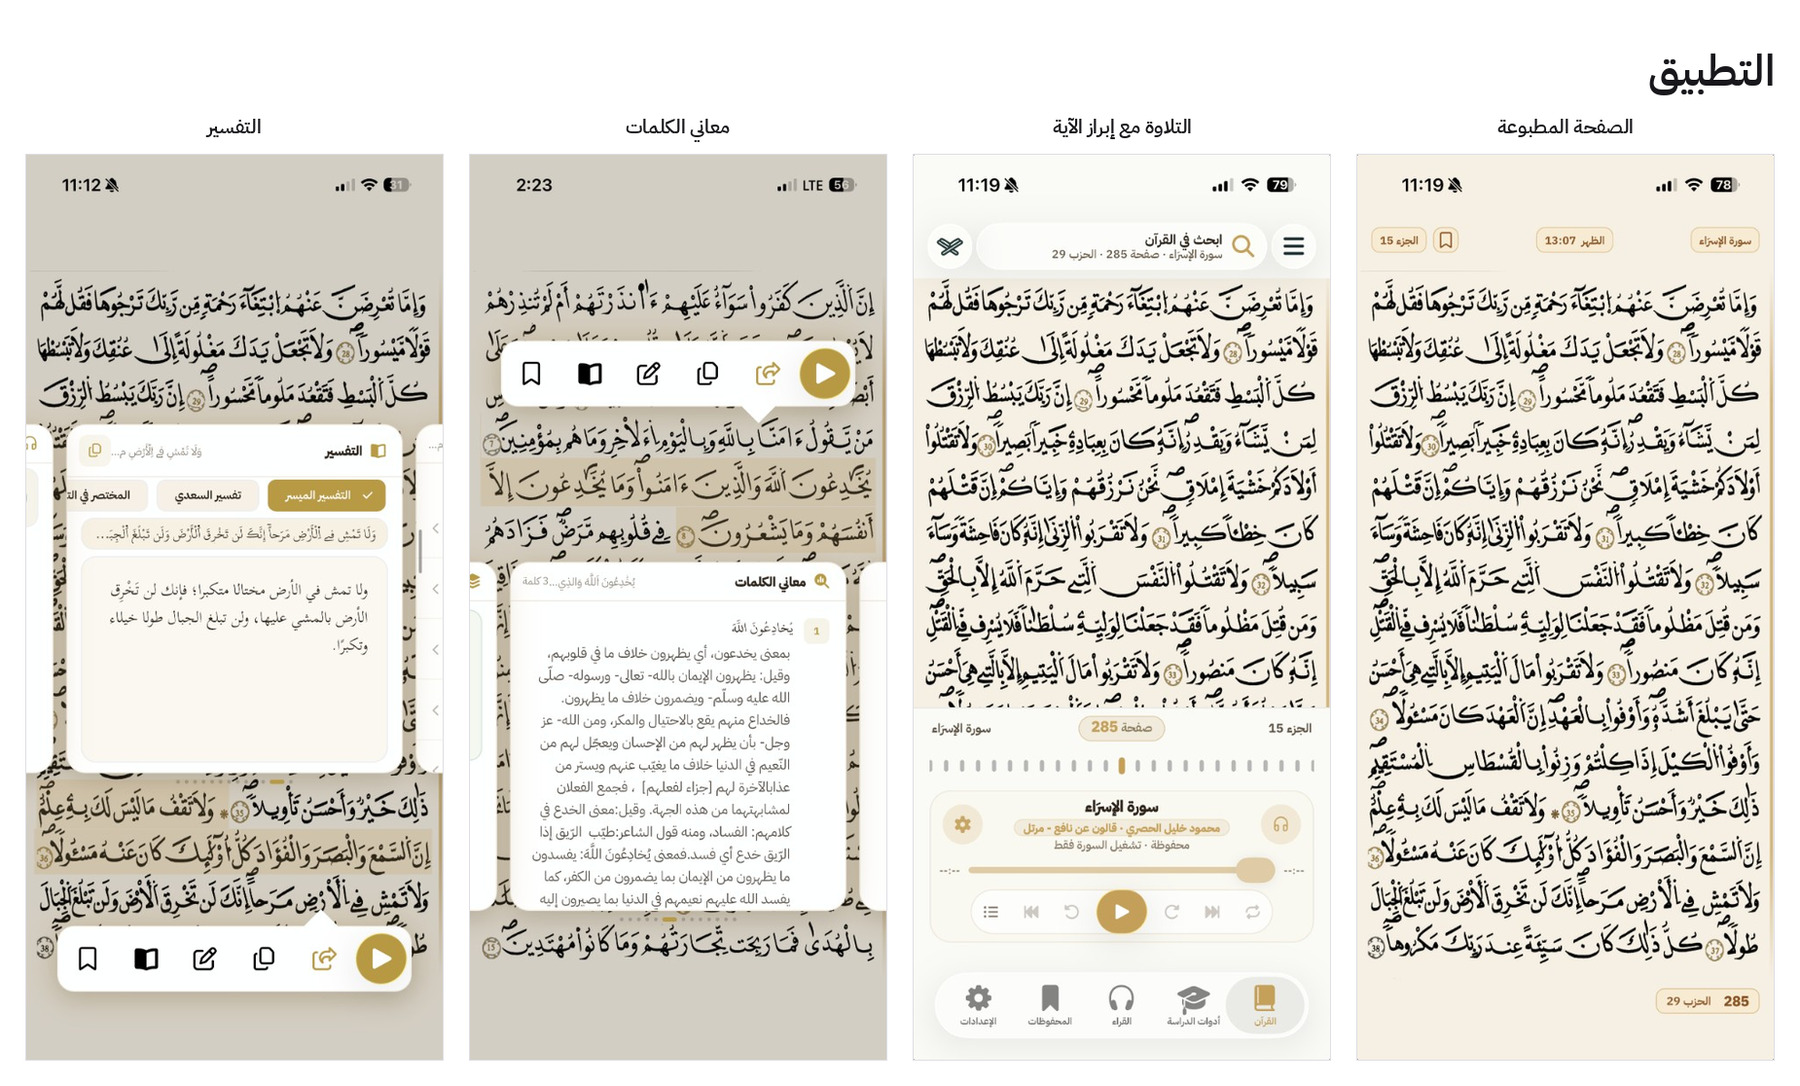
مجاني، بلا إعلانات ولا تتبّع ولا حسابات، ويعمل دون اتصال بالكامل.
فيه المصحف كاملًا بصفحاته المطبوعة مع ثماني لوحات ألوان، وتلاوات العديد من مشائخ قالون مع إبراز الآية، وبحث في النص، وكتب تفسير مضمَّنة تعمل دون اتصال، ومعاني الكلمات والإعراب والوقوف والقراءات، وختمة وورد وأدوات دراسة.
2. كيفية تجهيز المصحف
المصاحف الرقمية الجاهزة مبنية على مصحف المدينة برواية حفص، أو على خطوط مثل KFGQPC. ومصحف الجماهيرية يختلف عنها في ترقيم الآيات (توزيع مدني أول) وفي التحزيب (480 ثُمنًا) وفي الرسم والضبط ومواضع الصفحات وفي حدود الأيات نفسها أيضاً وحيث أنه لايوجد اي مصدر رقمي للتعامل مع المصحف لم يكن أمامي إلا بناؤه من صور الطبعة نفسها
3. المسح ومعالجة الصور
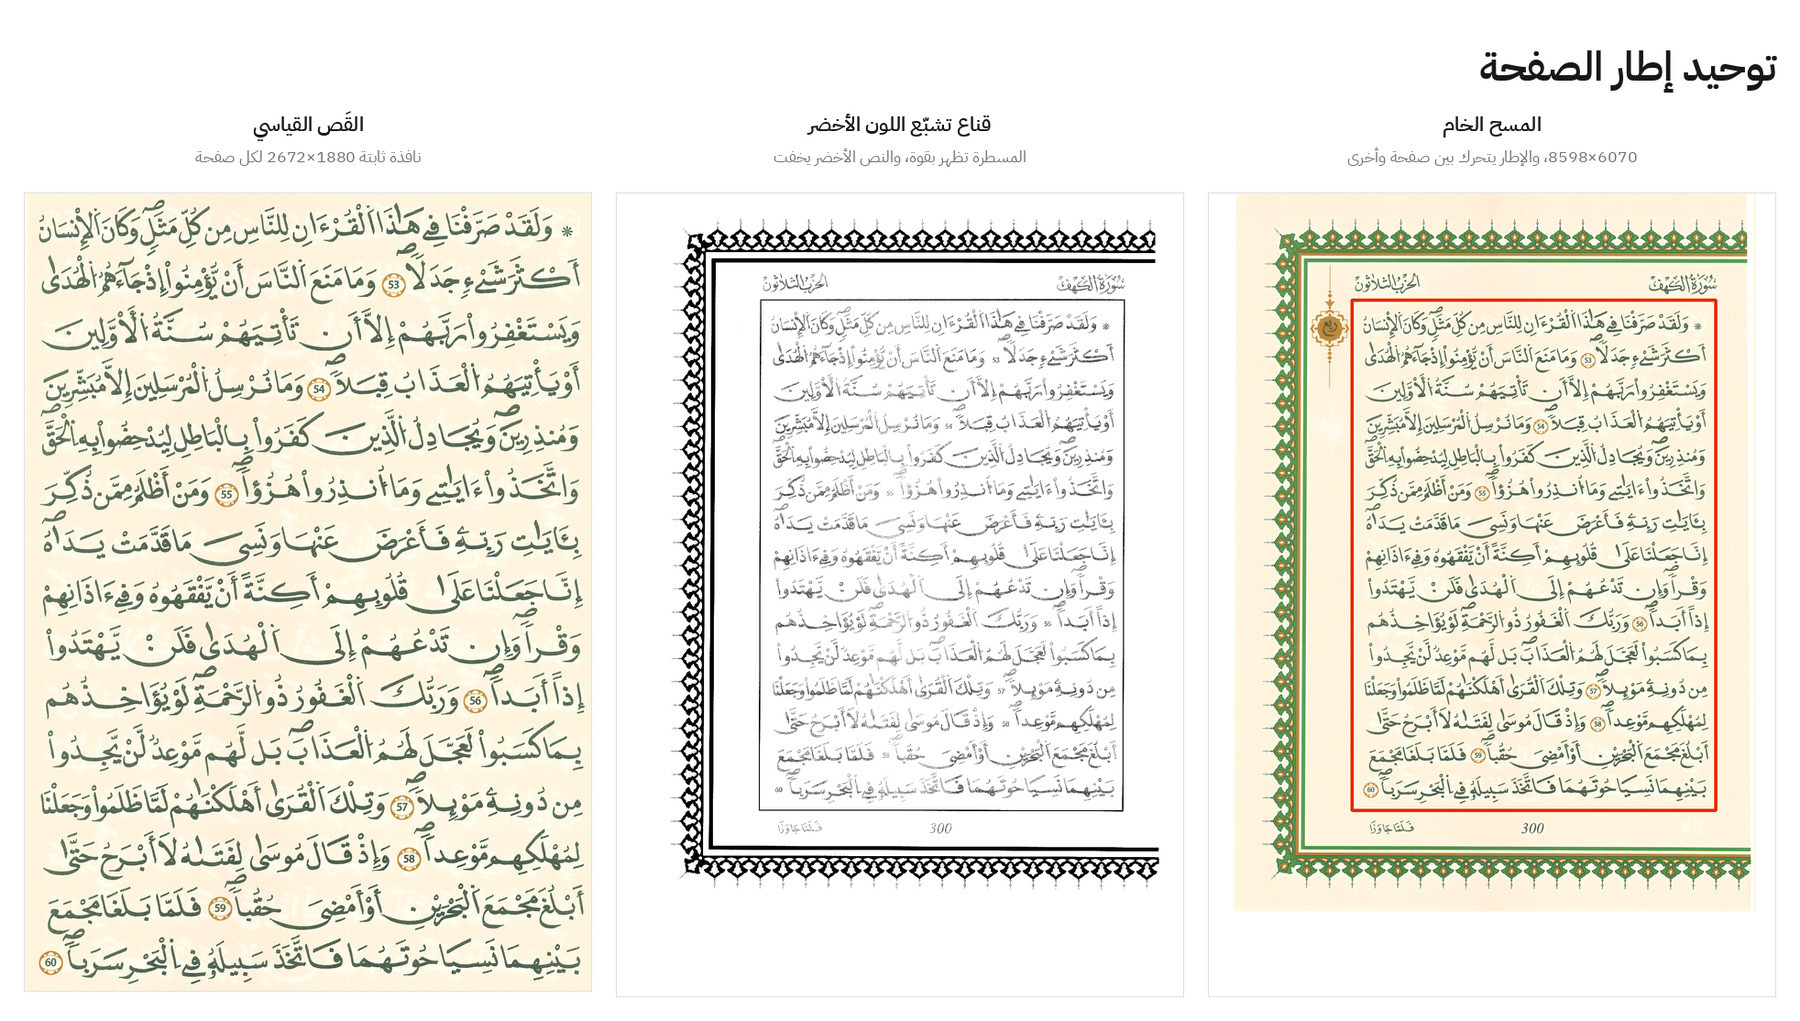
الأصل القديم كان صور طبعة 1989 بالرمادي، وهي مقفلة أمام أي استخراج والوحيدة المتوفرة في الإنترنت وجودتها ضعيفة وزد عليها أنها غير مرخصة للإستعمال فأعدت مسح الطبعة الحديثة: 623 صفحة وملف TIF بحجم 91 GB، بدقة 600 dpi وألوان حقيقية، بمقاس 6070×8598 بعد الحصول على الإذن الرسمي من جمعية الدعوة الإسلامية للعمل على المصحف.
اللون هو الفارق الجوهري، وعليه بُني كل ما بعده.
ثم وُحِّد إطار الصفحة، لأن كل الحسابات اللاحقة تقوم على لوحة واحدة. حدود النص هي المسطرة الخضراء الداخلية، والنص نفسه أخضر أيضًا، فالفصل بينهما بتشبّع اللون لا بدرجة الإضاءة: الحرف يقيس G − max(R,B) ≈ 28 والمسطرة ≈ 60. كل صفحة تُسجَّل على مسطرتها هي، وتُقصّ في نافذة ثابتة 1880×2672.
4. تحويل الصفحات إلى SVG
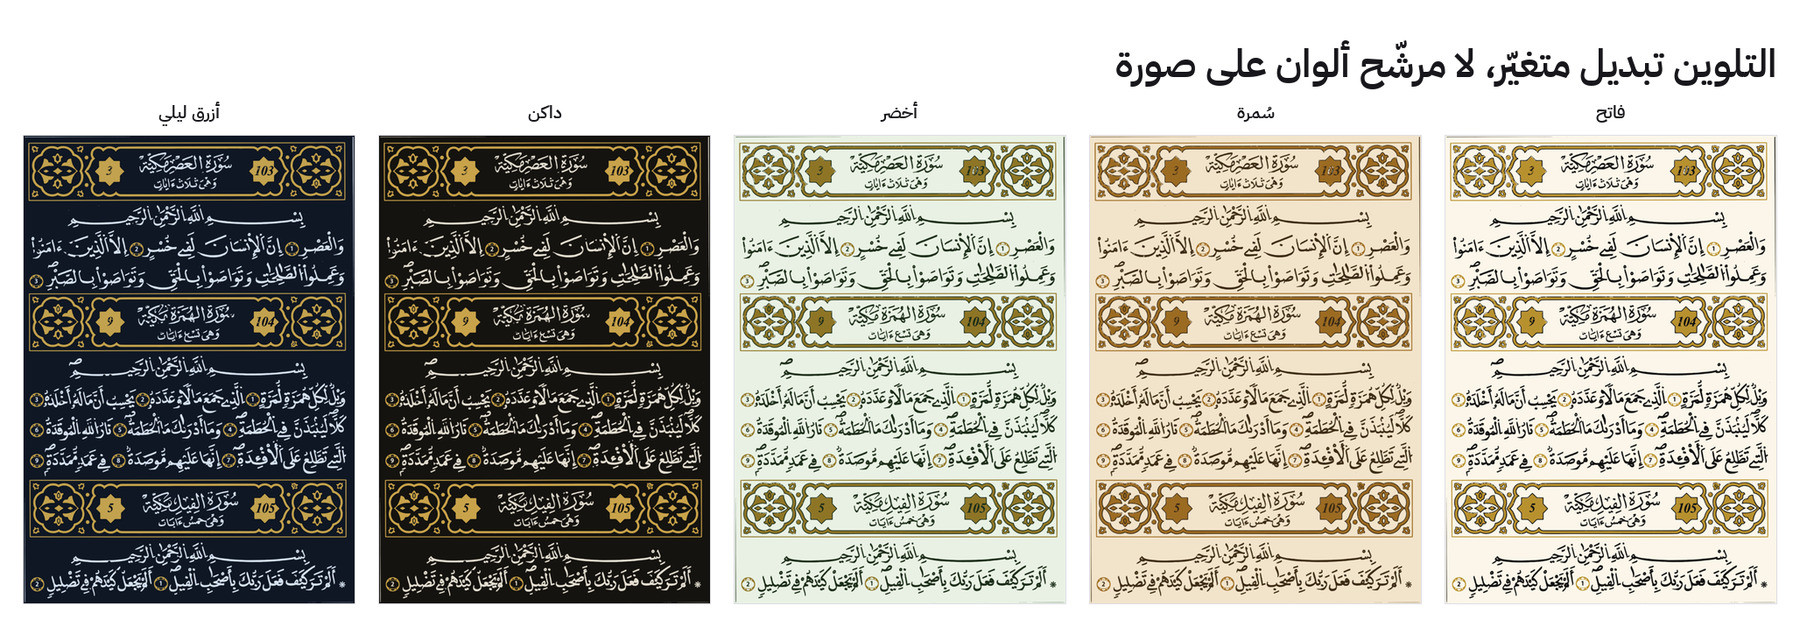
اخترت SVG لا الصور، لثلاثة أسباب: الصورة المسطَّحة لا تُلوَّن إلا بمرشِّح ألوان على الصفحة كلها، فيتحول الذهب في الوضع الليلي إلى رمادي، وثانياً لتوفير المساحة وأخيراً الدقة اللانهائية الخاصة بالـVector بشكل عام.
المسار: قصّ إلى صندوق النص، ثم Gaussian blur، ثم عتبة Otsu، ثم potrace، ثم svgo، ثم brotli. والناتج 600 صفحة متجهية بحجم 60 MB بعد الضغط.
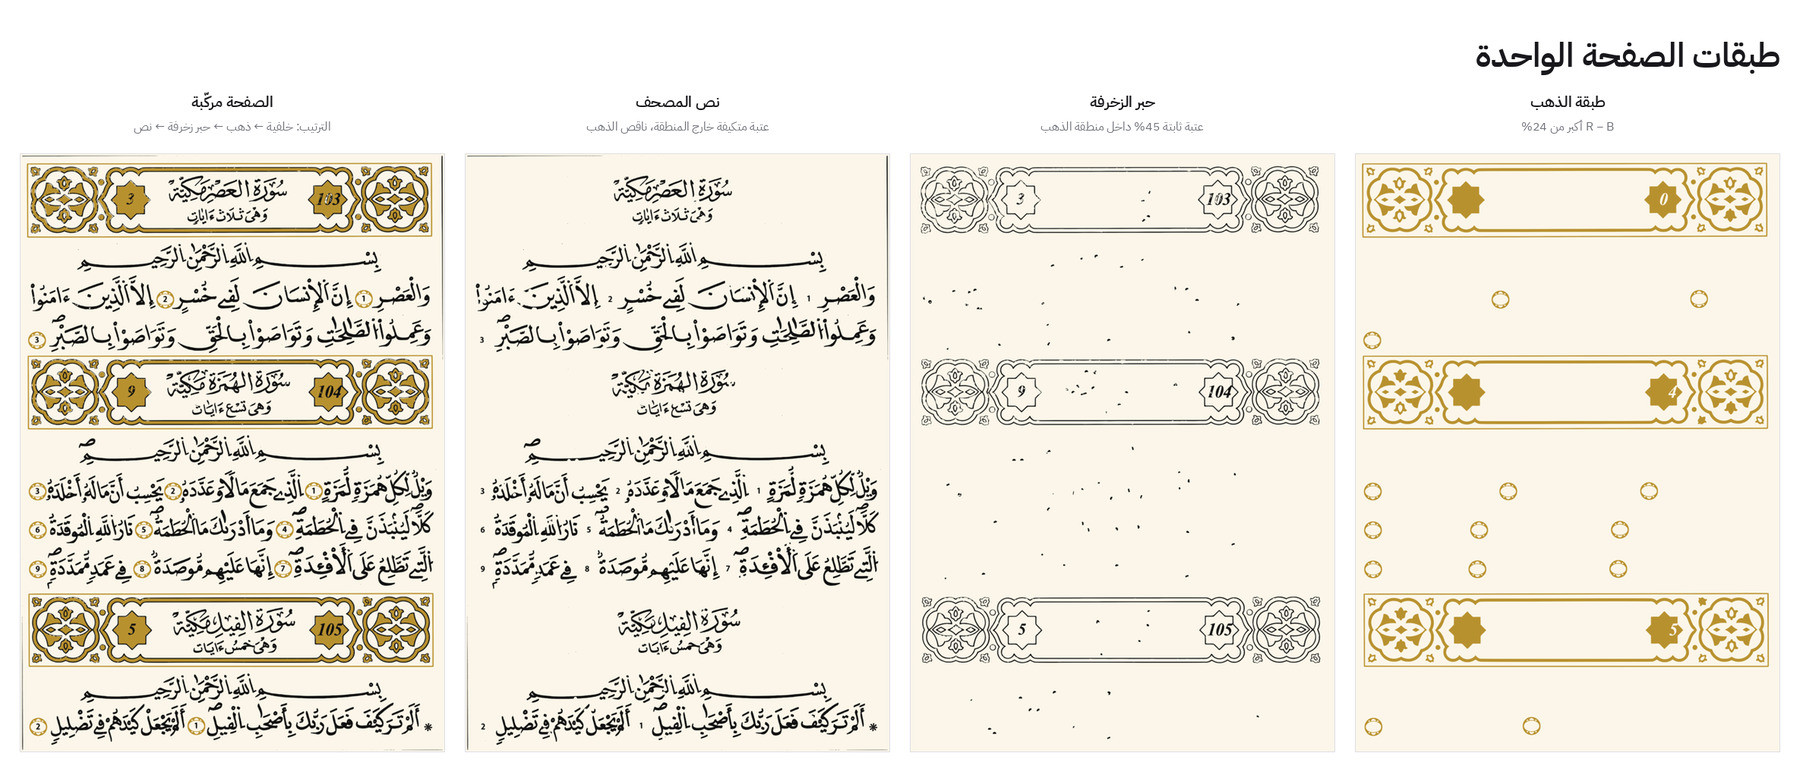
والصفحة ليست طبقة واحدة بل أربعًا:
| الطبقة | كيف تُفصَل |
|---|
| الخلفية | مستطيل واحد، لا يُتتبَّع |
| الذهب | R − B أكبر من 24% |
| حبر الزخرفة | عتبة ثابتة 45% داخل منطقة الذهب |
| نص المصحف | عتبة متكيفة خارج المنطقة، ناقص الذهب |
ولأن الطبقات منفصلة، صار التلوين تبديل قيمة لا معالجة صورة:
5. كشف علامات رأس الآية
علامة رأس الآية ذهبية والورق كريمي، وكلاهما R > B، لكن الفجوة في الذهب أوسع بكثير. فصورة الفرق R − B تفصل بينهما حيث تعجز أي عتبة على التدرج الرمادي.

بعد ذلك ثلاثة اختبارات متتابعة: الحجم، ثم تباين القرص الداخلي، ثم قراءة الرقم بـ OCR. والنتيجة 593 صفحة من 594 تطابق العدد المرجعي بالضبط، ودقة قراءة الأرقام 96.5% خامًا و99.2% بعد تصحيح التسلسل.
6. تصحيح ترقيم الآيات، وأداة المراجعة
هنا ظهرت مشكلة لم أتوقعها: النص الذي يستعمله التطبيق لم يكن مطابقًا للمطبوع.
التطبيق يعرض صور المصحف، ويستعمل في الوقت نفسه نص مجمّع الملك فهد (KFGQPC) للبحث والتفسير والصوت وربط الآية بموضعها. وحدّ الآية في الورق شيء مادي (علامة مطبوعة)، وفي النص شيء مشفَّر. وحين يختلفان يفسد كل ما يعتمد عليهما.
السبب أن التطبيق كان يعمل على توزيع مدني أخير، والمصحف مطبوع على توزيع مدني أول. ومجموع الاثنين 6214 آية، فالمجموع لا يكشف الخلل؛ لكن التوزيع يختلف في 15 سورة، مثل المزّمّل (18 مقابل 20) والشعراء (226 مقابل 227) وعبس (42 مقابل 41).
والمرجع الذي حسم الأمر هو الورق نفسه: فهرس المصحف ومجموعه 6214، وأشرطة ترويسات السور التي تطبع عدد آيات كل سورة. نسخت الفهرس كاملًا (114 سورة) وقارنته بما استخرجته، فكان الاتفاق تامًّا.
ولأني لست من أهل الاختصاص، ولا يصحّ أن أحكم وحدي على حدّ آية، بنيت أداة مراجعة على الويب وسلّمتها لمراجعين:
🔗 mushaf-review.abdeljawad.com
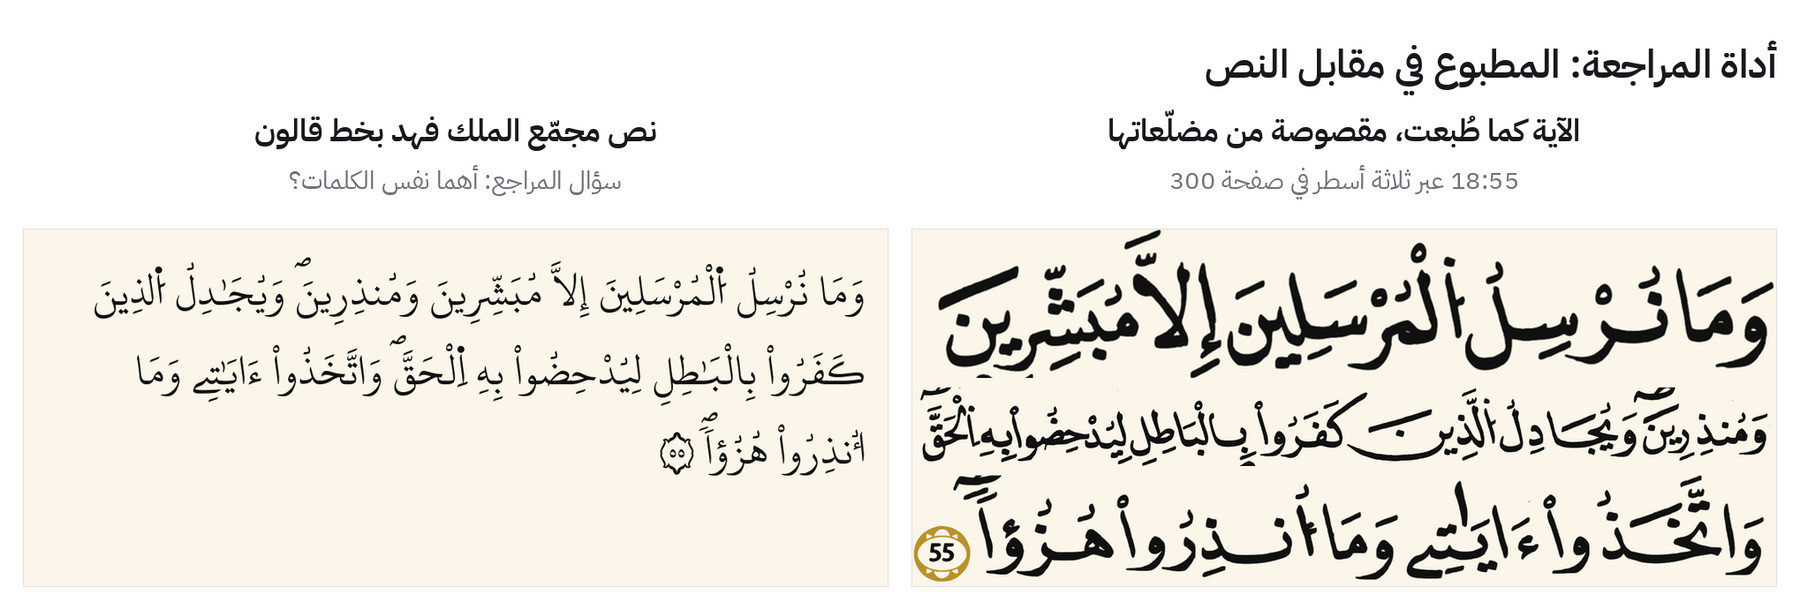
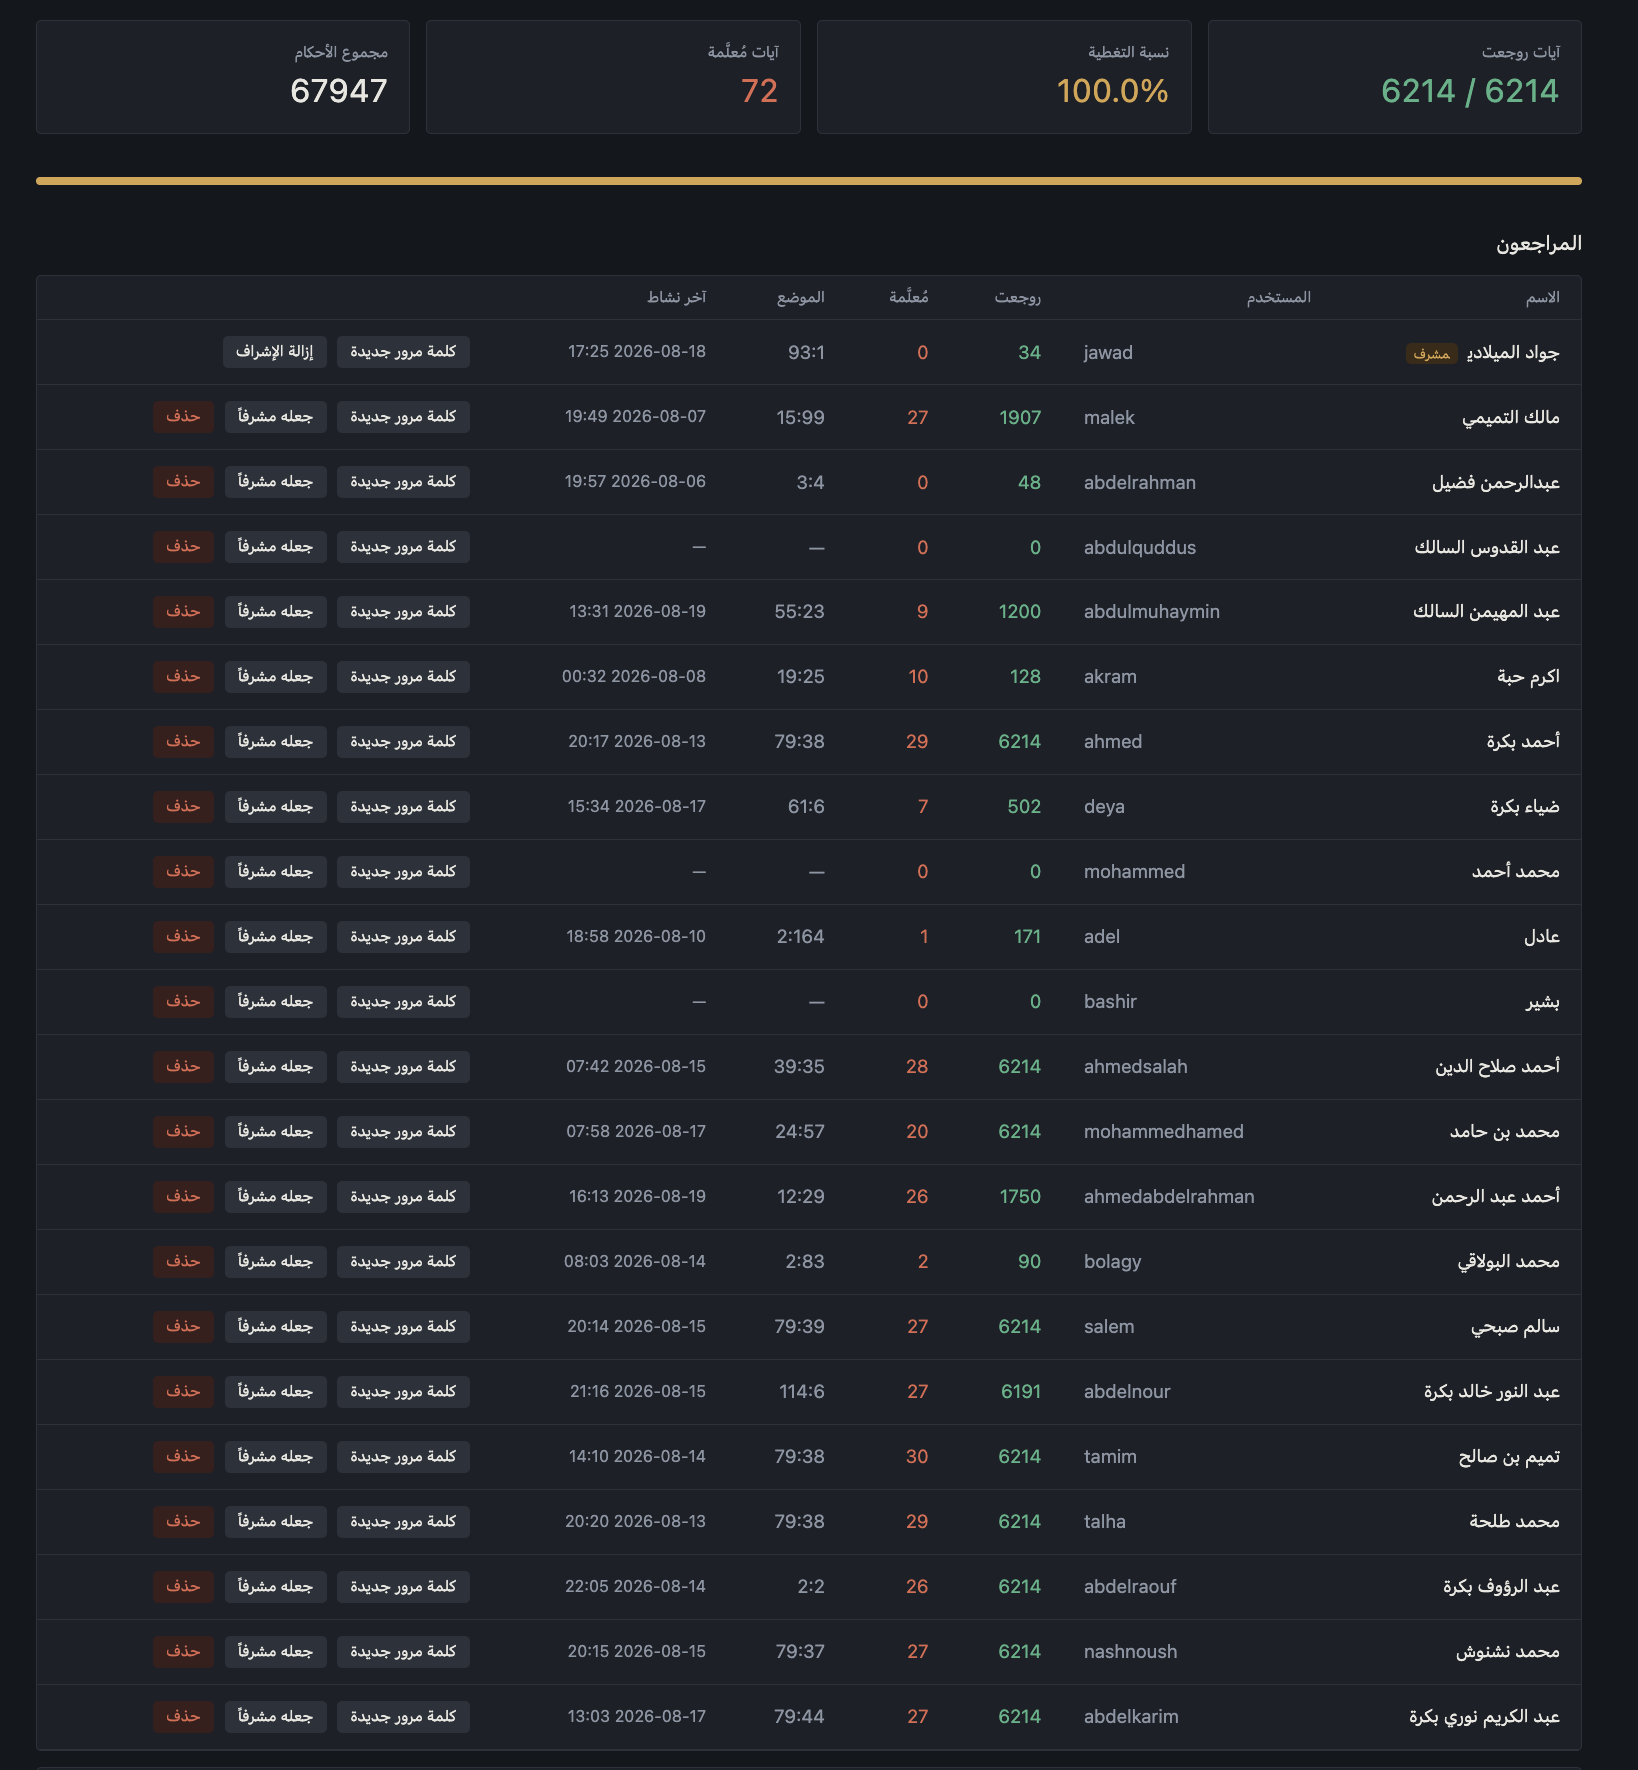
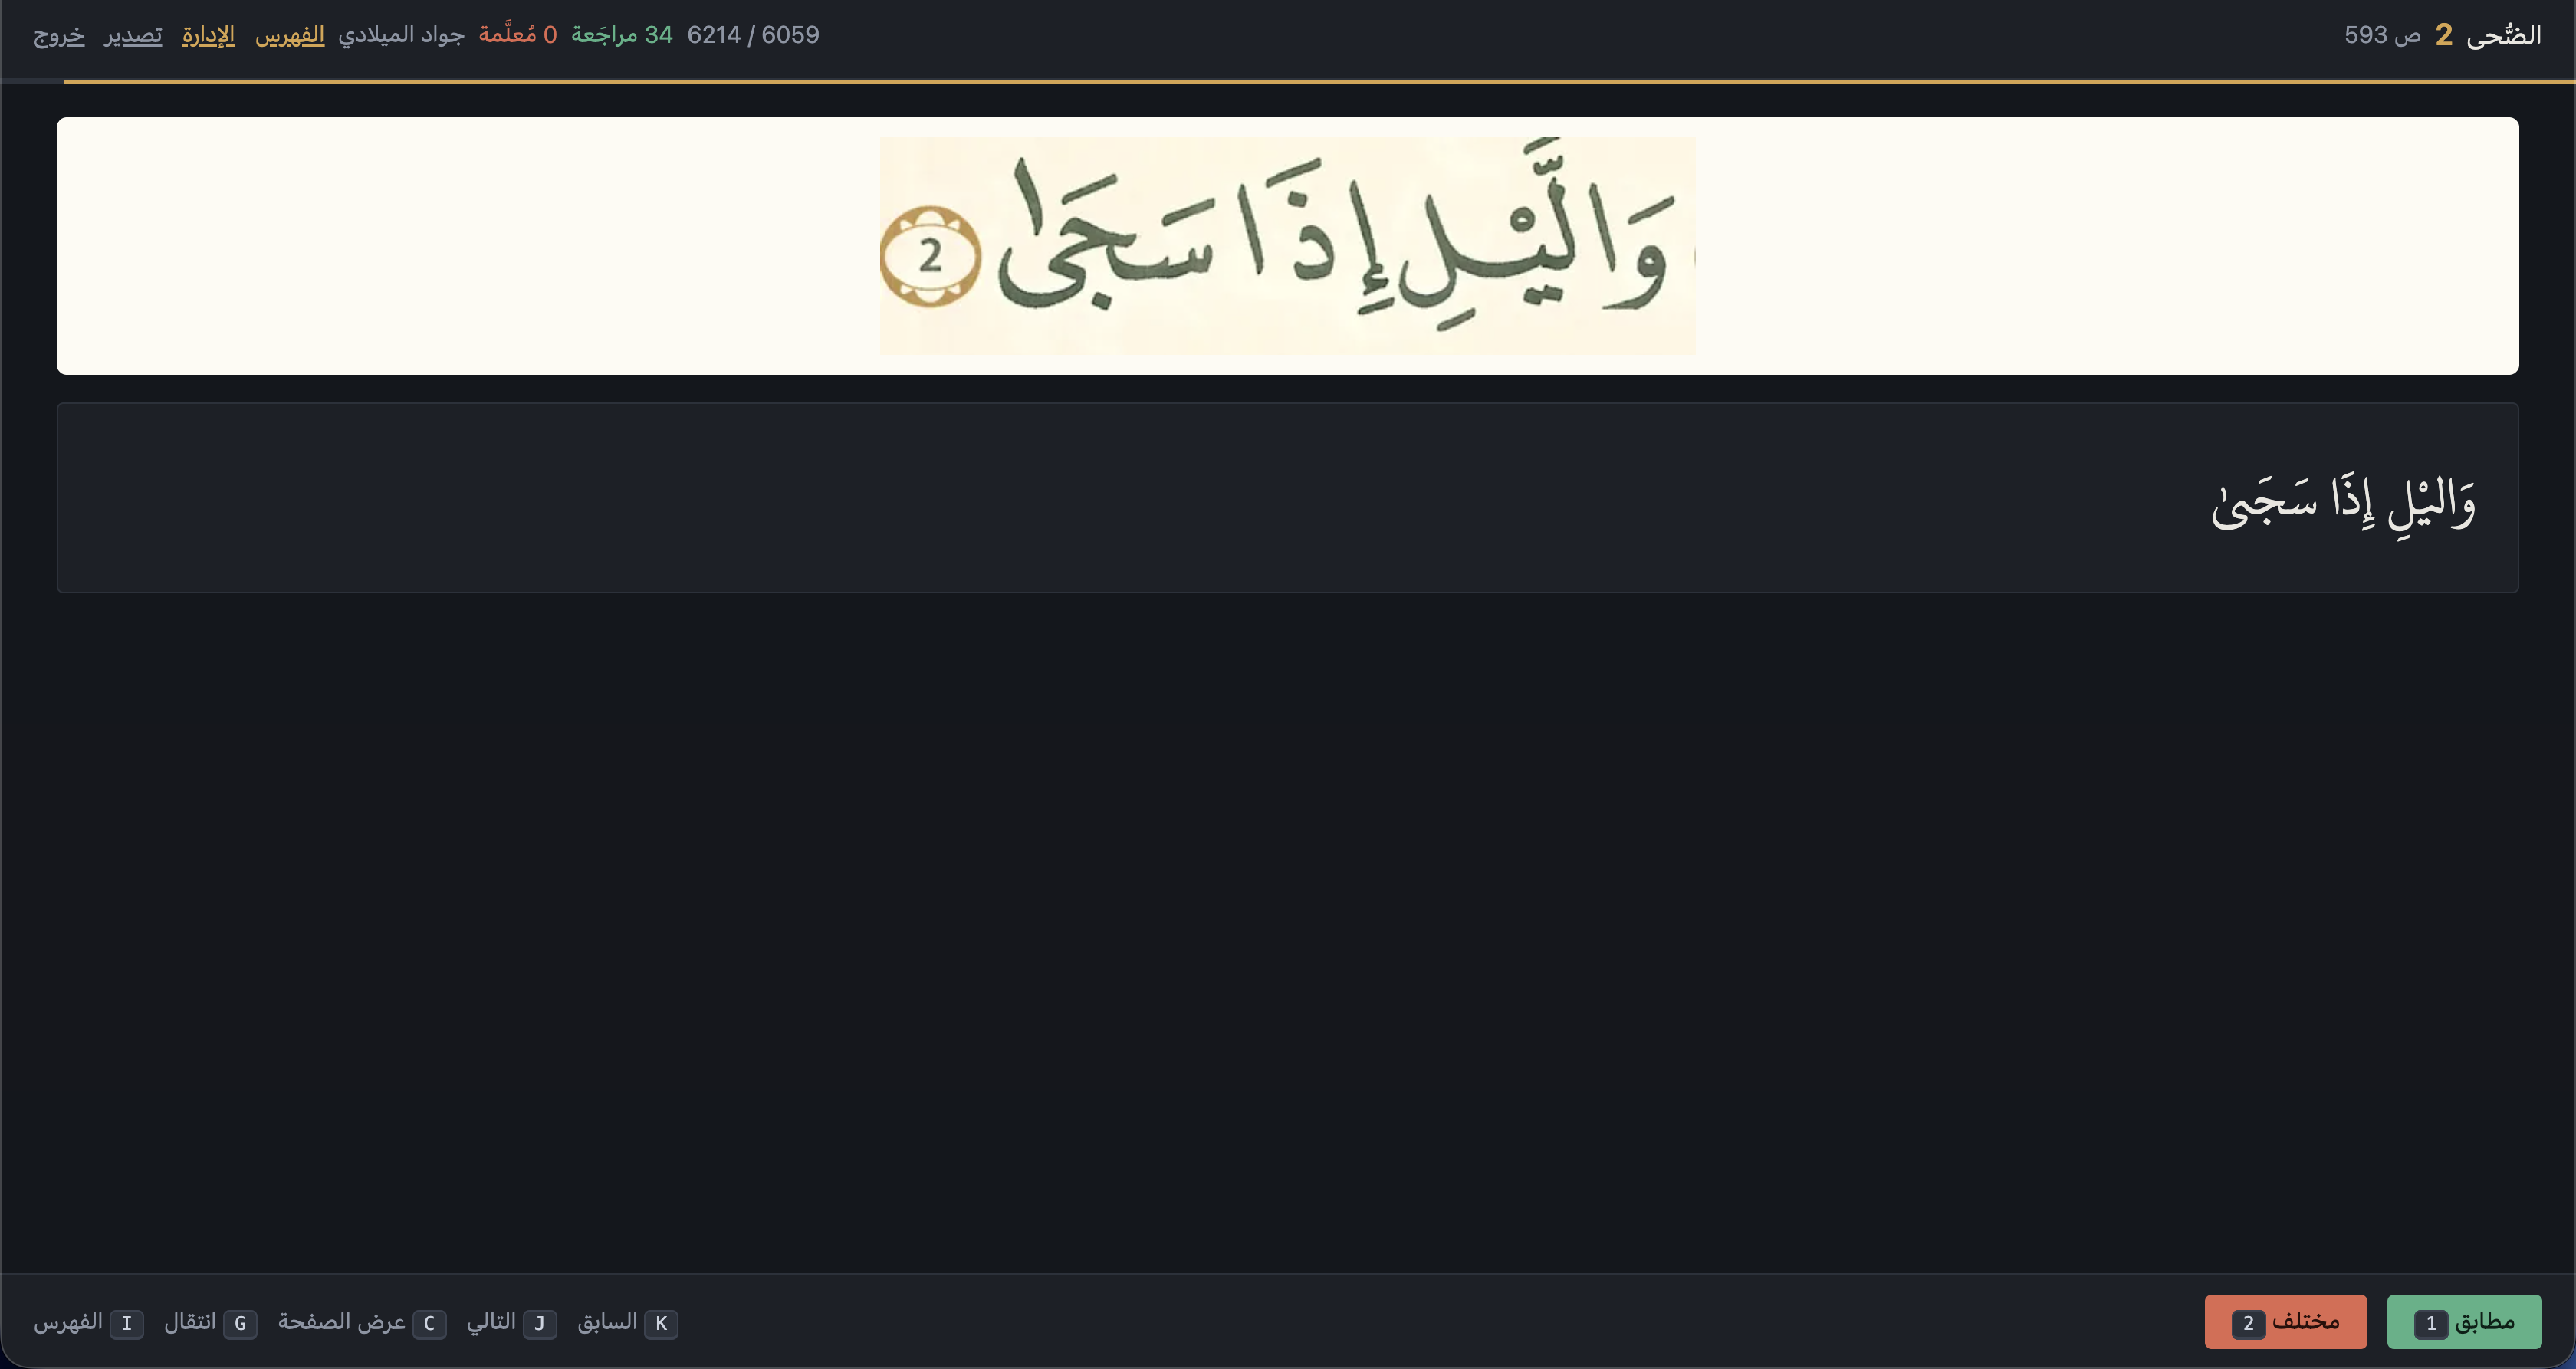
الأداة تعرض لكل آية شيئين جنبًا إلى جنب: الآية مقصوصة من الورق بالبكسل (بين علامتَي بدايتها ونهايتها)، ونصّها من KFGQPC مرسومًا بخط قالون. والمراجع يجيب عن سؤال واحد: أهما نفس الكلمات؟ فيوافق أو يعلّم ويكتب ملاحظة. والمخرج خريطة بكل موضع يختلف فيه تقسيم KFGQPC عن المطبوع، وقد سُجِّلت بها عشرات الآلاف من الأحكام.
وقرار واحد في التصميم وفّر عليّ إعادة العمل كلّه: جعلت المفتاح (سورة، آية) يعني الترتيب المطبوع للعلامة على الورق، لا ادّعاءً عن حدود النص. فلمّا صُحِّح النص بعد ذلك، لم يسقط أي حكم مسجَّل، لأن الورق لم يتغيّر.
قاعدة البيانات التي عندي اليوم هي إذن نص KFGQPC برواية قالون، معدَّلًا ليطابق المصحف المطبوع في الترقيم وحدود الآيات والرسم، مع خريطة تحويل بينه وبين ترقيم حفص (6236 آية) تستعملها كتب التفسير.
7. حدود الآيات المخزَّنة الآن
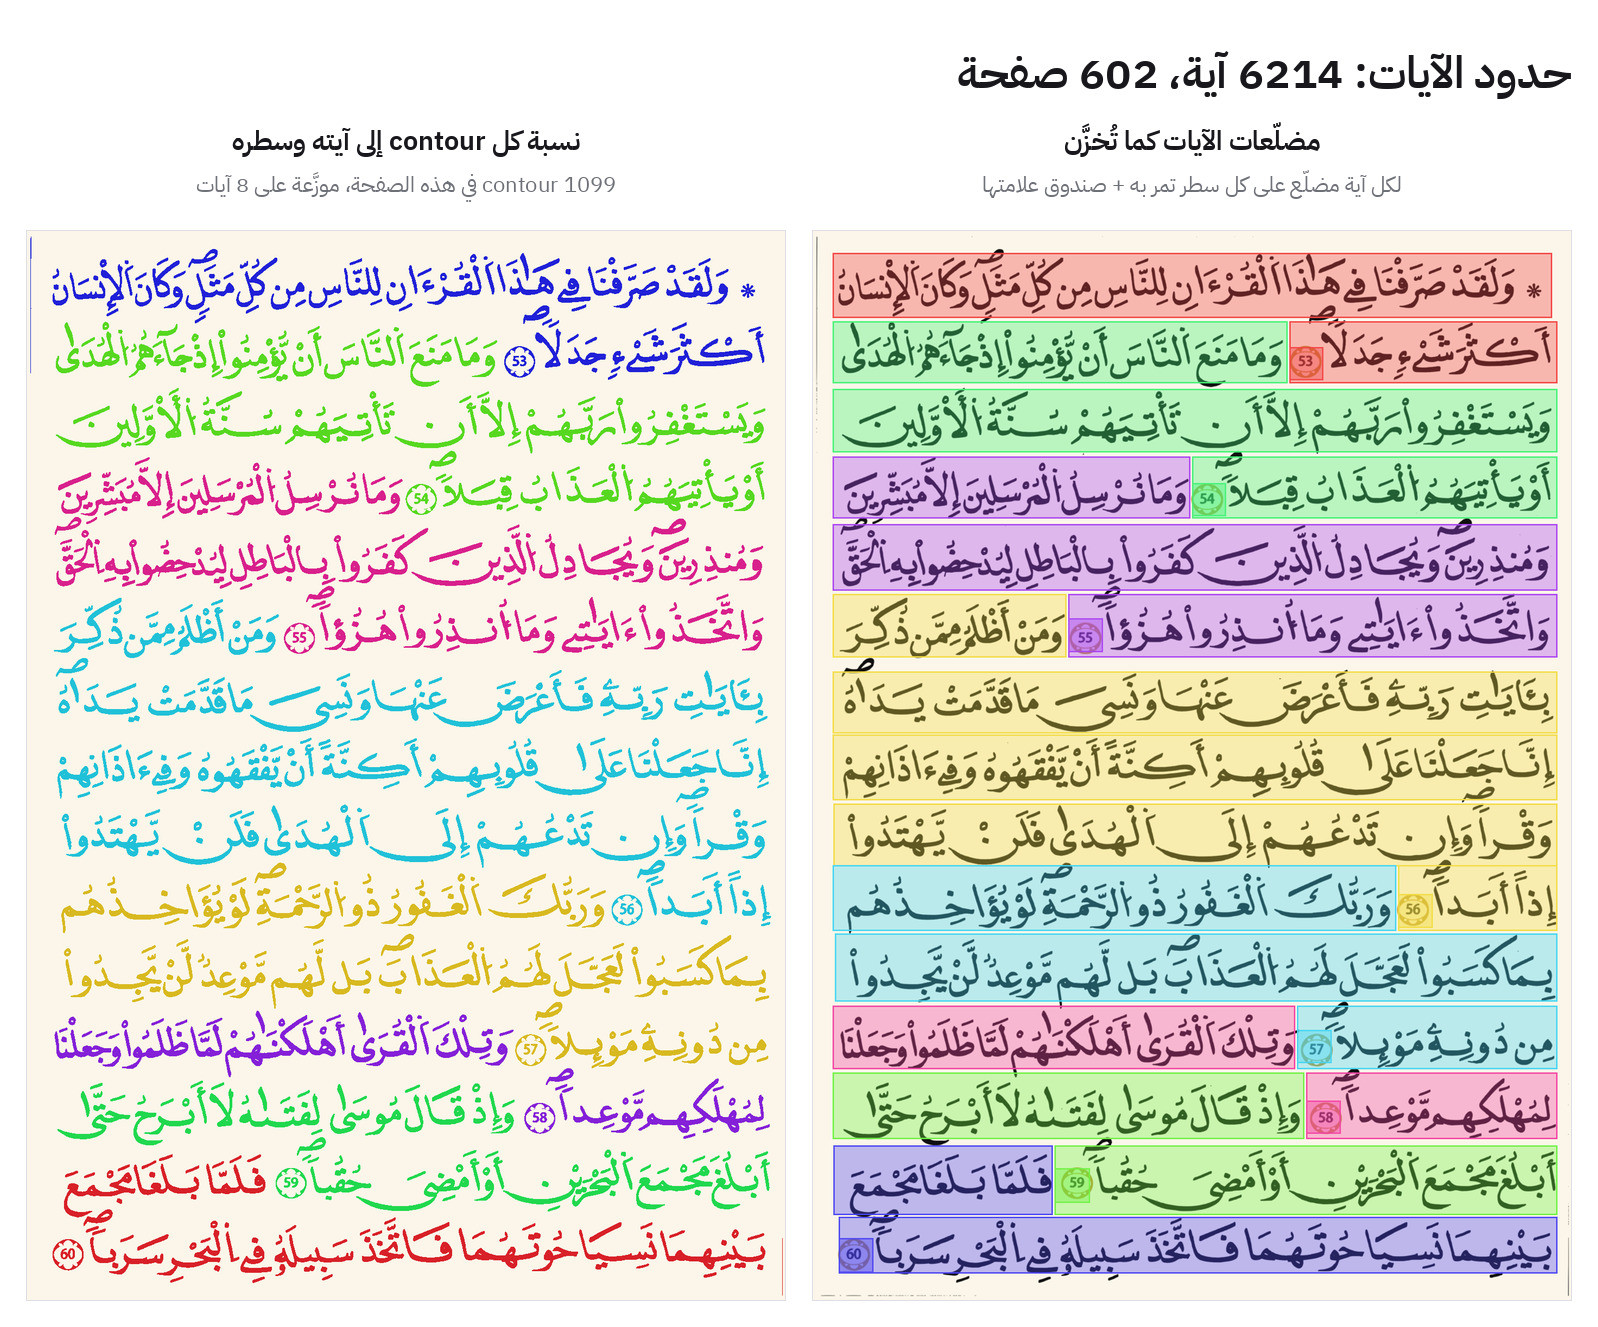
لكل آية مضلّع على كل سطر تمرّ به، مع صندوق علامتها. والملف الذي يشحنه التطبيق يحتوي:
- 6214 آية، ولا واحدة بلا إحداثيات
- 14,328 مضلّع نص + 6214 صندوق علامة، على 602 صفحة و114 سورة
- لكل آية علامتها المطبوعة الخاصة، ولا علامة مشتركة بين آيتين
وفوق ذلك بنيت طبقة أدقّ (اللوحة اليسرى في الصورة): كل شكل حبر منفصل (contour) في الصفحة منسوب إلى آيته وسطره، بنحو 1500 contour في الصفحة الواحدة. بنيتها لأن القصّ الأفقي البسيط لا يكفي: حبر السطر الواحد يتداخل رأسيًّا وأفقيًّا مع السطر المجاور، فلا يوجد خط قصّ صحيح بأي قيمة.
8. وأخيراً المطلوب: إحداثيات على مستوى الكلمة
هذه هي النقطة التي توقفت عندها.
أريد، فوق إحداثيات الآيات الموجودة، إحداثيات لكل كلمة مطبوعة على الصفحة، مربوطة بالكلمة المقابلة لها في قاعدة بياناتي. أي أن تكون الكلمة رقم كذا من الآية كذا لها مضلّع معروف على الصفحة.
الفائدة المباشرة: إبراز الكلمة عند التسميع أو التلاوة، وعرض معناها أو إعرابها فوق موضعها من الورق، وإبراز نتيجة البحث في مكانها.
والوضع الذي أنطلق منه مريح نظريًّا:
- أعرف نصّ كل سطر بالضبط
- أعرف كل contour وإلى أي سطر وأي آية ينتمي
- أعرف عدد قطع الحبر المنفصلة لكل كلمة بالضبط، لأن الحروف غير الموصولة في العربية (ا د ذ ر ز و ؤ ة ء ى) تجعل ذلك قابلًا للحساب من الإملاء وحده
ومع ذلك لم أصل.
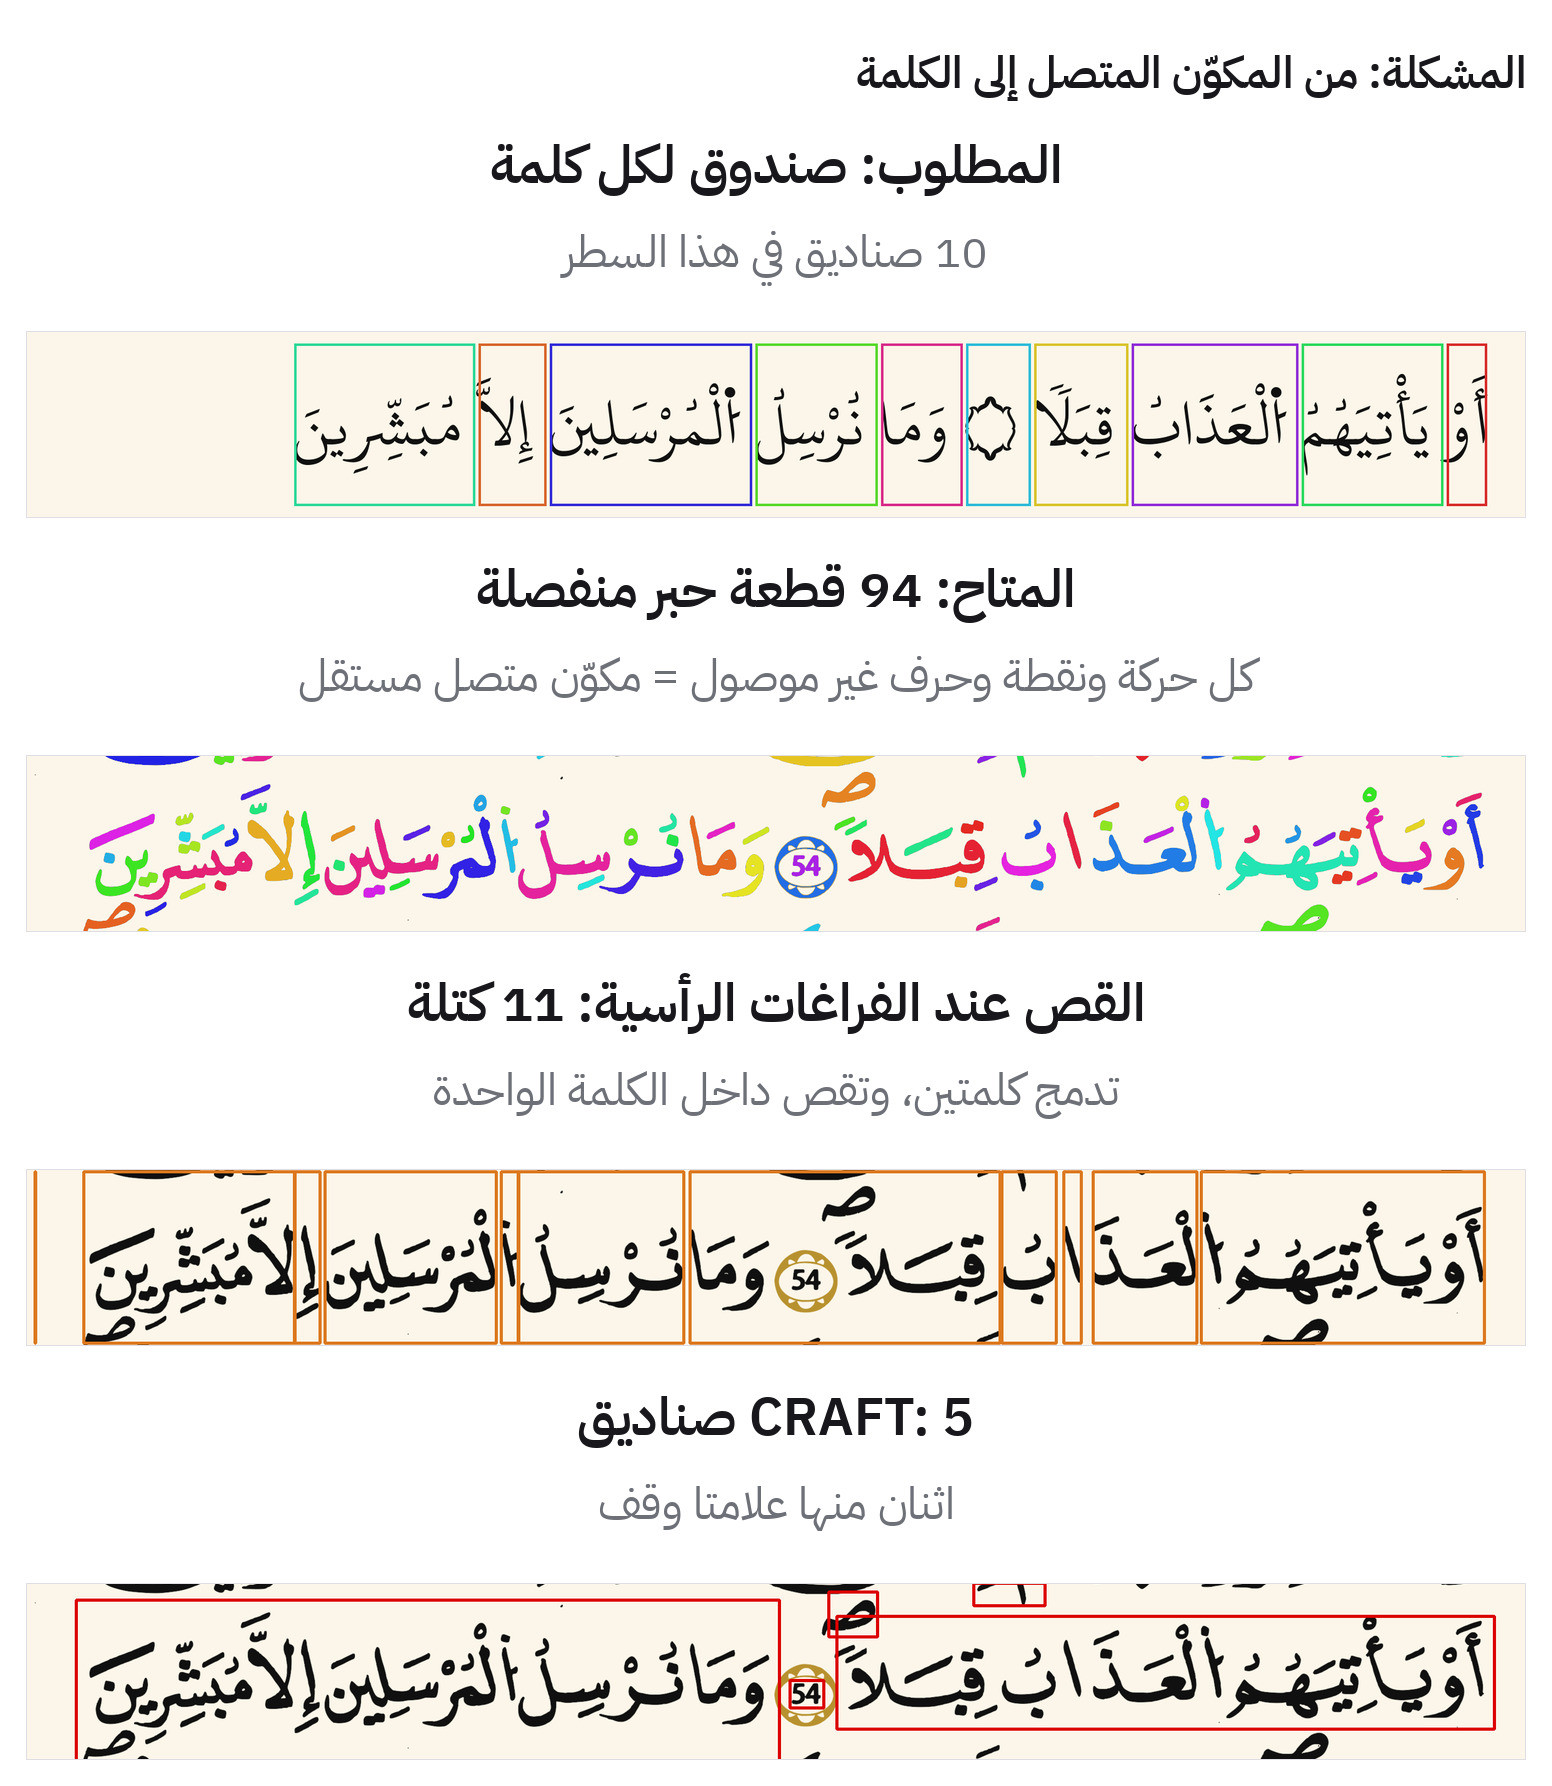
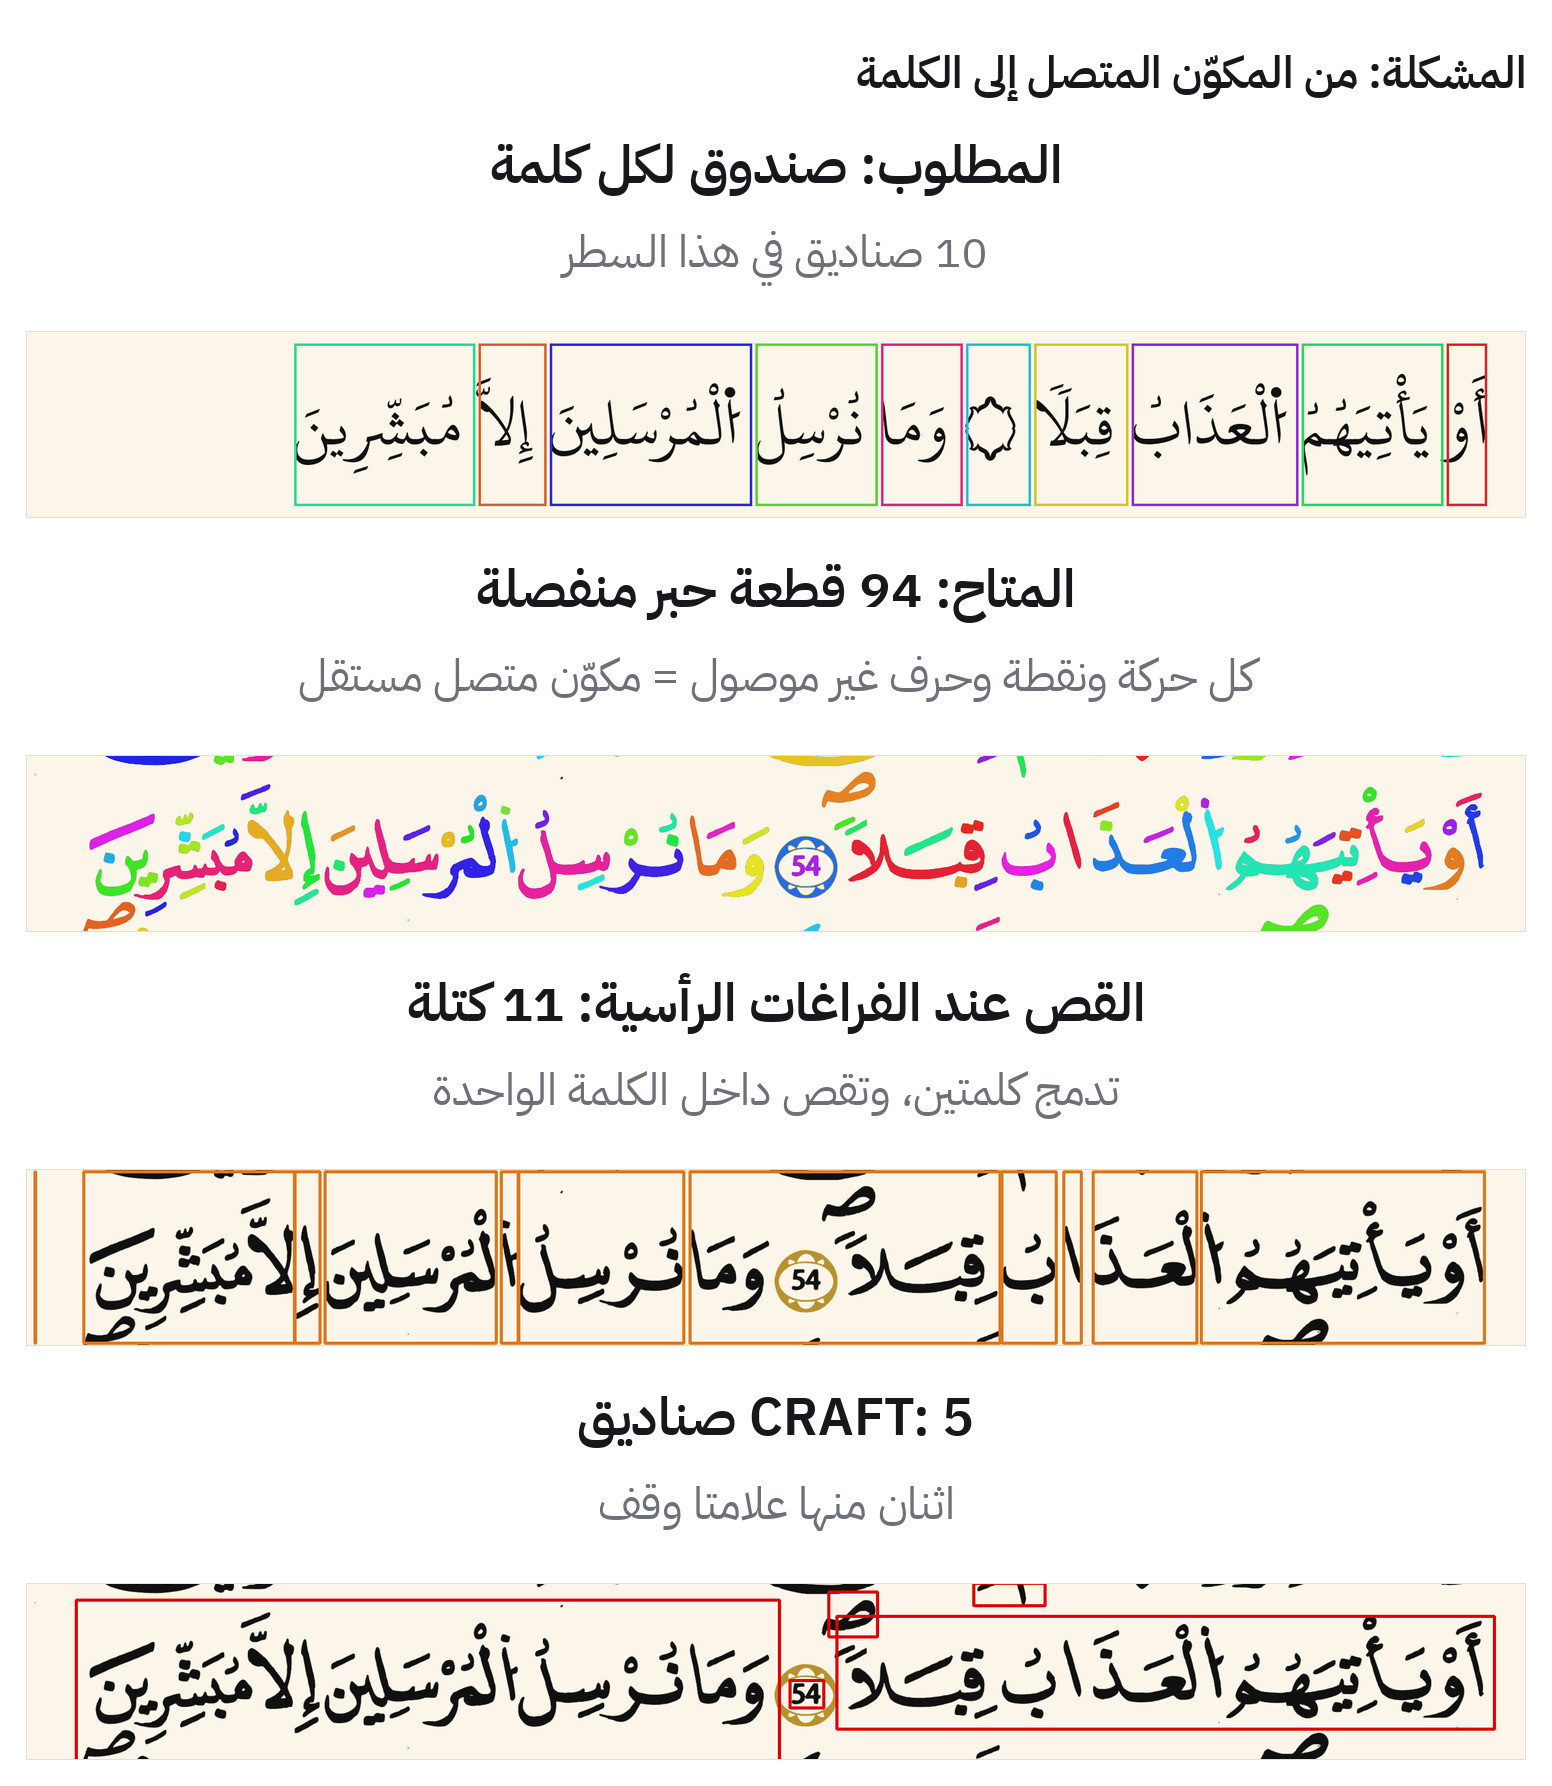
السبب الجذري أن هذا خط يدوي لا تنضيد آلي: الكشيدة والتراكيب تمدّ آخر الكلمة تحت أول التي تليها، فتتداخل الكلمتان أفقيًّا. فأي قصّ رأسي يفشل بنيويًّا لا بسوء ضبط. يُضاف إلى ذلك أن التشكيل كثيف، فكثير من القطع تقع بين كلمتين.
ما جرّبته باختصار: القصّ عند الفراغات الرأسية، وتحليل مقطع الأعمدة، وكاشفات جاهزة (CRAFT وSurya)، وبرمجة ديناميكية تعتمد على عروض الحروف. كلها قِسْتُها بالأرقام، وكلها بعيدة عن المطلوب: الكاشفات الجاهزة تعطي 4 إلى 6 مناطق لسطر فيه 10 كلمات، أو تكتفي بكشف السطور. ولن أدخل في تفاصيلها لأنها لم تُثمر.
9. السؤال
ما النموذج أو الطريقة التي تعطيني إحداثيات على مستوى الكلمة على صفحة مصحف مطبوع بخط اليد؟
وبصيغة أدقّ:
هل يعرف أحدكم نموذجًا (كاشفًا أو مُحاذيًا) يعمل على الخط العثماني المطبوع ويُخرِج صناديق أو مضلّعات للكلمات؟ وهل جرّبه أحد على مصحف مطبوع فعلًا، لا على نص مرسوم بخط رقمي؟
بما أن النص معروف عندي سلفًا، فالمسألة عندي محاذاة (alignment) لا تعرُّف (recognition): تسلسل كلمات معروف، على تسلسل أشكال حبر معروفة، على سطر واحد. فهل توجد طريقة عملية لمحاذاة نص معلوم على صورة سطر؟ وهل تنفع مخرجات CTC من أدوات مثل Kraken أو Calamari لاستخراج مواضع الحروف بدقة تكفي لحدود الكلمات؟
هل توجد بيانات معلَّمة على مستوى الكلمة لأي مصحف مطبوع، يمكن الاستفادة منها في fine-tuning؟
هل يمكن استغلال ما أملكه أصلًا كقيد على الحل — عدد قطع الحبر المعروف لكل كلمة، ونسبة كل contour إلى سطره وآيته — بحيث تكون المحاذاة مجبَرة على إخراج التقسيم الصحيح، بدل أن يُقرَّر كل فاصل على حدة؟
أم أن هذا الطريق غير مجدٍ أصلًا، والأصحّ عرض طبقة نصية شفافة فوق الصورة؟ أفضّل أن أعرف ذلك الآن.
ملاحظة مهمة: لا أبحث عن حلٍّ يقوم على تصميم خطّ (font) أو إعادة رسم المصحف رقميًّا. ليست لديّ خبرة في ذلك ولا ميزانية له، والمطلوب هو إحداثيات فوق الصور المطبوعة نفسها.
10. ما يسعدني مشاركته
- المنهج كاملًا بتفاصيله وأرقامه، وأي خطوة أعلاه أفصّلها لمن أراد
- مخطط بيانات الإحداثيات: كيف تُخزَّن الآية كمضلّعات لكل سطر، وقاعدة نسبة الـ contours
- مقاييس وصفة التحويل إلى SVG بأحجامها، لمن أراد تحويل مصحف آخر إلى صفحات قابلة للتلوين
- عيّنات من الصفحات المتجهية للتجريب
أما صور المسح الأصلية فلها ترتيب مع الجهة صاحبة الحق، فأشارك المنهج والمخطط دون تحفّظ، وأقف عند الصور حتى يكتمل الترتيب.
جزاكم الله خيرًا، وأي إشارة نافعة — حتى لو كانت "جرّبنا هذا فلم ينجح" — تختصر عليّ طريقًا.


