نظرا لتوجه بعض المطورين إلى استخدام صور المصحف بدلاً من النص وخاصة في مجموعة مكتبات مصحف عماد، كان هناك الحاجة إلى تحديد أماكن الآيات في الصور حتى يمكن ربطها بمصادر الأخرى كالتفسير والمعاني والترجمة والصوتيات، ولأن المصاحف الموجودة حاليا، والتي تم قصها بالفعل إلى آيات، قليلة جدا كانت الحاجة إلى مشروع يستطيع معالجة المصحف المصور وانتاج هذه الصور وإحداثيات الآيات. ومن هنا جاءت فكرة مشروع quran-page-splitter.
معالج الآيات
أولا طريقة استخدام التطبيق
رفع ملف PDF للمصحف.
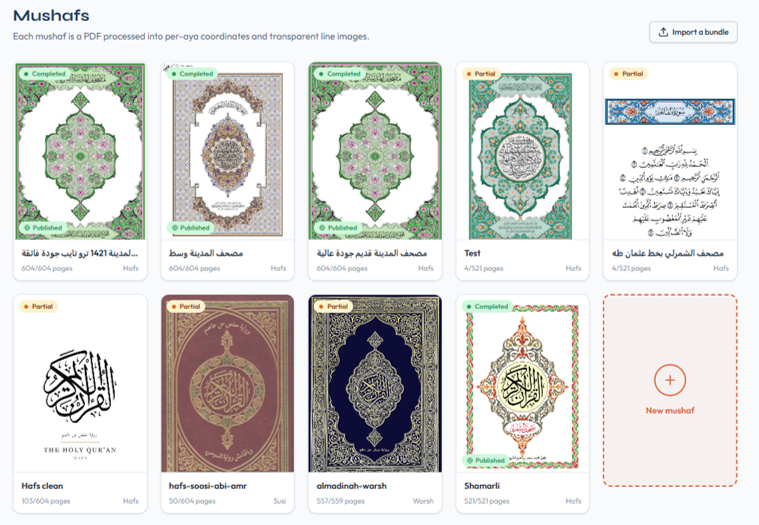
يقوم المستخدم باختيار الاسم الذي يريد حفظ المصحف به، ثم يحدد رواية المصحف ثم يحدد ملف الـ PDF للمصحف، ثم يضغط على زر رفع الملف.
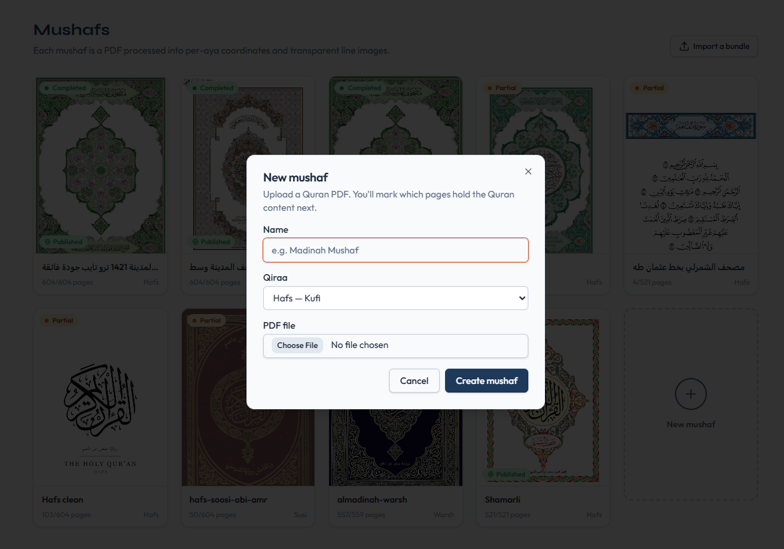
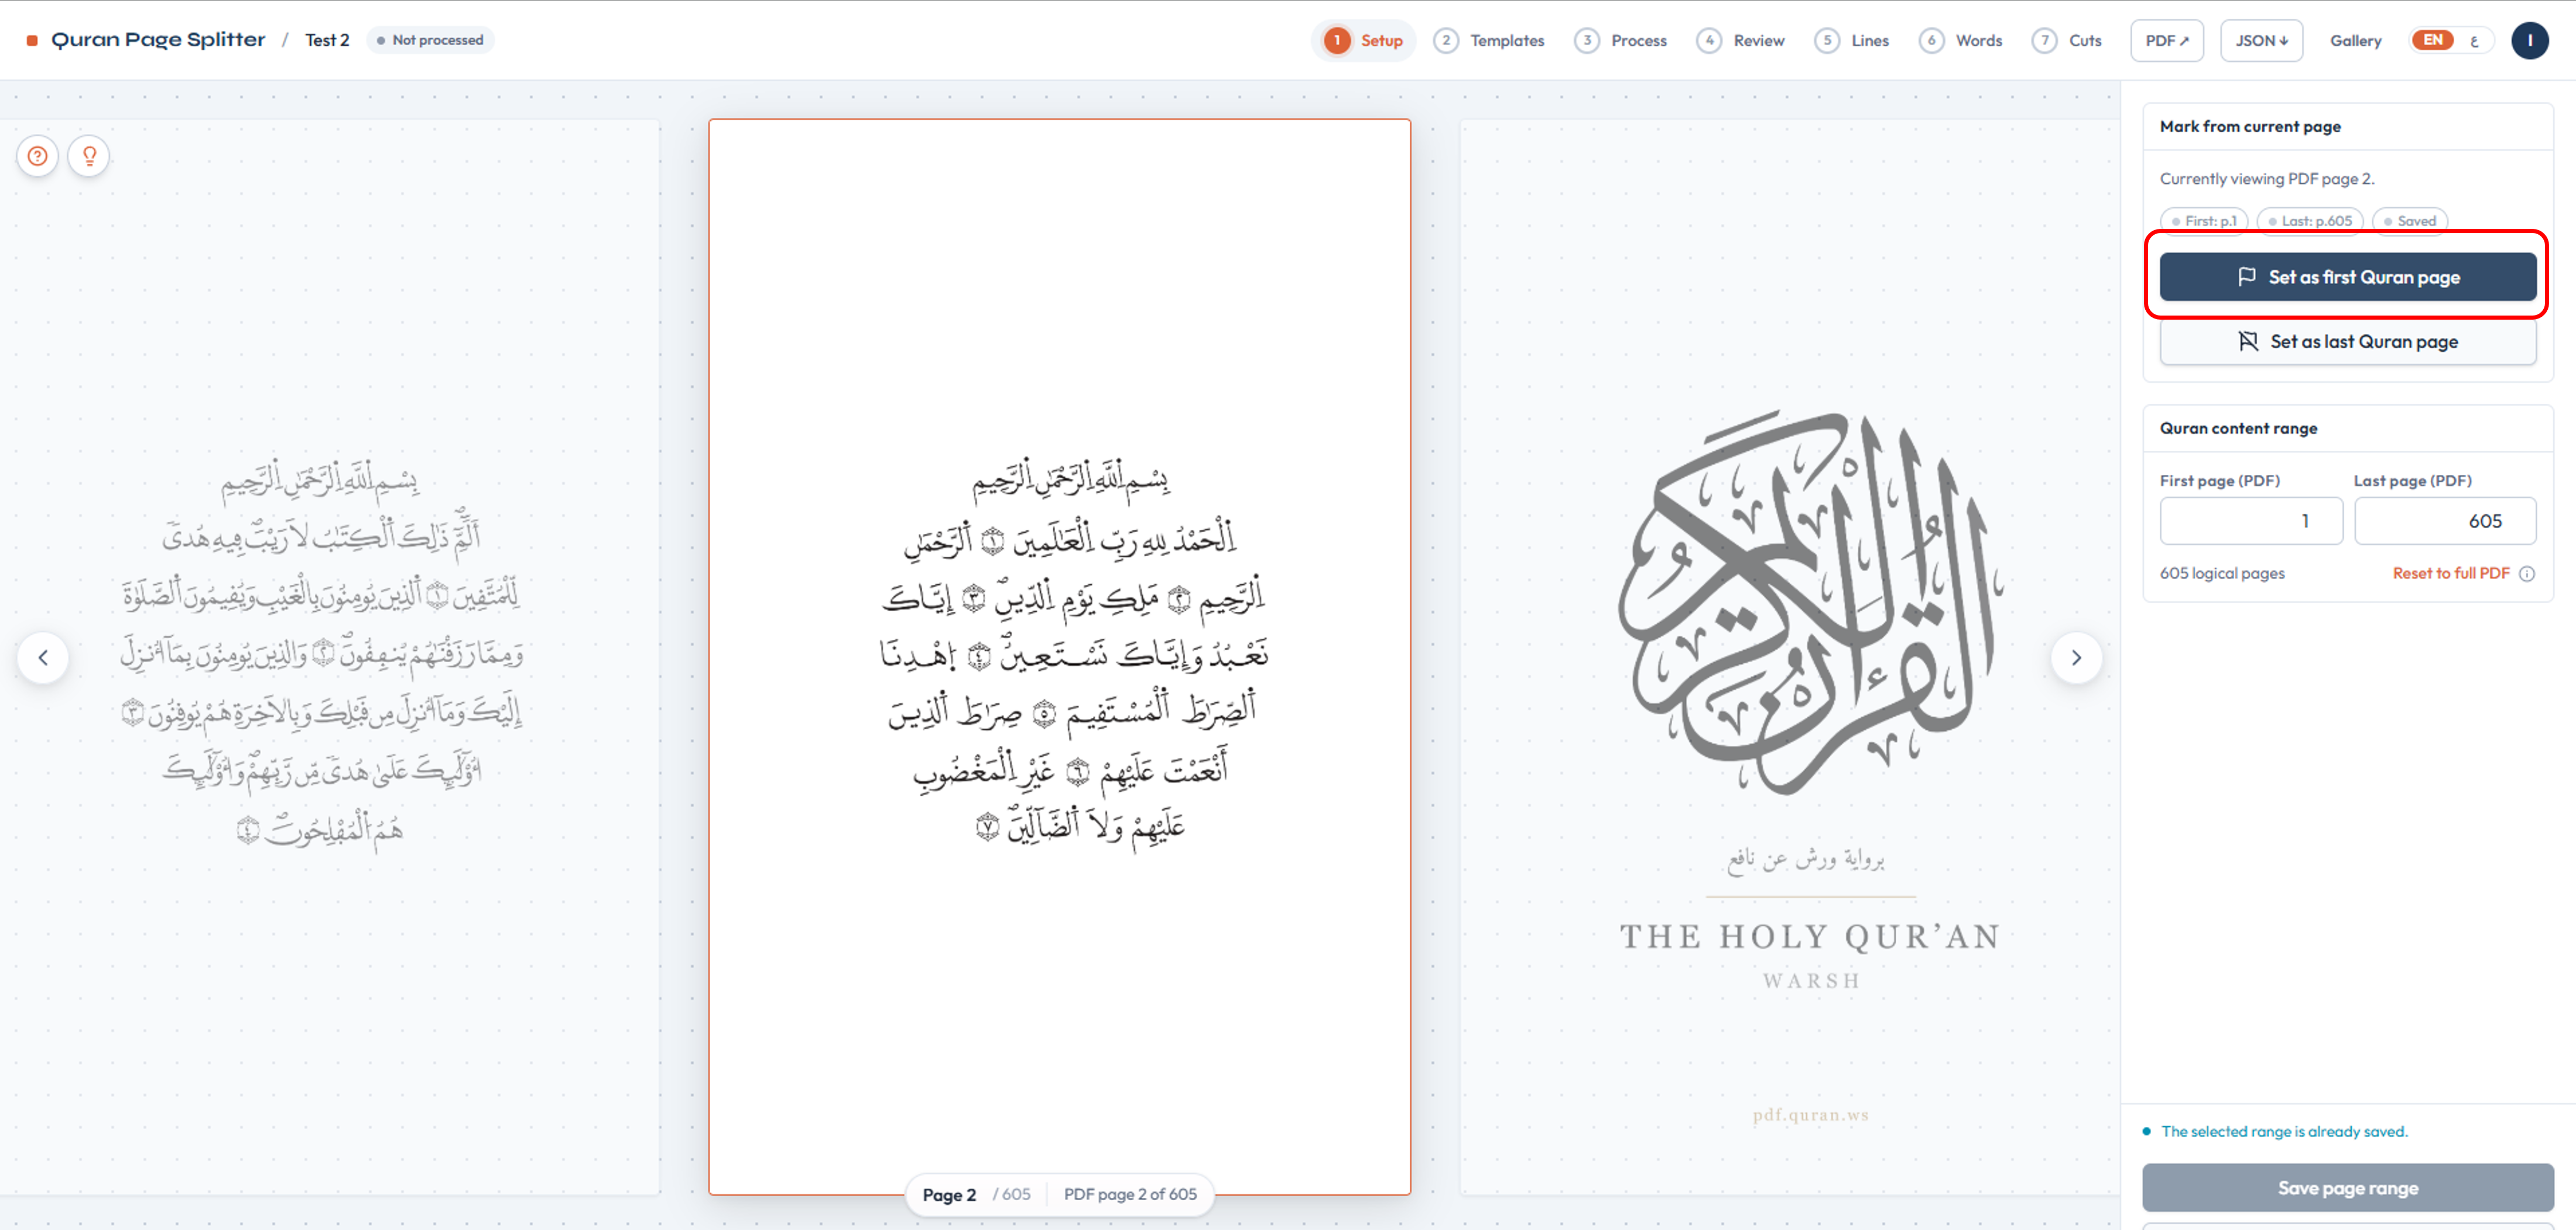
بعد رفع المصحف، يقوم المستخدم بتحديد النطاق الصحيح للقرآن في المصحف باستبعاد الملاحق في نسخة المصحف المرفوعة.
ذلك عن طريق الوقوف على الصفحة التي بها سورة الفاتحة ثم الضغط على "Set as first page"، ثم الوقوف على الصفحة التي بها آخر سورة في المصحف ثم الضغط على "Set as last page" ثم حفظ التغييرات. بعد ذلك، سيقوم التطبيق بحفظ هذه الإعدادات في قاعدة البيانات، بحيث لا يحتاج المستخدم إلى إعادة تحديد النطاق في المرات القادمة.
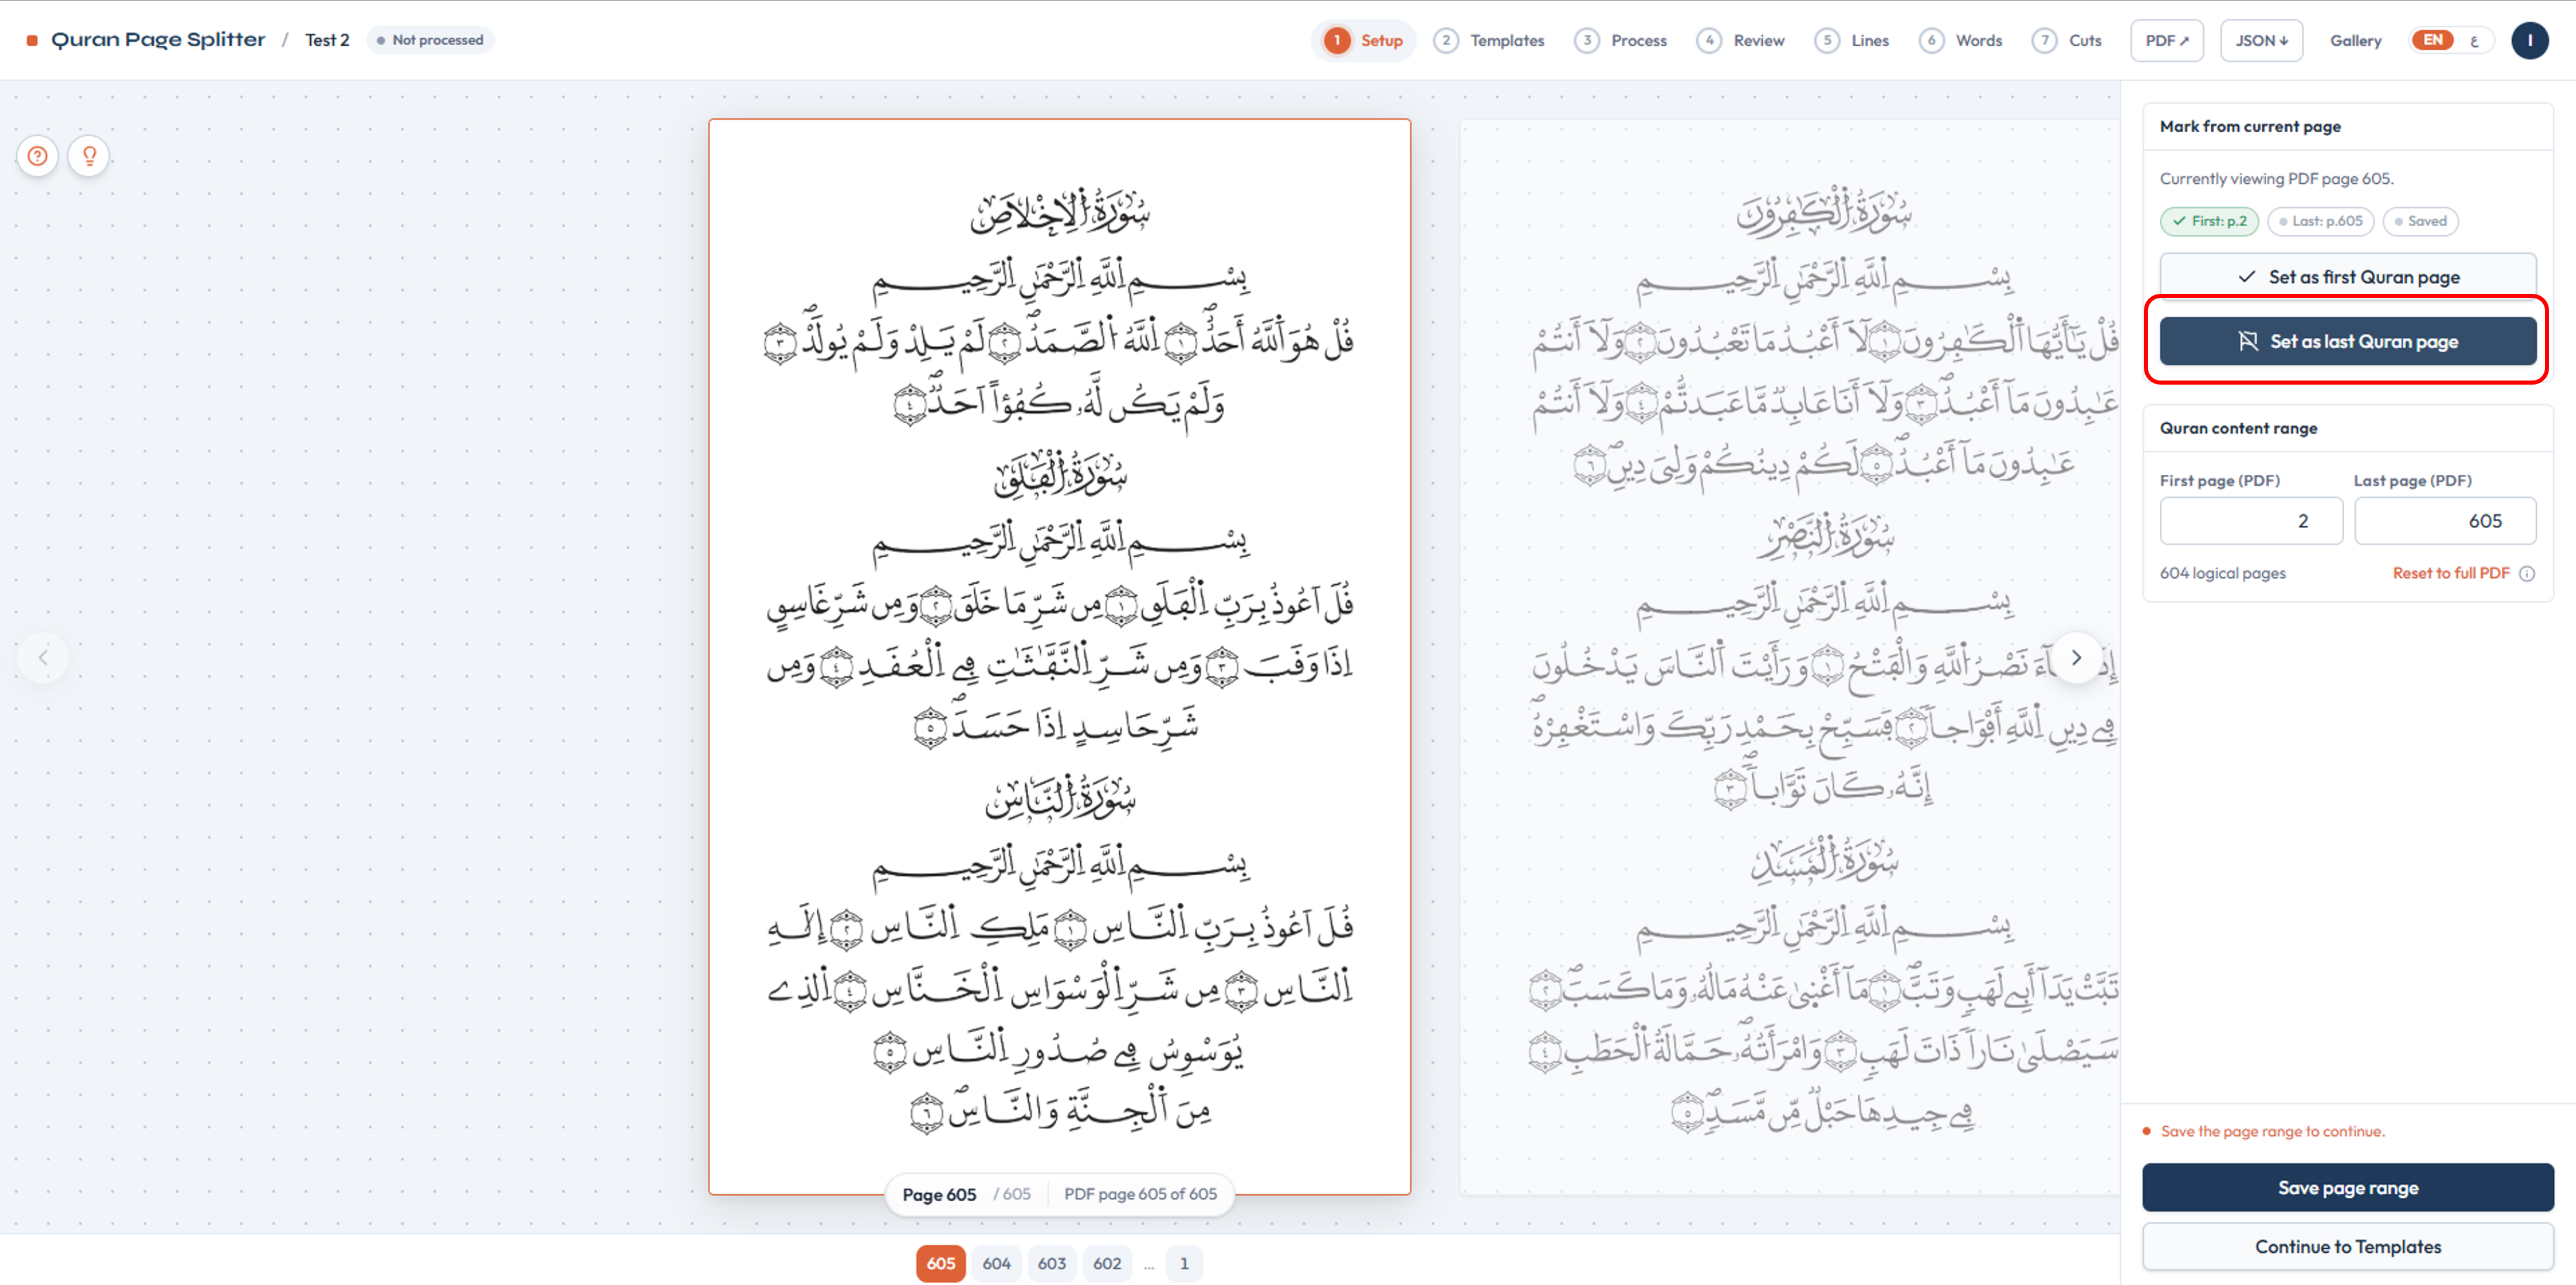
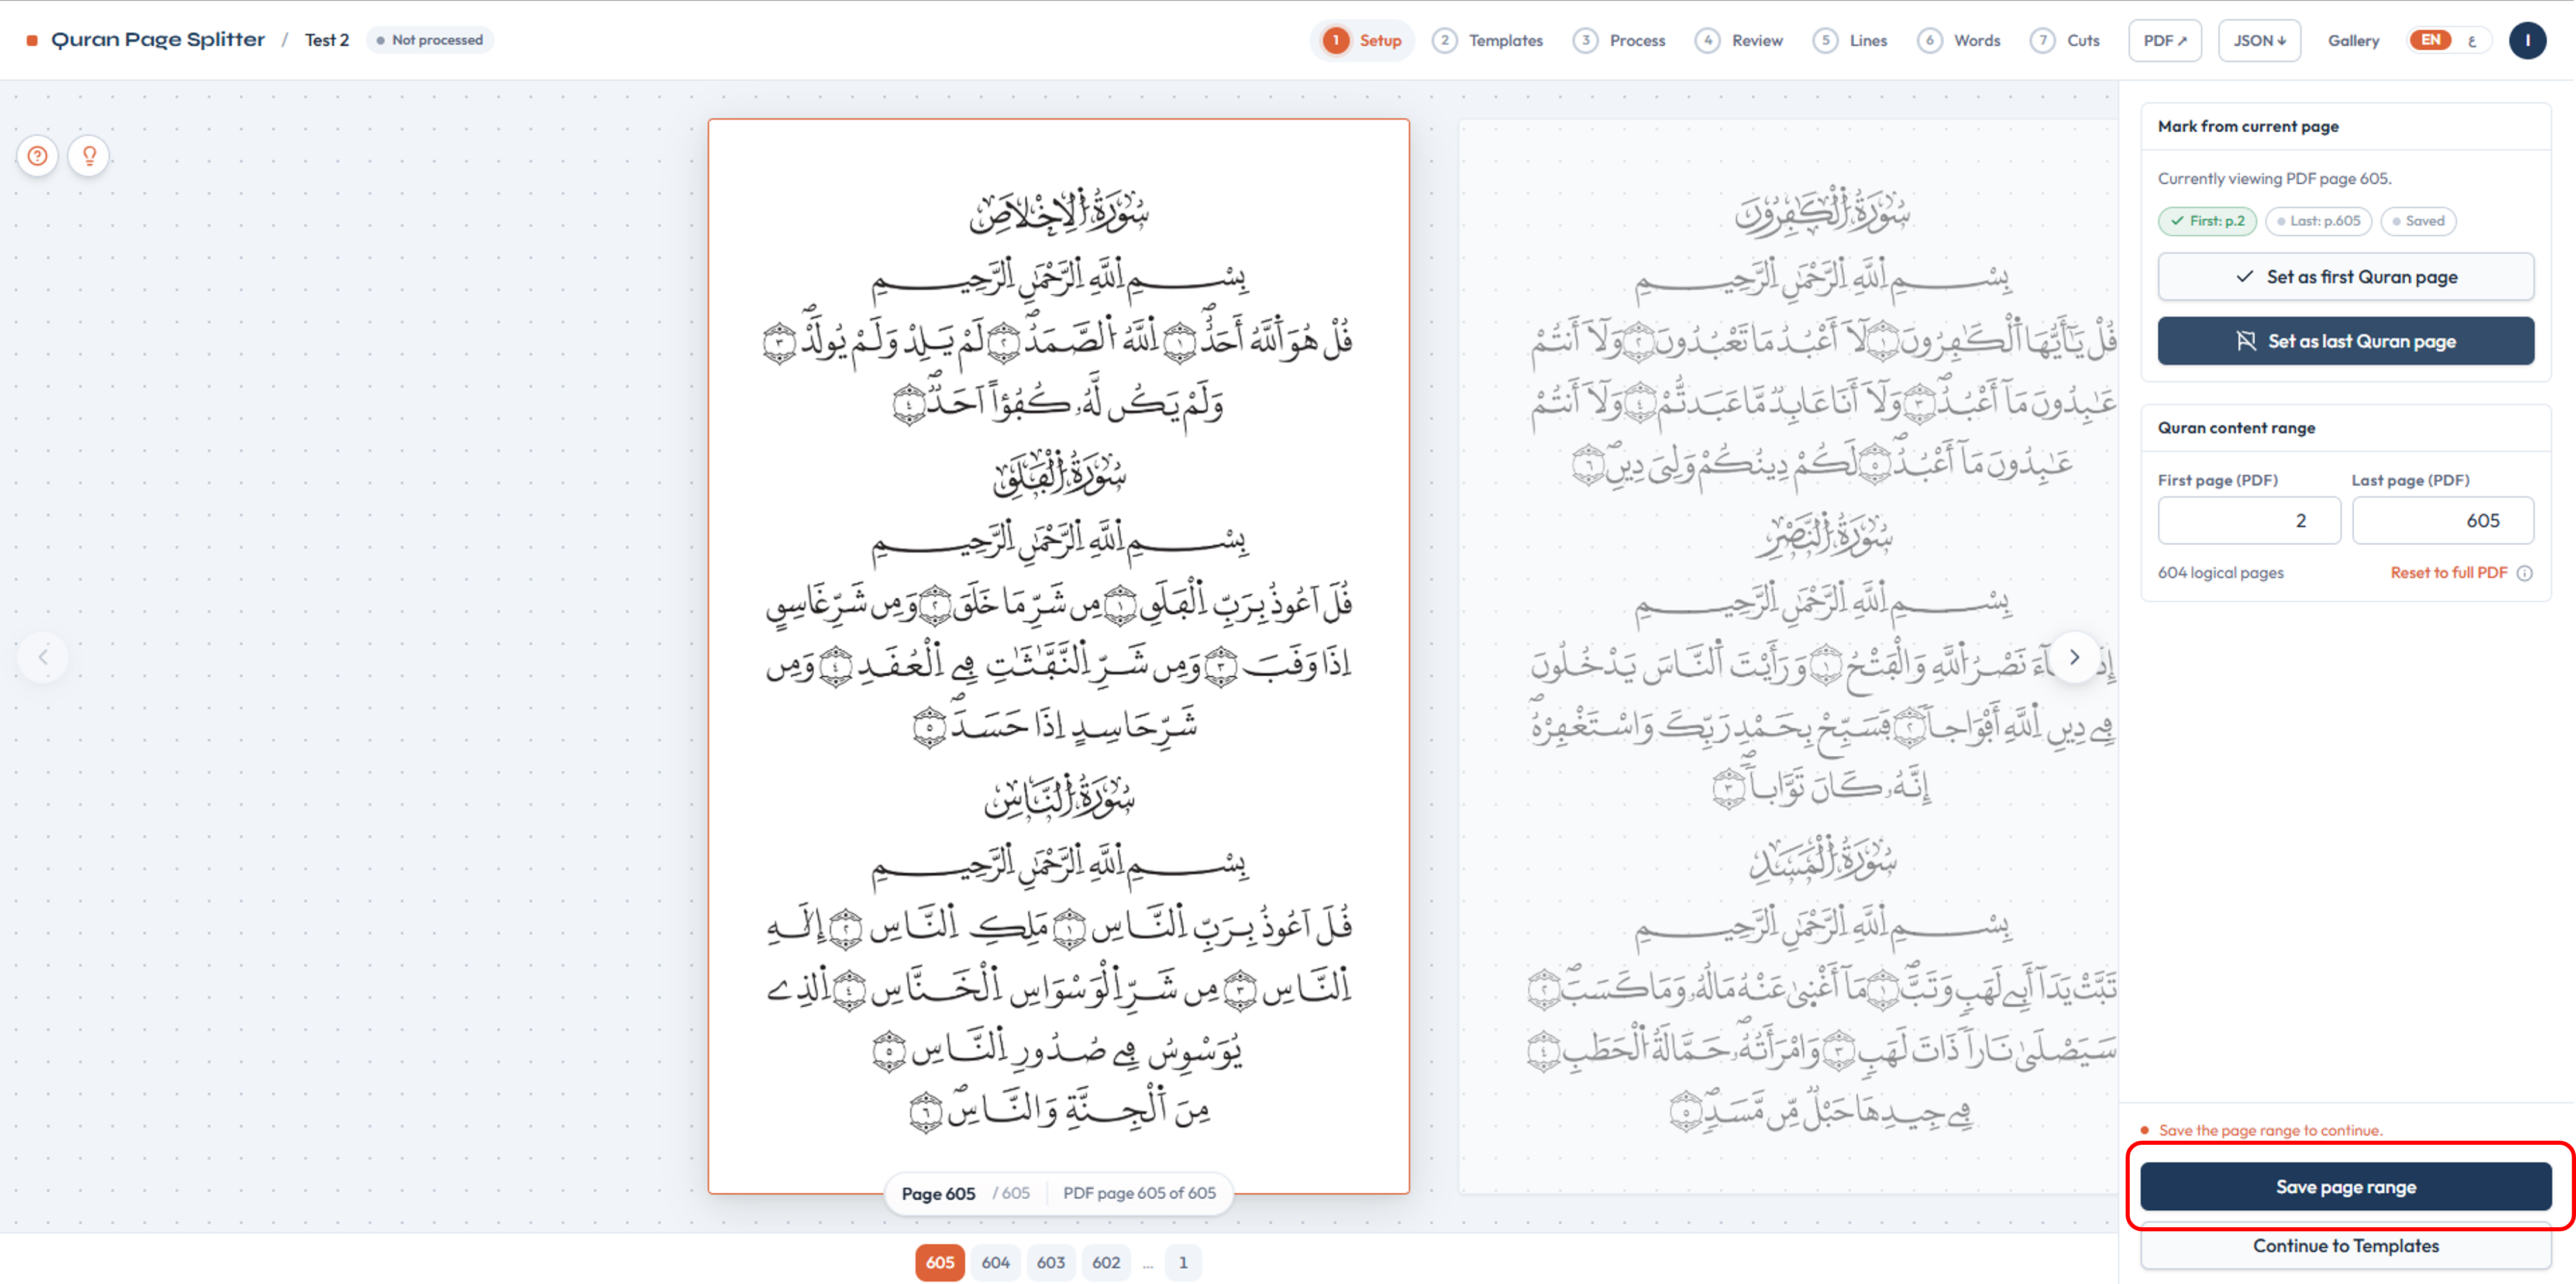
ثم يضغط المستخدم "continue to templates" للذهاب للمرحلة التالية.
تحديد القوالب المطلوبة.
يقوم المستخدم بتحديد نوع القالب المراد قصه أولا من اللوحة الجانبية. ثم يقوم بتغيير القالب المحدد من المصحف، بحيث يقتصر على القالب نفسه فقط، مع إزالة أي حبر زائد حوله. وبعد التأكد يضغط على زر "Capture {اسم القالب}" بعد ذلك، يقوم المستخدم بتحديد المنطقة المتغيرة داخل القالب، مثل رقم الآية في قالب فاصل الآية أو اسم السورة في قالب عنوان السورة ويضغط "Done". بعد ذلك، يقوم المستخدم بحفظ القالب. ويقوم التطبيق بحفظ هذه الإعدادات في قاعدة البيانات، بحيث لا يحتاج المستخدم إلى إعادة تحديد القوالب في المرات القادمة.
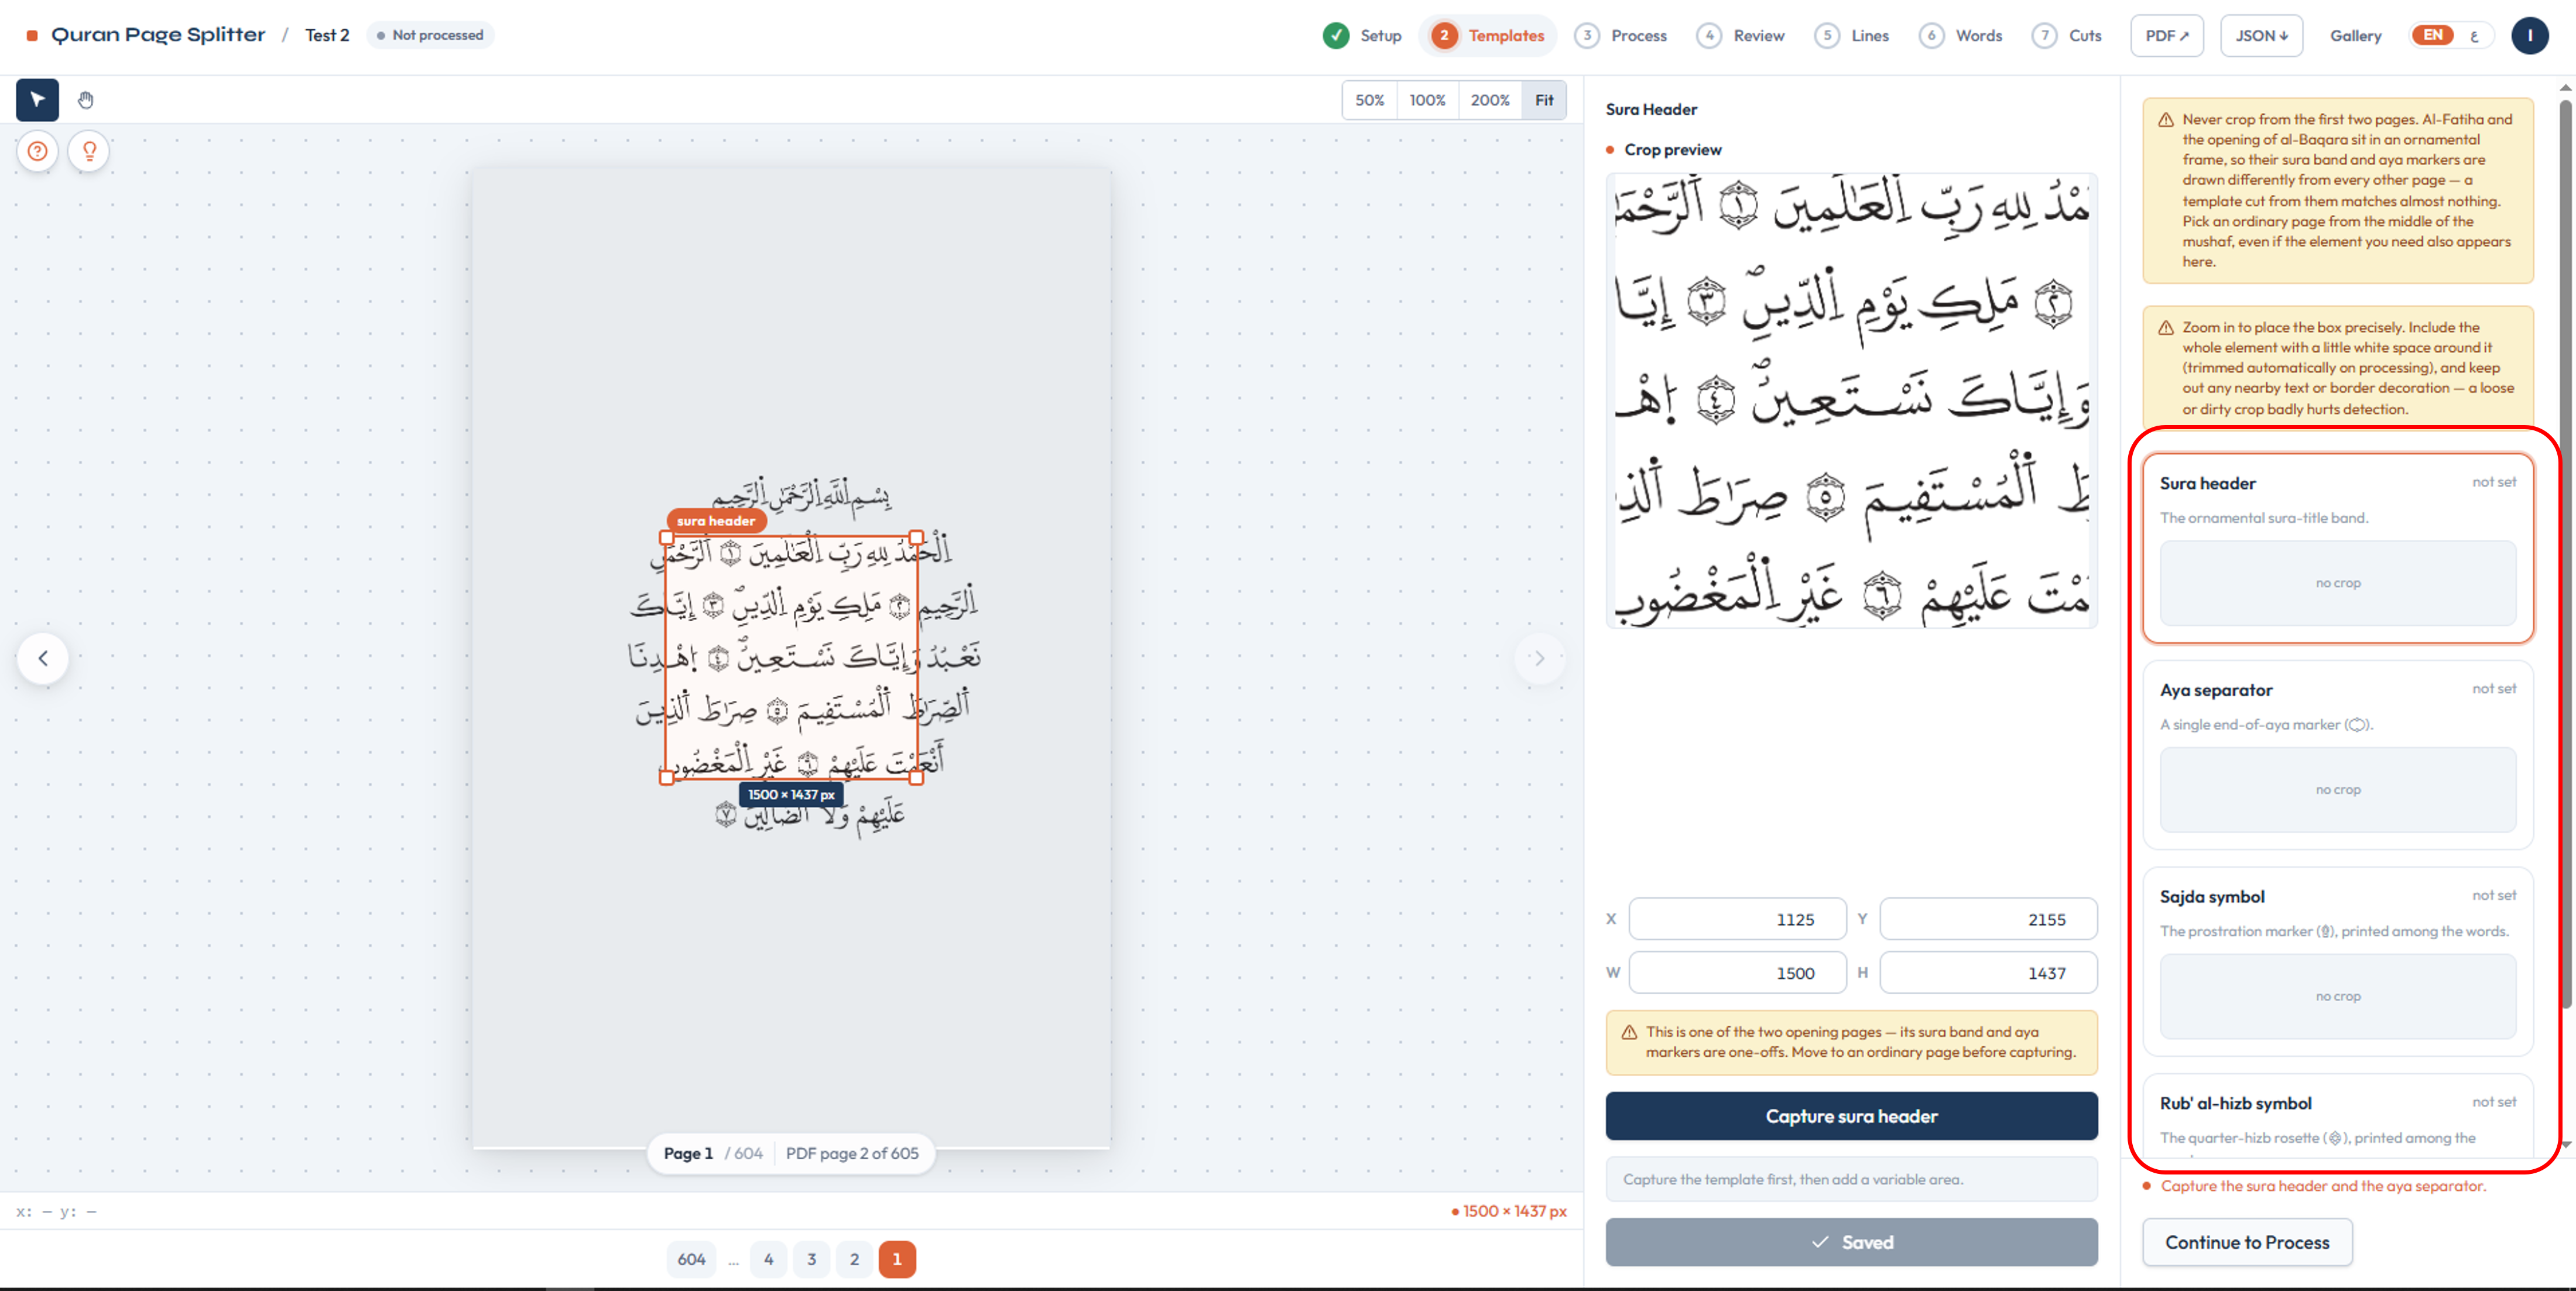
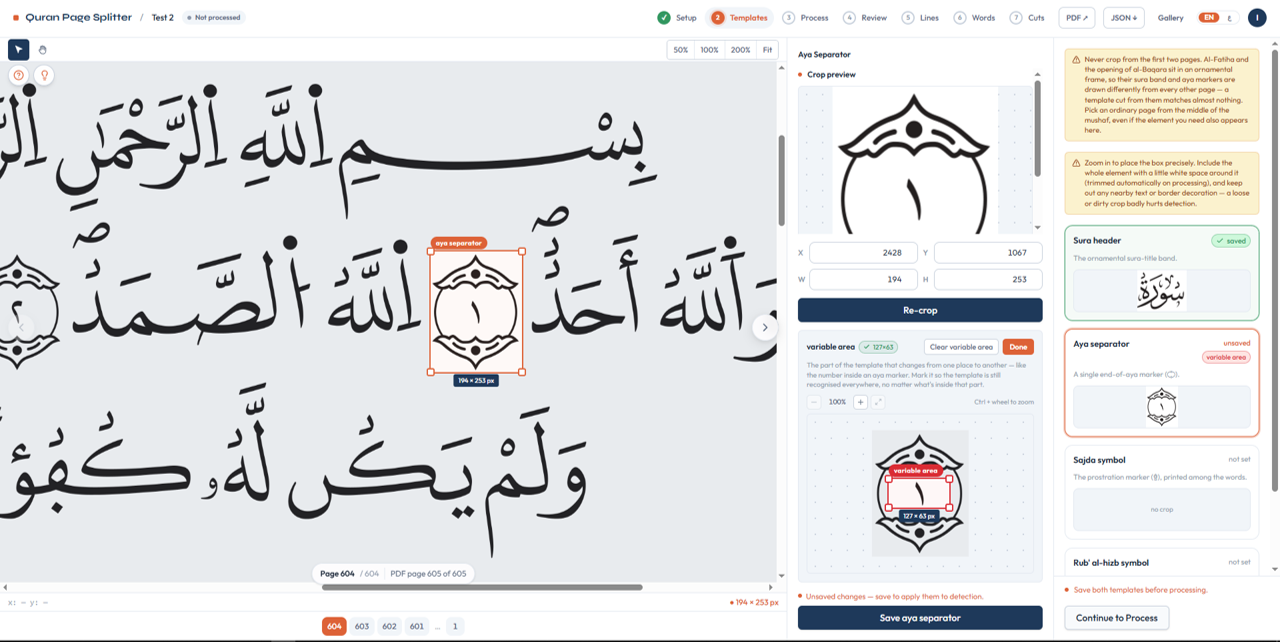
ثم يضغط "continue to processing" للذهاب للمرحلة التالية.
مرحلة المعالجة البرمجية.
يقوم المستخدم بتحديد المنطق التي يوجد بها النص دون أي زخارف حتى لا يؤثر بشكل سلبي على المنتائج المعالج.
ثم يحدد النطاق المراد معالجته. ويفضل استخدام عدد صفحات قليل في المرة الأولى لاختبار النتائج في حالة أن المعايير المستخدمة أعطت نتائج غير جيدة فيمكن تغييرها في المرات التالية دون إضاعة للوقت.
تحدد آية بداية النطاق المحدد حتى يستطيع المعالج الترقيم بشكل صحيح.
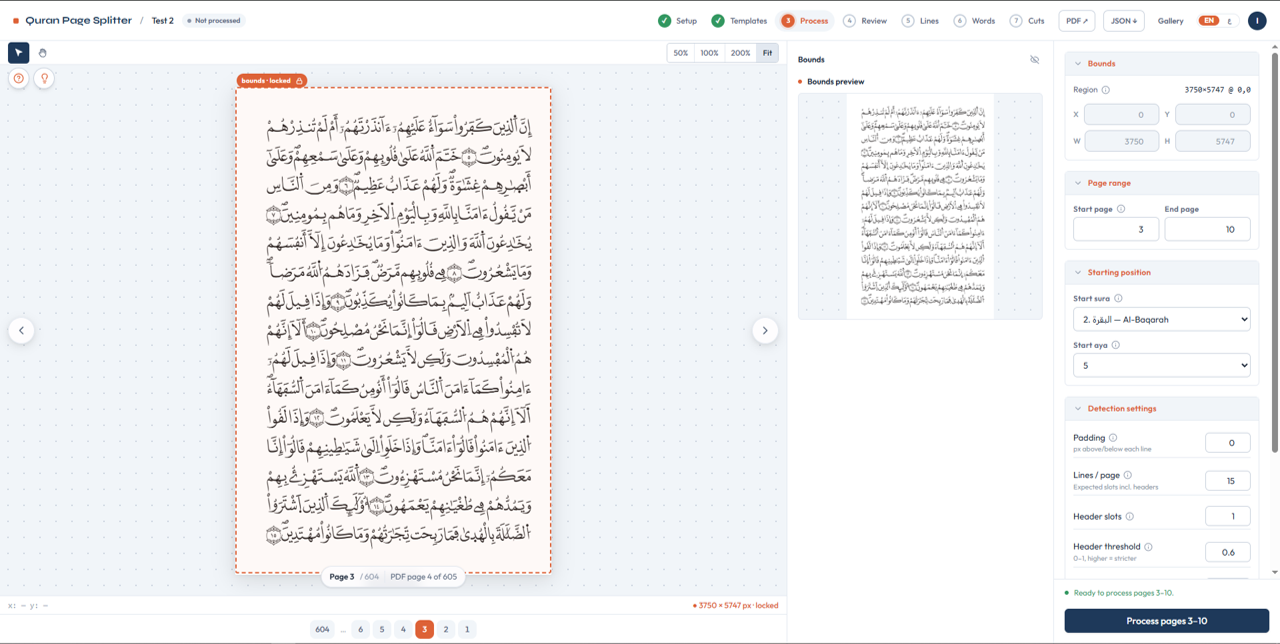
تحديد بعض المعايير الأخرى:
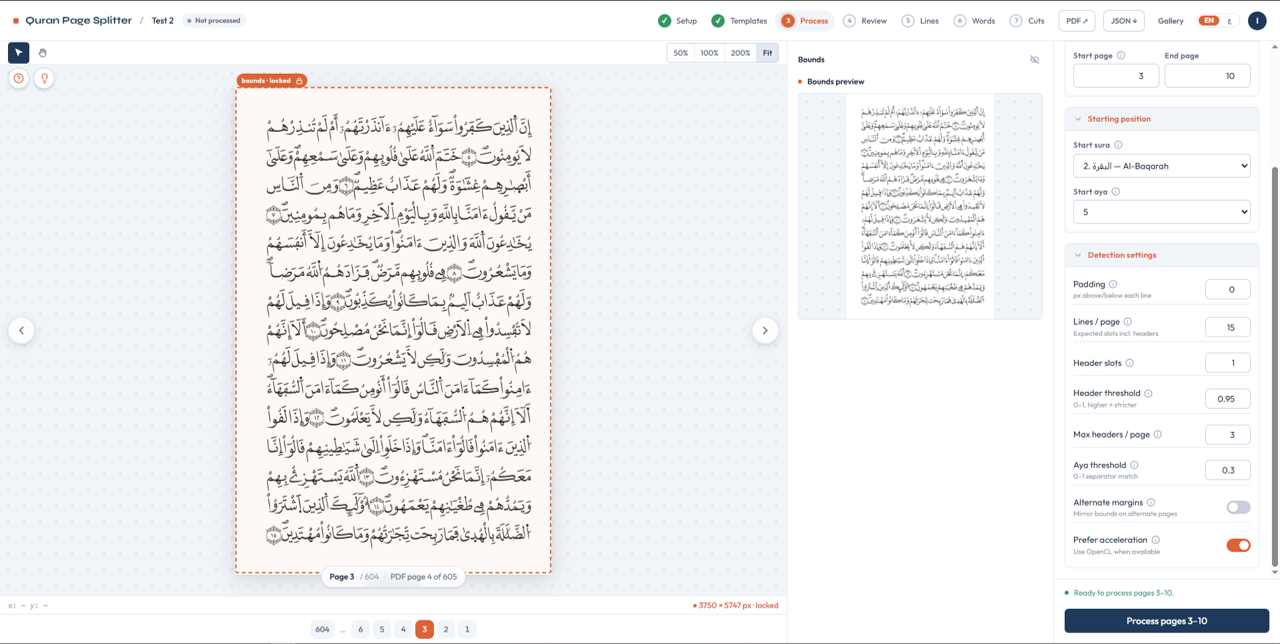
padding: وهي المساحة الإضافية التي ستتم إضافتها إلى المحتوى قبل القص لتحسين الجودة البصرية.
Lines/Page: عدد الأسطر التي يجب أن يحتويها كل صفحة. ويُستخدم ذلك للتحقق من صحة الأسطر التي تم التعرّف عليها.
Header Slots: عدد الأسطر التي يشغلها عنوان السورة. معظم المصاحف تستخدم سطرًا واحدًا، لكن بعضها يستخدم سطرين، مثل الشمرلي.
header_threshold: يقوم المعالج بمسح صفحة المصحف وعند كل موضع يقارن قالب اسم السورة مع المساحة تحته ويعطي هذا الموضع درجة تطابق "score". هذا المعيار "header_threshold" هو الحد الأدنى المقبول لدرجة التطابق حتى يُعتبر هذا الموضع عنوان سورة صالحًا.
Max headers/page: الحد الأقصى لعدد عناوين السور التي يمكن أن تظهر في صفحة واحدة. ويُستخدم ذلك للتحقق من صحة العناوين التي تم التعرّف عليها. كذلك، لم أجد مصحفًا يحتوي على أكثر أو أقل من 3 عناوين في صفحة واحدة كحد أقصى. ولكن وجود بقاء المعيار للتأكد من تغطية أي مصحف يختلف في هذه الحالة.
aya_threshold: مشابه لـ header_threshold، ولكن بالنسبة إلى قالب فاصل الآية. ويقوم بالمسح داخل كل سطر، وليس الصفحة بالكامل.
alternate_margins: بعد تحديد bounds، سيستخدم المحرّك هذه الحدود لجميع الصفحات، وليس الصفحة التي تم تحديدها منها فقط. لكن بعض المصاحف تحتوي على هوامش مختلفة في الصفحات الفردية والزوجية، بحيث تكون الهوامش معكوسة؛ أي إن قيم الهامش الأيسر والأيمن تتبادل أماكنها من صفحة إلى أخرى. في هذه الحالة، اجعل هذه القيمة true، وإلا فاجعلها false. وهذا يساعد المحرّك على تحديد منطقة المسح الصحيحة في الصفحات.
prefer_acceleration: يستطيع المحرّك استخدام تسريع GPU لتسريع المعالجة، لكنه ليس متاحًا دائمًا. فإذا كان لديك GPU وتريد استخدامه، اجعل هذه القيمة true، وإلا اجعلها false. إذا تم ضبطها على true وفشل المحرّك في استخدام الـGPU، فسوف يعود تلقائيًا إلى المعالجة باستخدام CPU. استخدام GPU أسرع، لكن له تكلفة بسيطة جدًا على الدقة. لذلك، إذا كان هدفك الحصول على أفضل دقة، اجعلها false. لكن لا شيء مثالي، ويمكنك تسريع المعالجة ومعالجة الأخطاء يدويًا لاحقًا؛ فالدقة ما زالت أعلى من 95%.
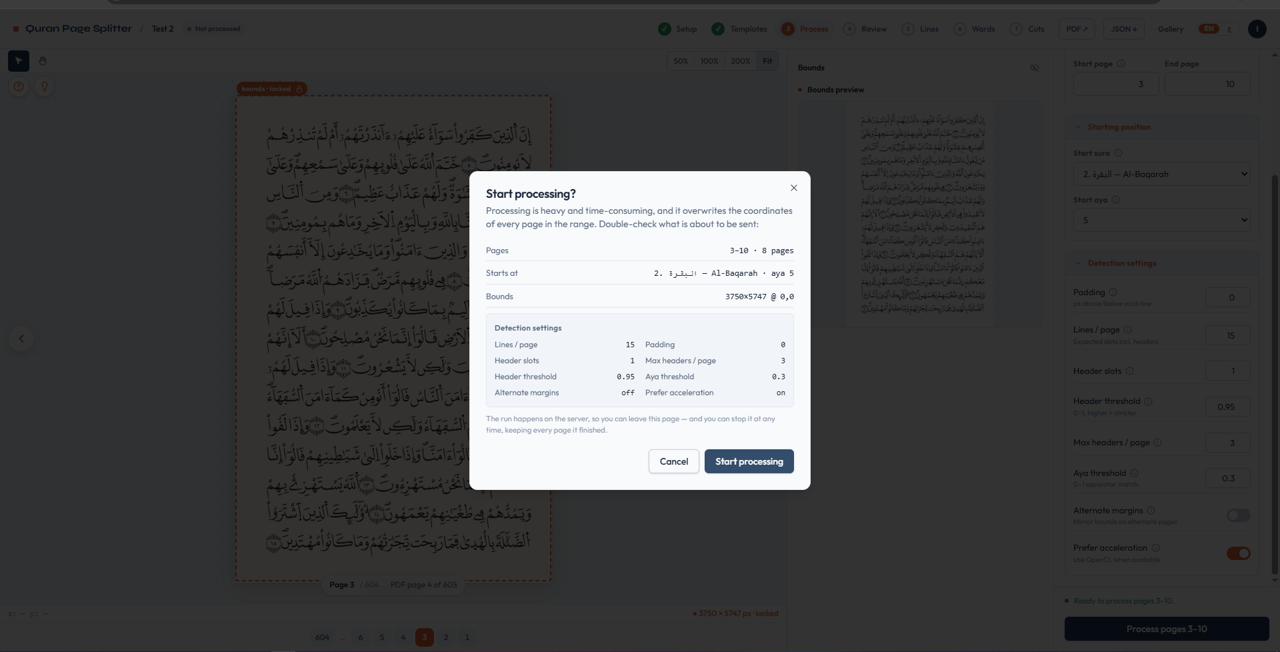
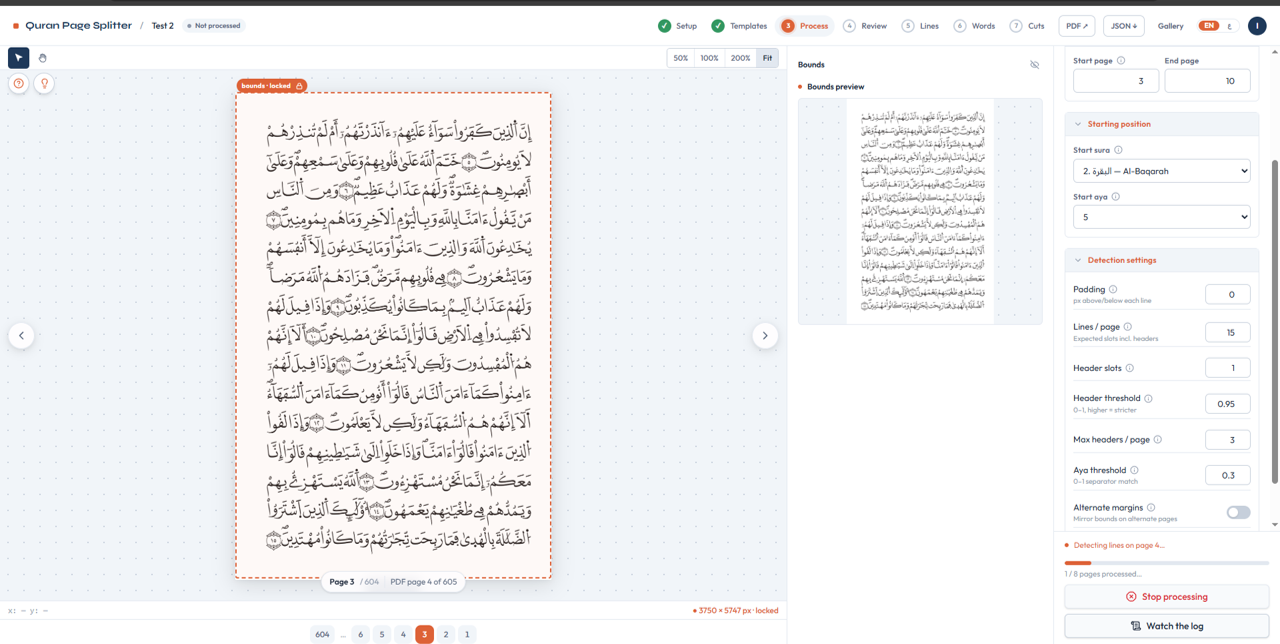
بعد الانتهاء من تحديد هذه المعايير، يضغط المستخدم على زر "Start processing" فيقوم التطبيق ببدء المعالجة، ويقوم المحرّك بمعالجة الصفحات واحدة تلو الأخرى، مع عرض التقدّم في الوقت الفعلي. ويحدث هذا بشكل مواز أي يمكن الانتقال للصفحة التالية والتي تعرض نتائج المعالجة وتمكن المستخدم من تصحيح الأخطاء يدويًا دون الحاجة لانتظار المعالج من الانتهاء من معالجة جميع الصفحات.
Review
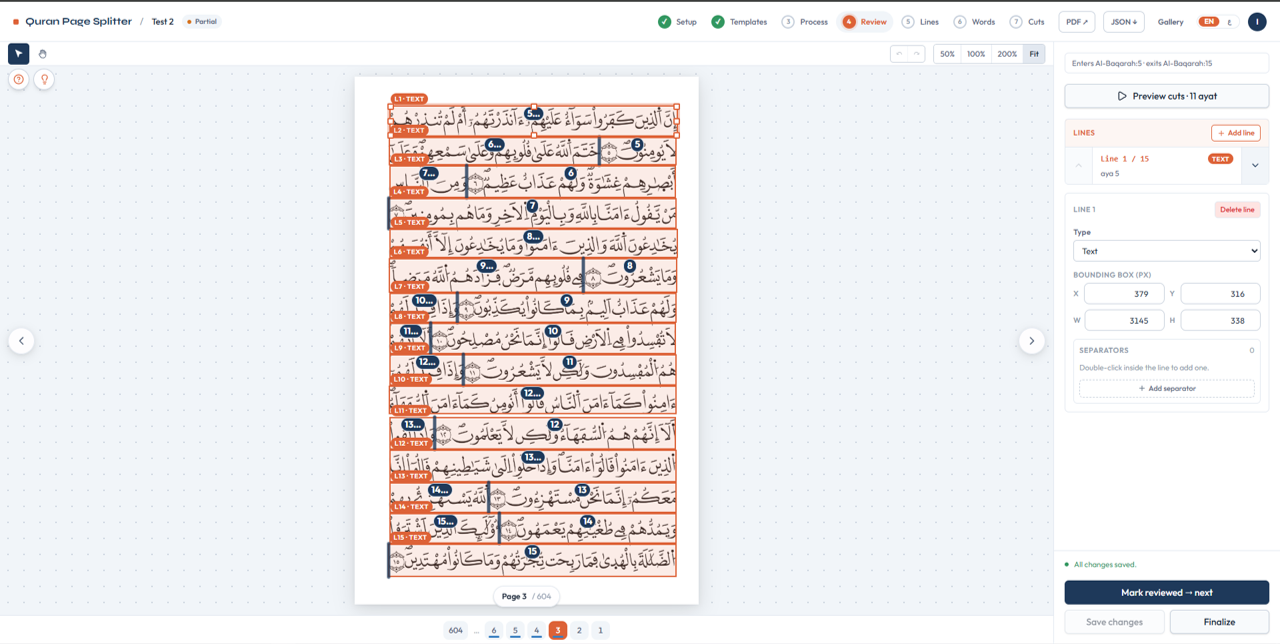
بعد انتهاء المعالجة، يمكن للمستخدم مراجعة النتائج، وتصحيح أي أخطاء يراها، ثم حفظ النتائج النهائية.
يمكن رؤية منطقة السطر التي تعرف عليها المعالج محاطة بمستطيل أحمر، ويمكن رؤية موضع الآية كخط رأسي أزرق. ويمكن للمستخدم تعديل هذه الاحداثيات بسهولة هن طريق السحب والضغط.
Lines
الخطوة السابقة تركز أكثر على احدائيات الآيات وخاصة أين تبدأ وتنتهي الآية. أما هذه الصفحة فتساعد المستخدم على تصدير الأسطر كصور png. فهي تعطي السمتخدم أدوات تغيير الارتفاع ونقطة البدأ الرأسية للسطر، كما أنها تعطيه القدرة على مسح أي حبر متداخل مع كل سطر من السطور الأخرى أعلاه وأسفله.
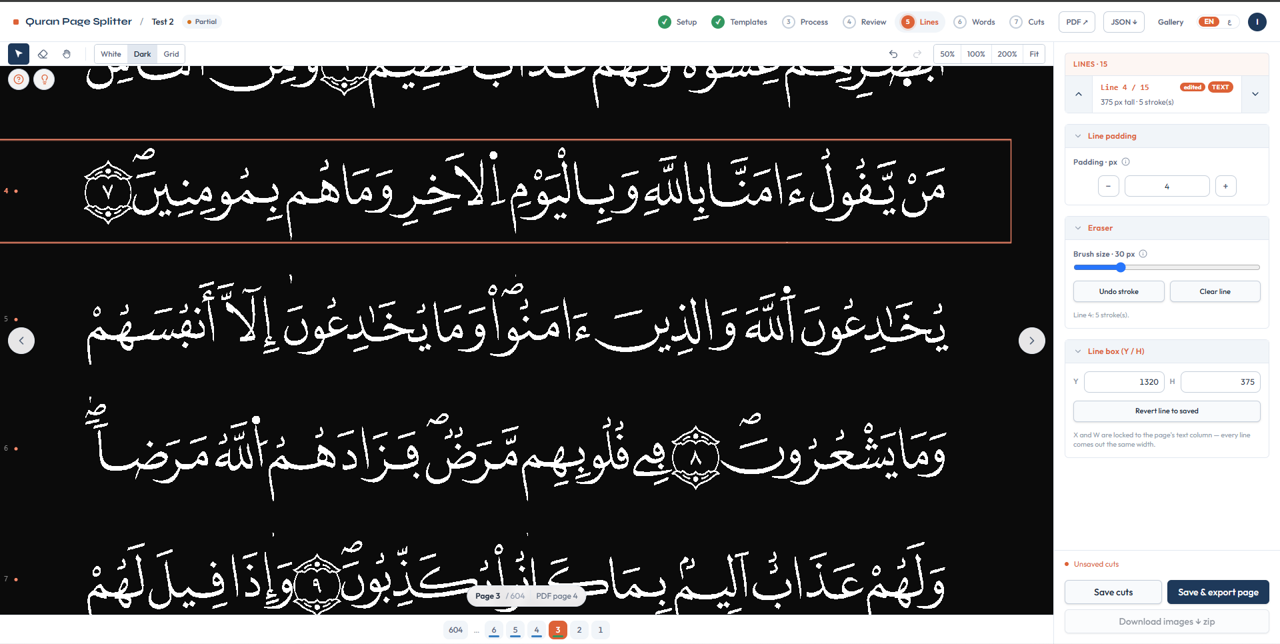
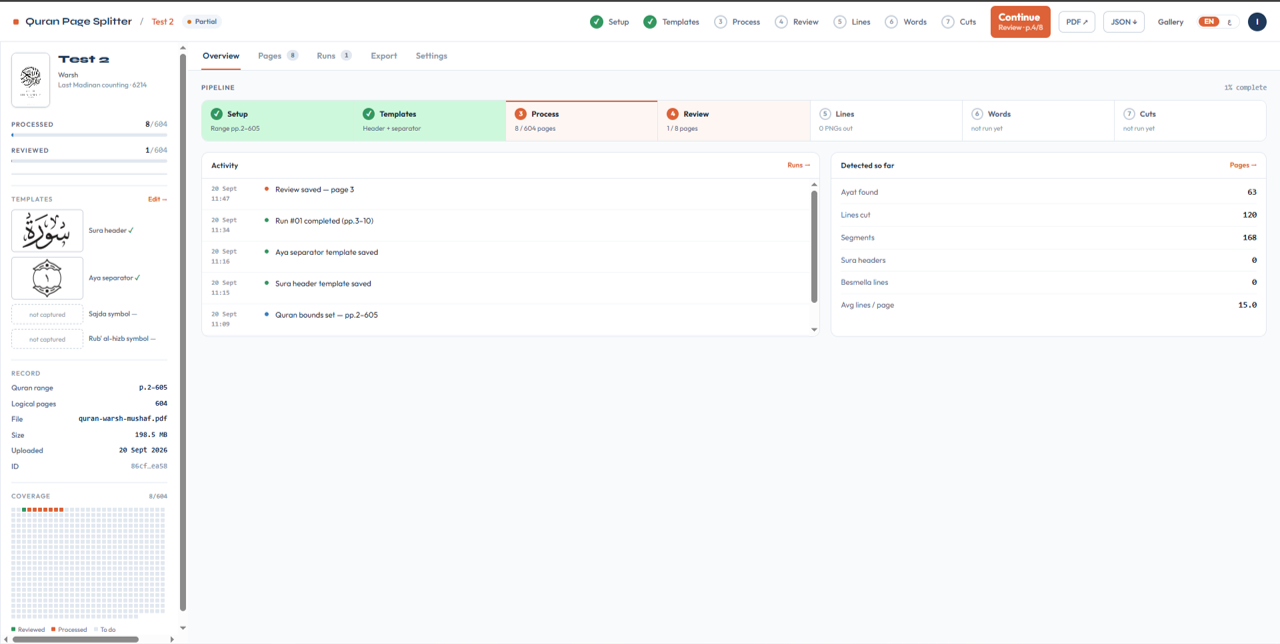
عملية التصدير تتم من صفحة التفاصيل الخاصة بالمصحف ولكن يوجد بعض الأزرار المساعدة والتي يمكن استخدامها للتصدير.
كيف يعمل المحرّك
المتطلبات (المدخلات)
يحتاج هذا المحرّك إلى ما يلي:
ملف PDF للمصحف.
نطاق الصفحات.
تحديد صفحات القرآن في المصحف باستبعاد صفحات الملاحق. ويتم ذلك في أول خطوة بعد رفع ملف الـPDF، في قسم SetUp في التطبيق.
كذلك يجب استبعاد سورة الفاتحة والصفحة الأولى من سورة البقرة، لأن المحرّك غير قادر على معالجتهما بسبب بعض القيود. ويتم التعامل معهما يدويًا.
يتم تحديد الصفحات المراد معالجتها في المرة الواحدة في قسم processing في التطبيق.
الآية (السورة، الآية) التي يبدأ منها المعالجة والتي يستخدمها المعالج في الترقيم.
قالب sura_header وقالب aya_separator:
- قالب sura_header: صورة تحتوي على اسم السورة مع زخرفته، ويتم قصّها مباشرة من المصحف من سورة غير الفاتحة أو البقرة (إن وُجدت)، لأنهما أثبتتا إنتاج أخطاء ودرجات تطابق سيئة أثناء المعالجة.
قالب aya_separator: صورة تحتوي على رقم الآية مع الدائرة المزخرفة حوله، ويتم قصّها مباشرة من المصحف من أي موضع.
- يجب قصّ كل قالب بشكل نظيف، من دون أي حبر إضافي حوله، ومن دون فقدان أي جزء من الحبر الخاص به. أما المساحات البيضاء حوله فهي مقبولة.
- يتم تنفيذ هذه الخطوة في قسم Templates.
- اختياريًا، يمكنك تحديد المنطقة داخل كل قالب التي تتغير بشكل متكرر، مثل رقم الآية في aya_separator أو اسم السورة في sura_header. وهذا يساعد المحرّك على التركيز على الأجزاء الثابتة من القالب وتحسين الدقة.
bounds: وهي قيم x, y, w, h التي تحدد منطقة النص في الصفحة، مع تجاهل الإطارات المزخرفة وأي زخارف تقع خارج هذا الصندوق. يجب أن يعالج المحرّك النص الموجود داخل هذه المنطقة فقط، بالإضافة إلى قالب sura_header بالطبع.
Lines/Page: سبق الحديث عنها بالأعلى
Header Slots: سبق الحديث عنها بالأعلى
Max headers/page: سبق الحديث عنها بالأعلى
padding: المساحة الإضافية التي ستتم إضافتها قبل القص وبعد التعرّف على النص. وتستخدم فقط لتحسين الجودة البصرية.
header_threshold: يتم استخدام قالب sura_header لمسح الصفحة بالكامل، نقطة بنقطة، والحصول على درجة تطابق "score" لكل منطقة يغطيها القالب. ويحدد هذا المتغير الحد الأدنى المقبول لدرجة التطابق حتى تُعتبر المنطقة عنوان سورة صالحًا.
aya_threshold: مشابه لـ header_threshold، ولكن بالنسبة إلى قالب aya_separator. ويقوم بالمسح داخل كل سطر، وليس الصفحة بالكامل.
alternate_margins: سبق الحديث عنها بالأعلى
prefer_acceleration: سبق الحديث عنها بالأعلى
خطوات عمل المحرك
يبدأ المحرّك بتجهيز صورة القالب، وذلك بتحويلها إلى grayscale ثم إلى صورة ثنائية binary، بحيث يكون الحبر = 255 والخلفية = 0، ثم يقوم بتضييق الصورة لتقتصر على قالب عنوان السورة أو قالب فاصل الآية نفسه، وإزالة المساحات البيضاء الإضافية حوله. كما يقوم أيضًا بتجهيز المنطقة المتغيرة من القالب من خلال إنشاء قناع mask لها. جميع البيانات المتعلقة بالقالب يحملها الـdataclass المسمى TemplateSpec.
يقوم المحرّك بتجهيز القوالب كجزء من خطوة تجهيز الـlocators، وهما SuraHeaderLocator وAyaSeparatorProcessor، وهما المسؤولان عن هذا الجزء من العمل.
تبدأ المعالجة الفعلية من هذا الجزء من الكود:
output = pipeline.run(
    images,
    filenames=filenames,
    should_cancel=should_cancel,
    on_page_start=lambda index, _name: report("detecting", page_range_start + index - 1),
    on_page_done=persist,
)
وهو موجود داخل pipeline.run.
ملاحظة!
هناك بعض عمليات التجهيز الأخرى التي ينفذها الكود، مثل تجهيز الـlogging، وتسريع OpenCV، وعرض التقدّم، وإلغاء العملية، لكنها غير مرتبطة بالمعالجة الفعلية للصفحات، ولذلك لن أشرحها هنا.
تبدأ العملية بإنشاء الـtracker المسمى tracker، وهو المسؤول عن ترقيم السور والآيات بعد اكتشاف الإحداثيات. ويتم تهيئته باستخدام الآية (السورة، الآية) التي يبدأ منها نطاق الصفحات.
ثم يبدأ في معالجة الصفحات داخل loop، صفحة تلو الأخرى، وإنشاء الـcontext الخاص بكل صفحة، ctx. ويحتوي هذا الـcontext على جميع البيانات المطلوبة وجميع البيانات التي تتم معالجتها حتى انتهاء العملية. وداخله توجد صورة الصفحة الأصلية، ومصفوفاتها بصيغتي binary وgreyscale:
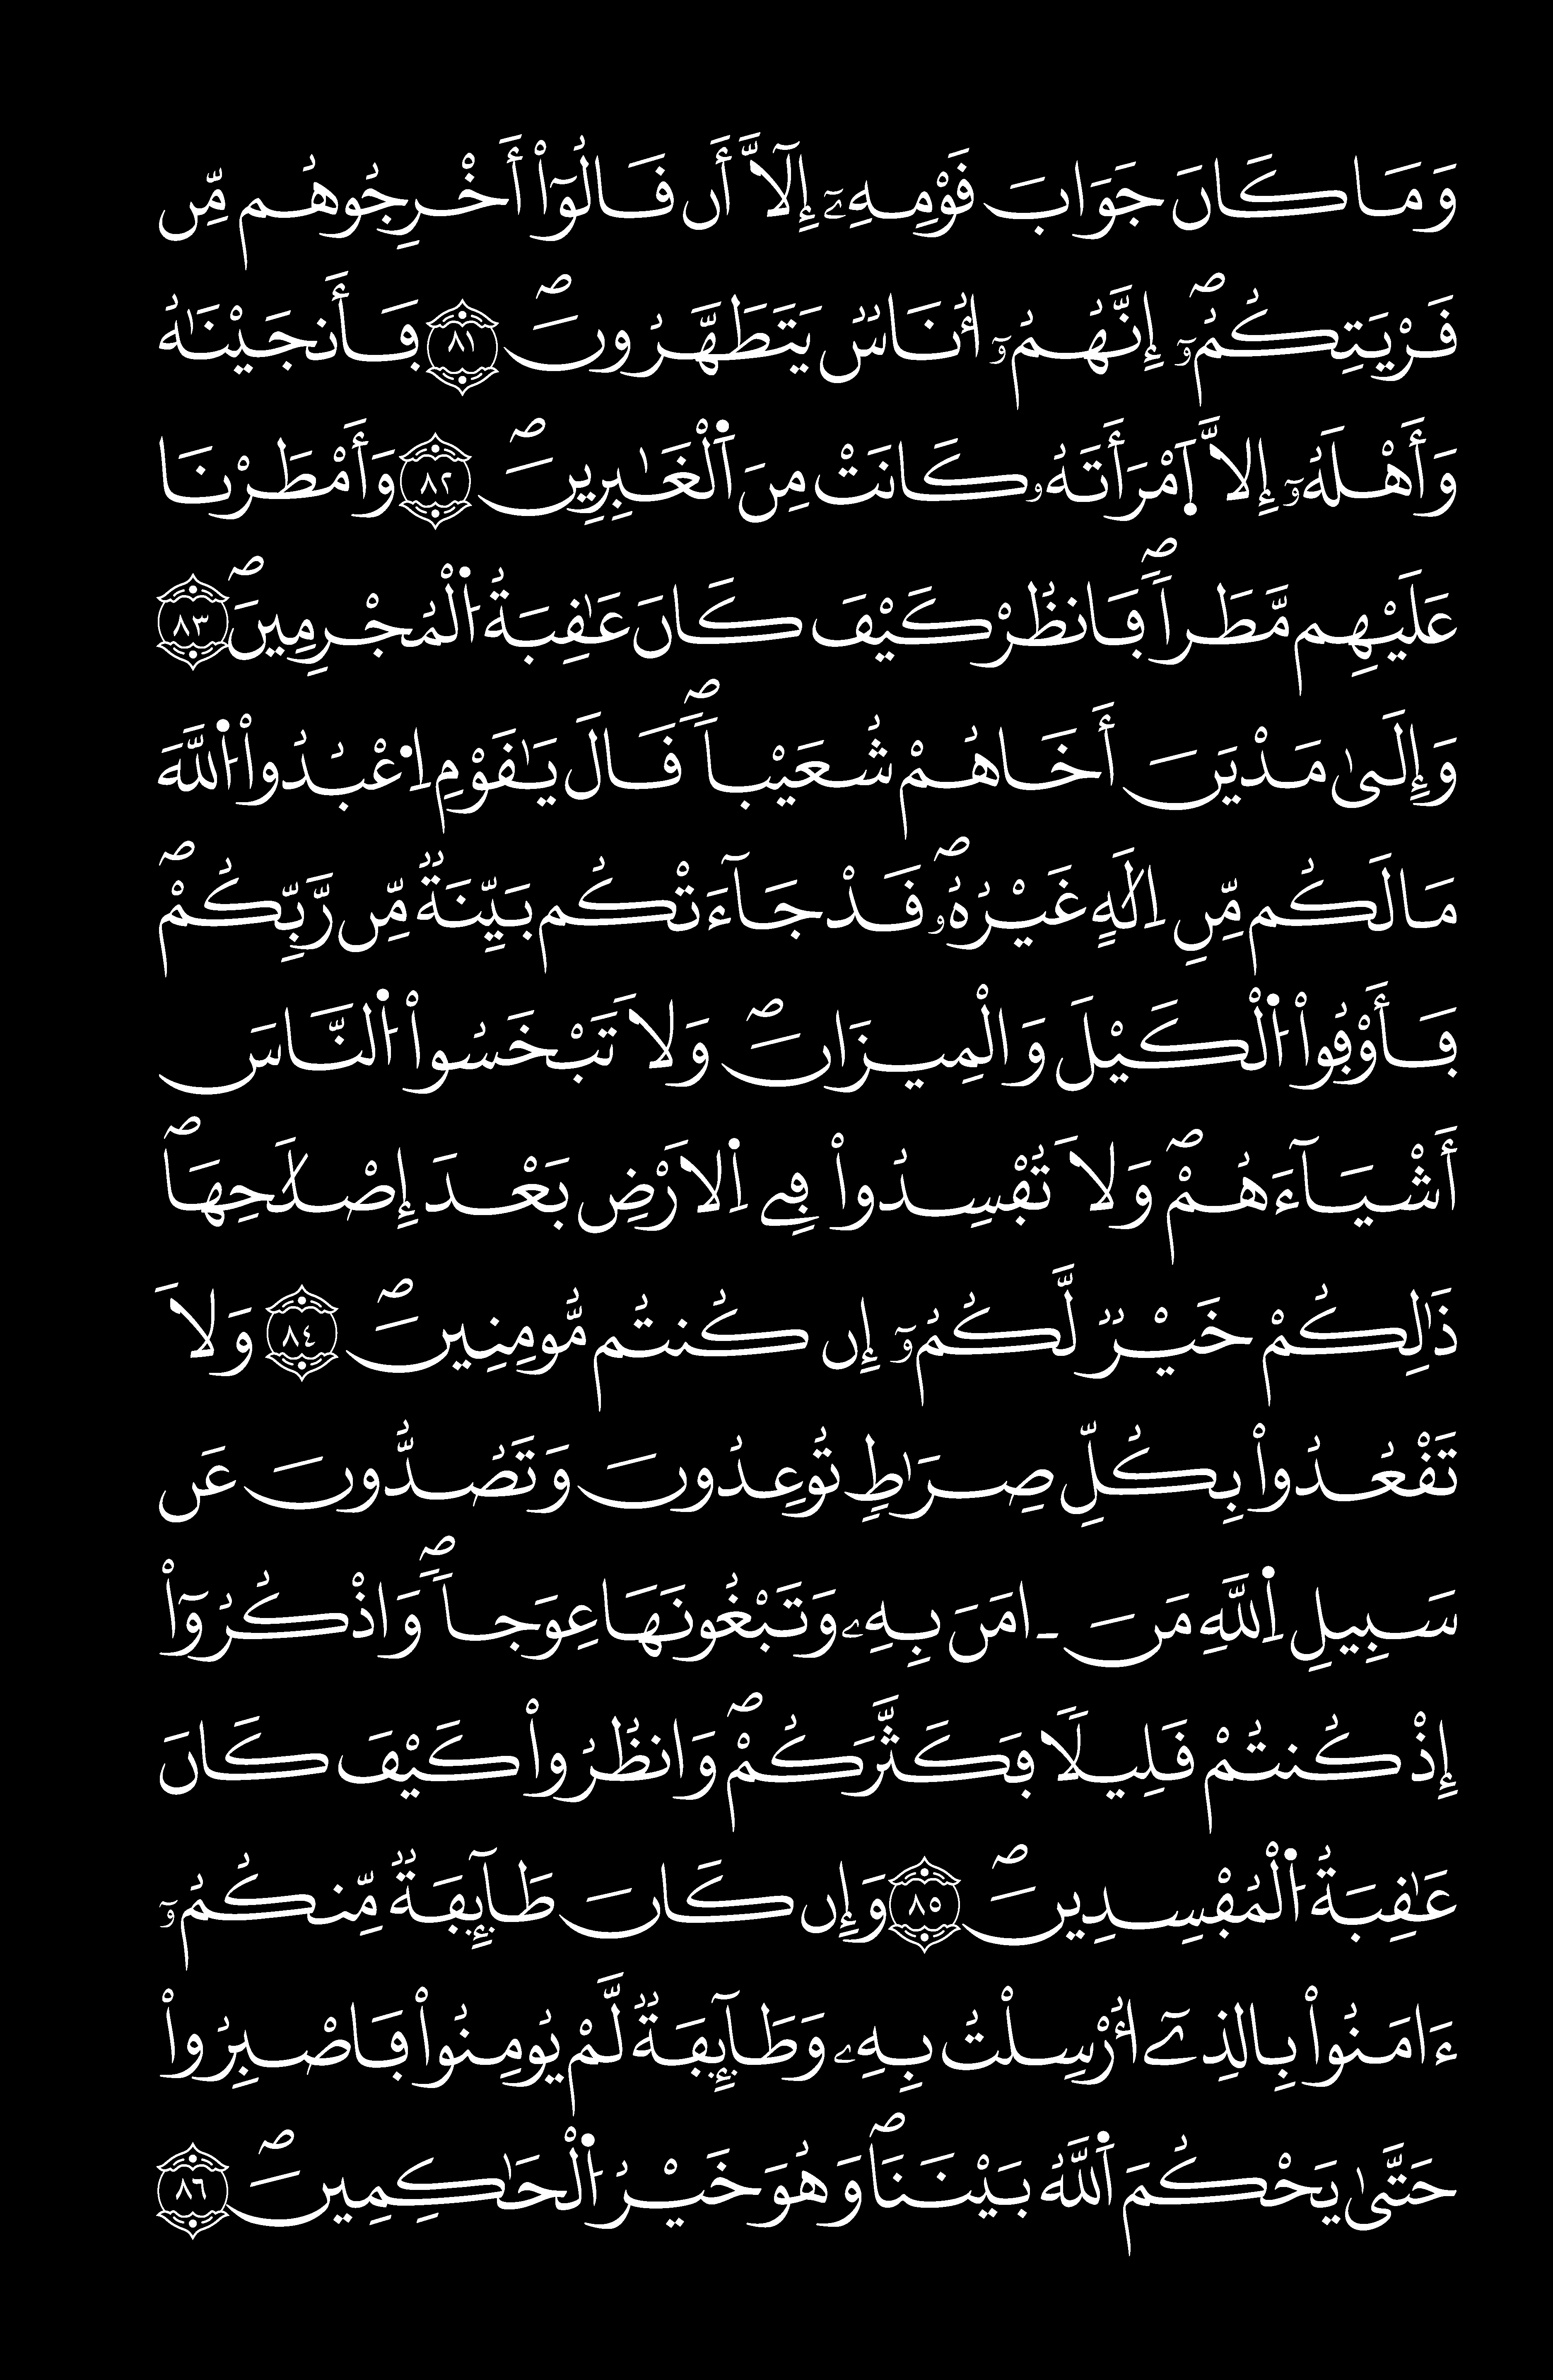
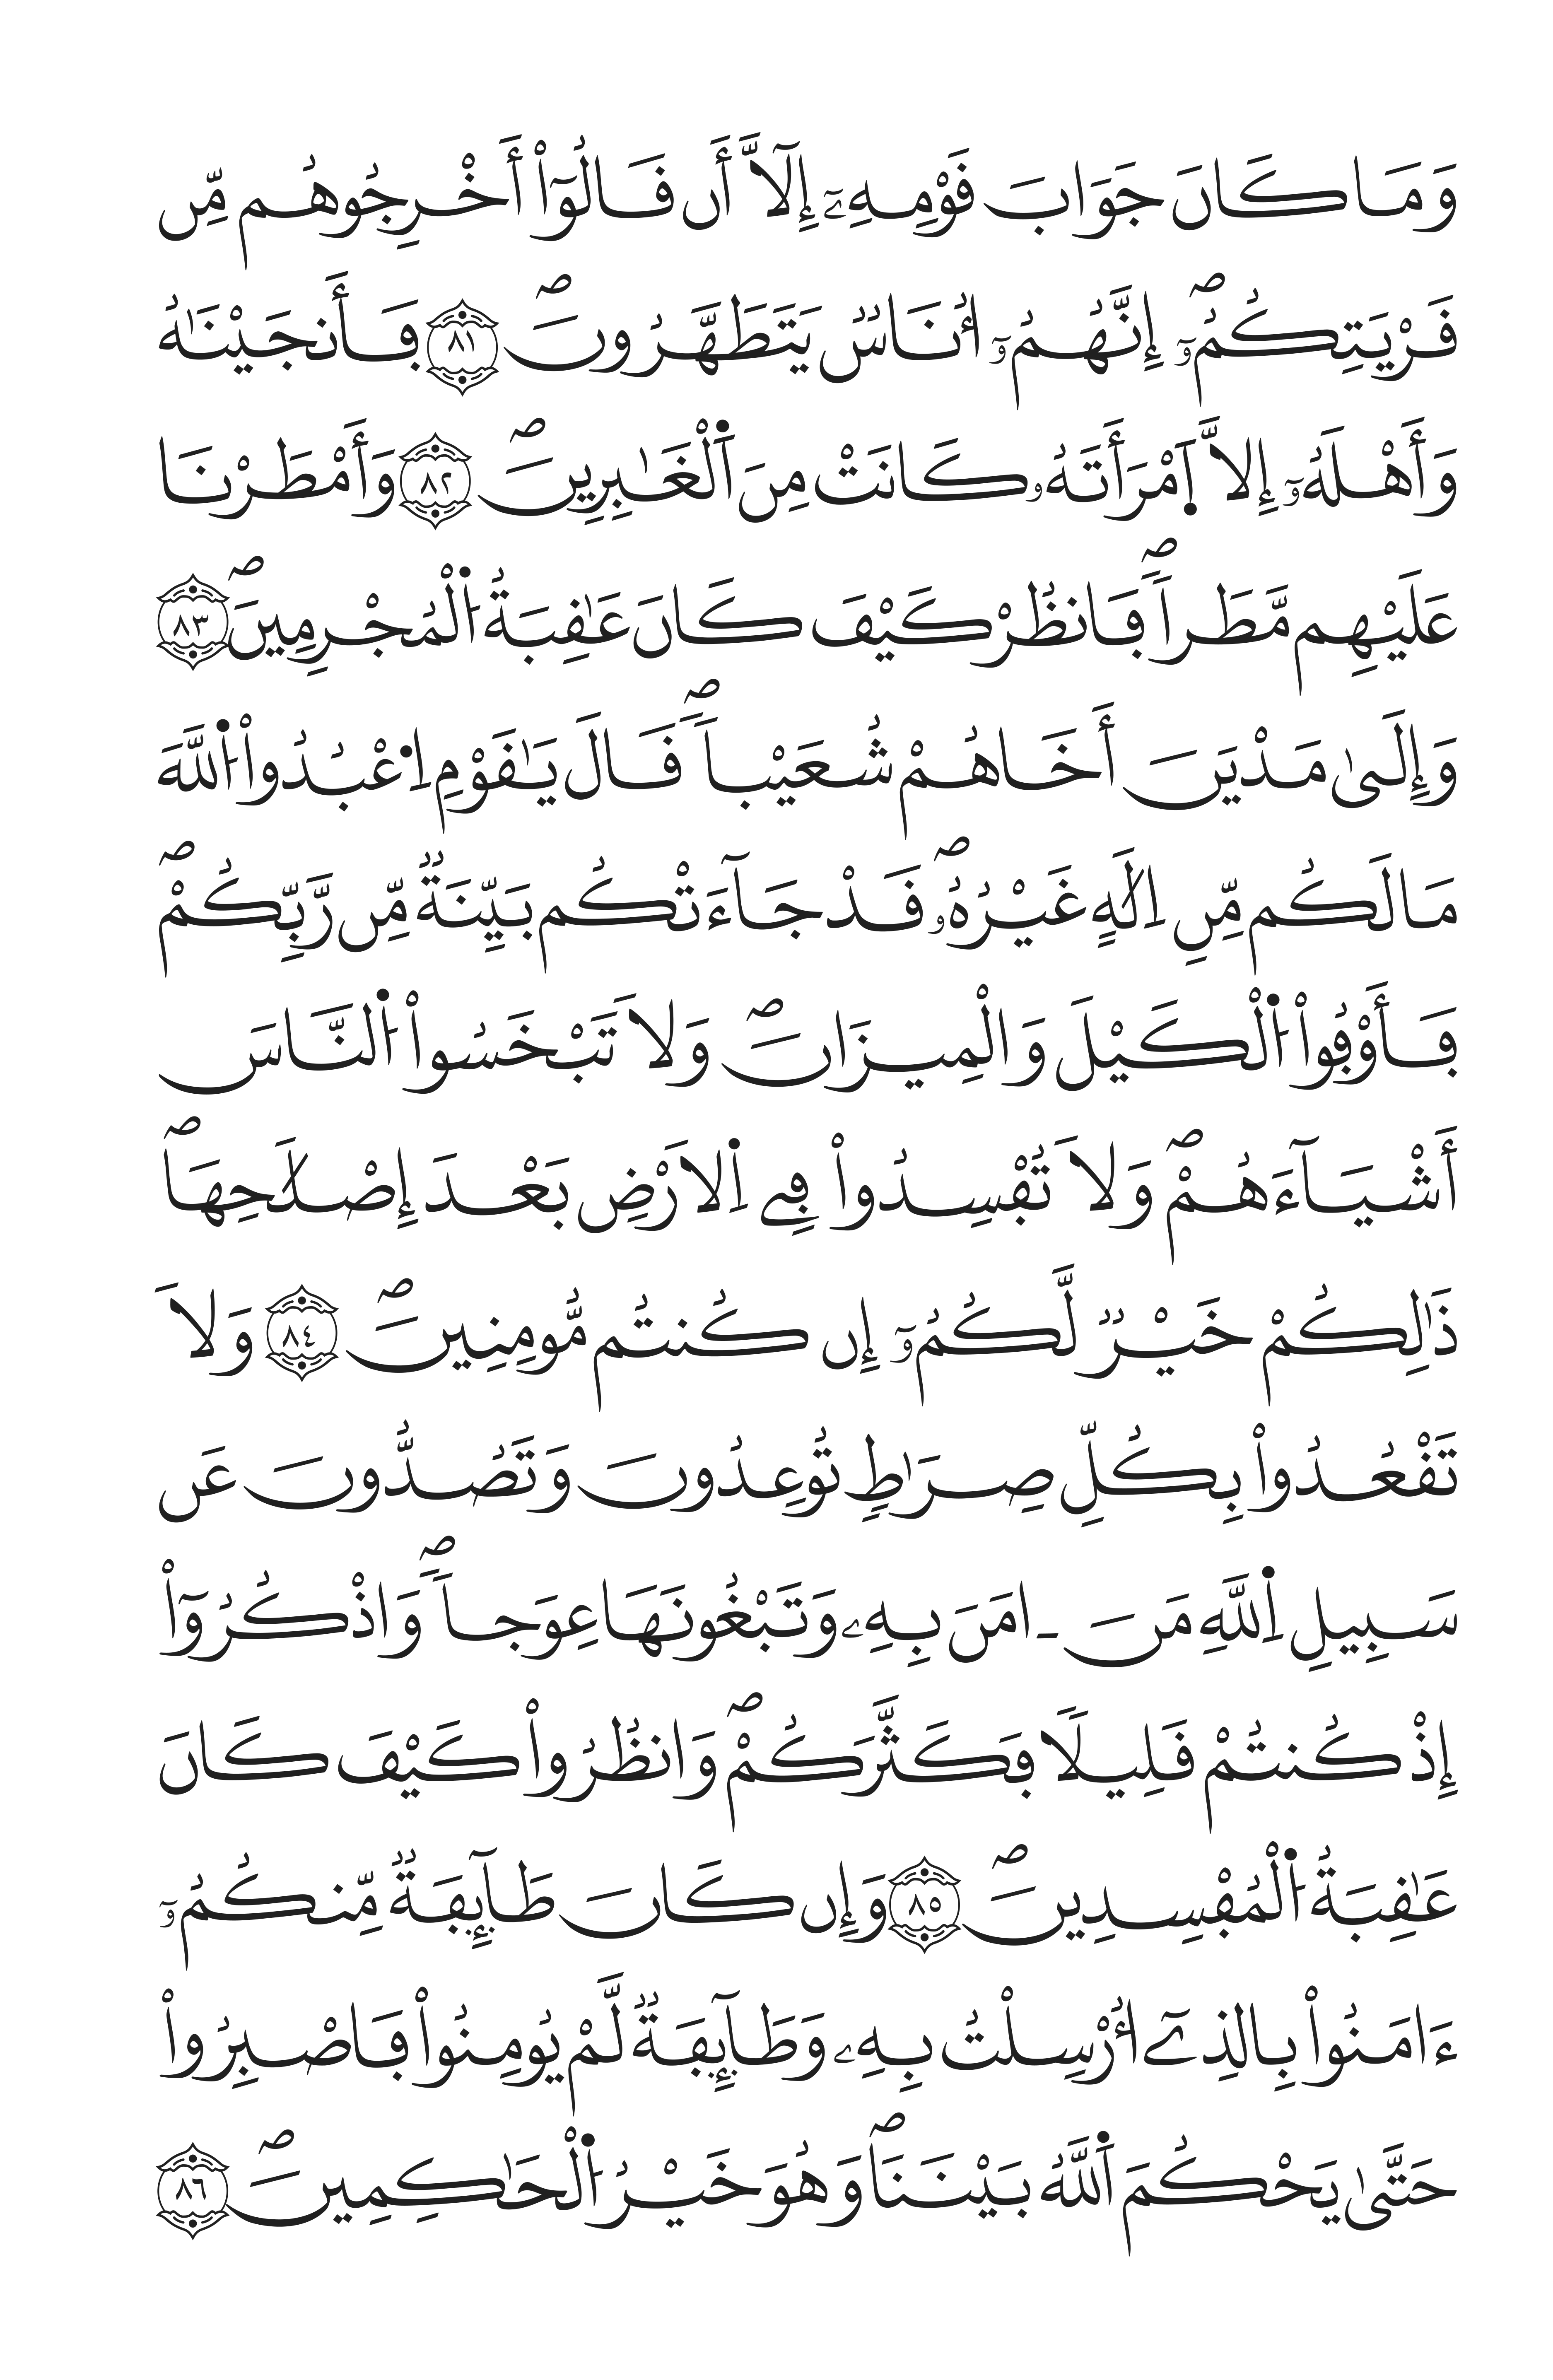
بعد ذلك يستدعي self.processor.process، ولكل صفحة يقوم بالخطوات التالية:
process method تستدعي detect method
داخل detect يتأكد المحرّك من أنه يعمل داخل منطقة المحتوى الخاصة بالصفحة، وذلك بعد استخدام bounds وalternate_margins لتحديد منطقة المحتوى الصحيحة للصفحة.
ثم يقوم بتضييق الصفحة لتقتصر على منطقة المحتوى.
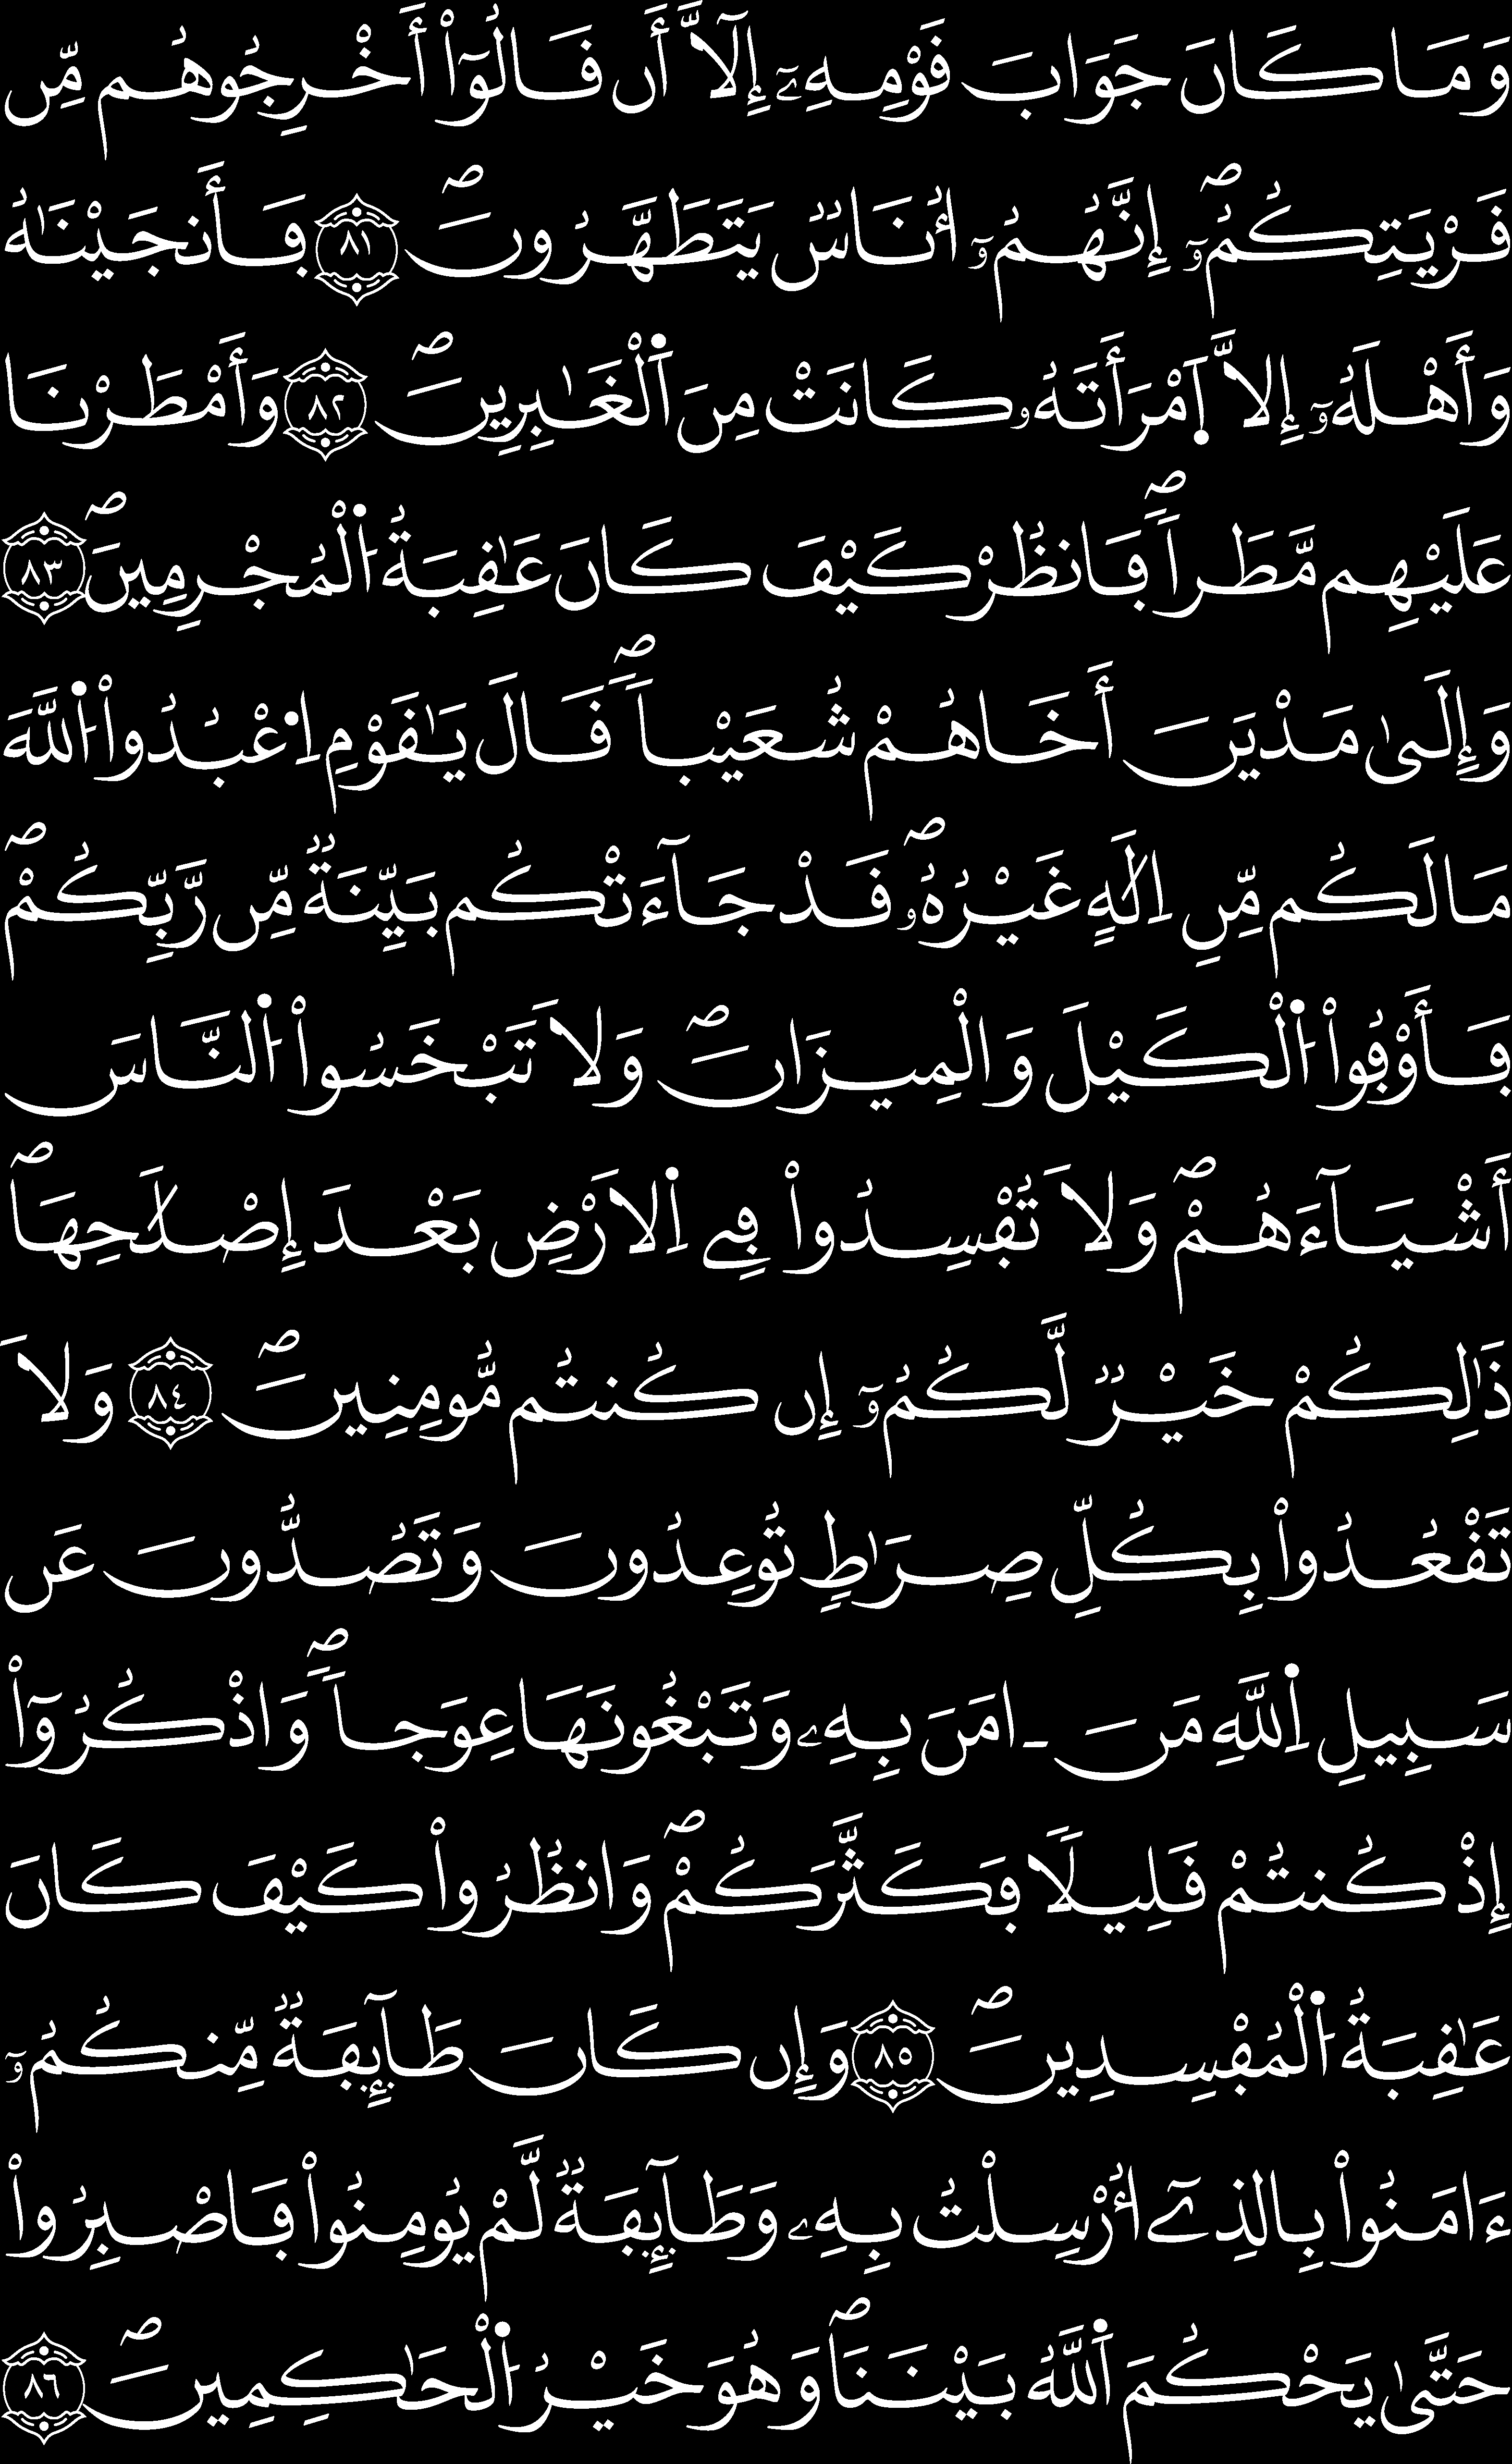
ثم يبدأ في اكتشاف الـbands:
هناك نوعان من الـbands: sura header bands وtext bands.
وقبل اكتشاف text bands، يقوم أولًا باكتشاف sura header bands.
ويتم اكتشاف sura header bands كالتالي:
يمسح الصفحة بالكامل باستخدام قالب sura_header من خلال الدالة cv2.matchTemplate، ويحصل على درجات لكل منطقة يغطيها القالب.
يرشّح المناطق التي حصلت على درجة أعلى من header_threshold.
يرتّب المناطق التي تم العثور عليها تنازليًا حسب درجة التطابق.
بعد ذلك يمر عليها بالترتيب، ويضيف المنطقة إلى قائمة الـbands التي تم اكتشافها إذا لم تتداخل مع أي من الـbands التي تم قبولها مسبقًا. والهدف من ذلك هو تجنّب اكتشاف عنوان السورة نفسه أكثر من مرة، وكذلك تجنّب قبول المواضع المتقاربة التي قد تحصل على درجات عالية حول نفس العنوان؛ كأن يتم قبول موضع أعلى العنوان أو أسفله ببضعة صفوف.
ثم يرتّب الـbands التي تم العثور عليها تصاعديًا حسب إحداثي y.
يتم تخزين sura_header bands في الـcontext ctx داخل sura_headers.
أما text bands فيتم اكتشافها كالتالي:
يبحث عن المناطق التي لم يتم حجزها لعناوين السور، ويعتبرها text bands إذا تجاوز ارتفاعها الحد الأدنى لارتفاع منطقة نصية، وهو ارتفاع السطر مضروبًا في عدد الأسطر في الصفحة.
ثم يتحقق من الارتفاع الكلي للتأكد من أنه لا يتجاوز ارتفاع الصفحة.
بعد اكتشاف الـbands، يبدأ في المرور عليها، ولكل band يبدأ في اكتشاف الأسطر وتقسيمها كالتالي:
يحسب مجموع البكسلات في كل صف من صفوف الـband.
يمكن تمثيل النتيجة كإشارة أحادية البعد 1D signal، وتكون القيم الدنيا المحلية لهذه الإشارة هي الفواصل بين الأسطر.
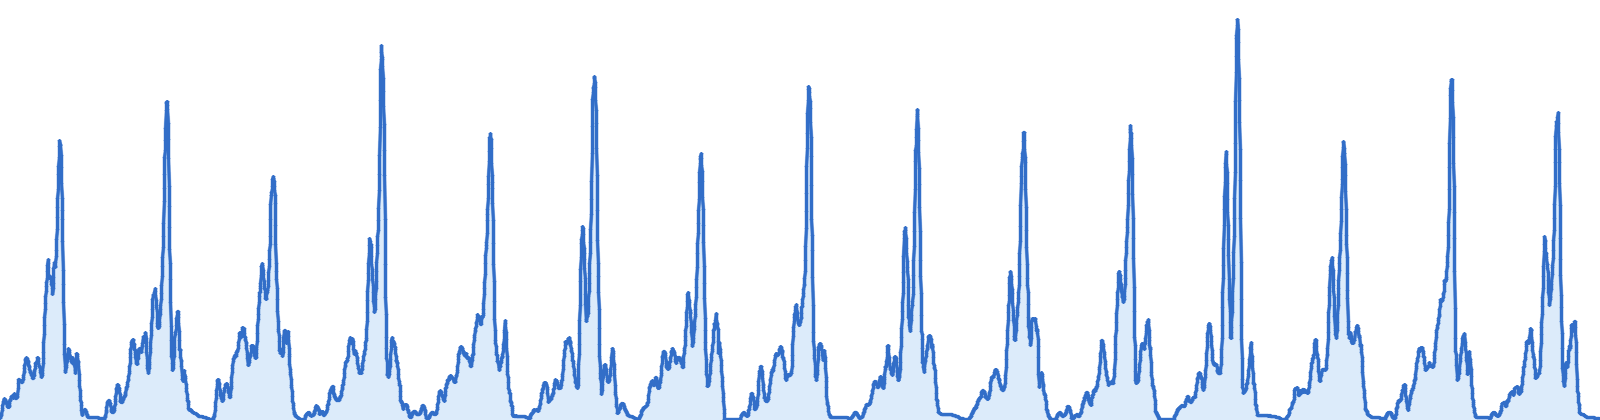
قد يبدو الرسم الناتج كإشارة خشنة جدًا، لذلك يتم تنعيمه باستخدام:
def _smooth(profile: np.ndarray, kernel_size: int) -> np.ndarray:
    """Apply a small moving-average to reduce single-row noise."""
    kernel = np.ones(kernel_size) / kernel_size
    return np.convolve(profile, kernel, mode="same")
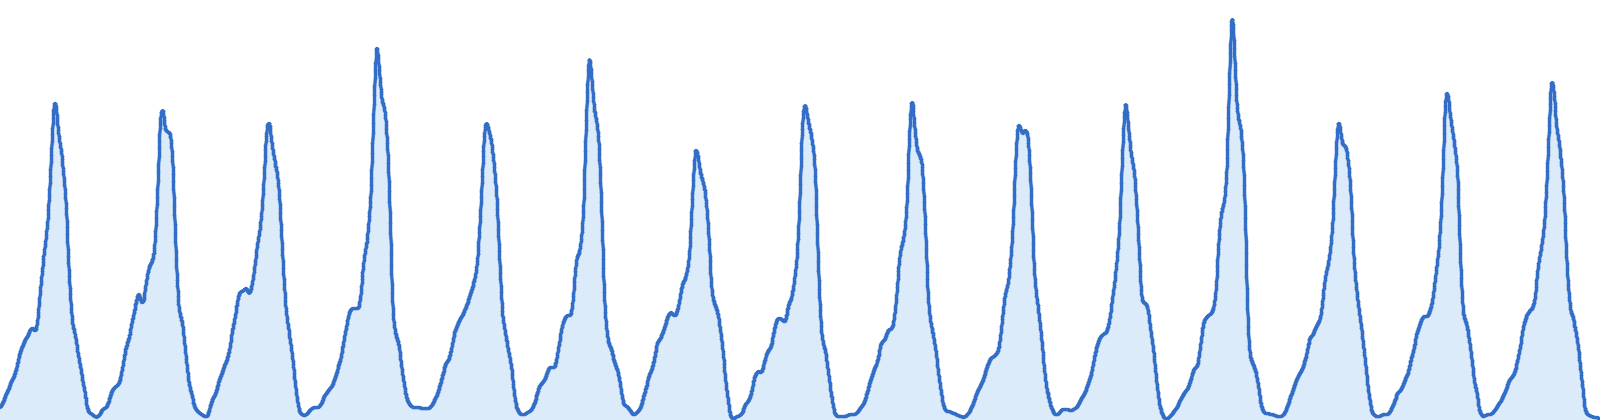
يتم اكتشاف القيم الدنيا المحلية minimas باستخدام التفاضل والنهايات:
def _find_local_minima(profile: np.ndarray) -> list[int]:
    """Return indices of all local minima (strict descent then ascent)."""
    diff = np.diff(profile)
    # A minimum at i means: diff[i-1] <= 0 (descending/flat) AND
    # diff[i] >= 0 (ascending/flat), with at least one strict inequality.
    descending = diff[:-1] <= 0
    ascending = diff[1:] >= 0
    strict = (diff[:-1] < 0) | (diff[1:] > 0)
    mask = descending & ascending & strict
    # Offset by 1 because diff shifts indices
    return (np.where[mask](0) + 1).tolist()  # type: ignore[no-any-return]
يحسب بعد ذلك الـtopographic prominence. ولكل valley مرشّح، يقيس المحرّك مدى عمقه مقارنة بالقمم المحيطة به. فالـvalley العميق والواضح هو مرشّح أقوى ليكون حدًا بين سطرين من انخفاض بسيط ناتج عن اختلاف كثافة الحبر داخل السطر.
ثم يرتب هذه القيم الدنيا المحلية تنازليًا حسب الـprominence، ويحتفظ بأعلى Lines/Page - 1 منها، مع التأكد من عدم تداخلها باعتبارها الفواصل بين الأسطر.
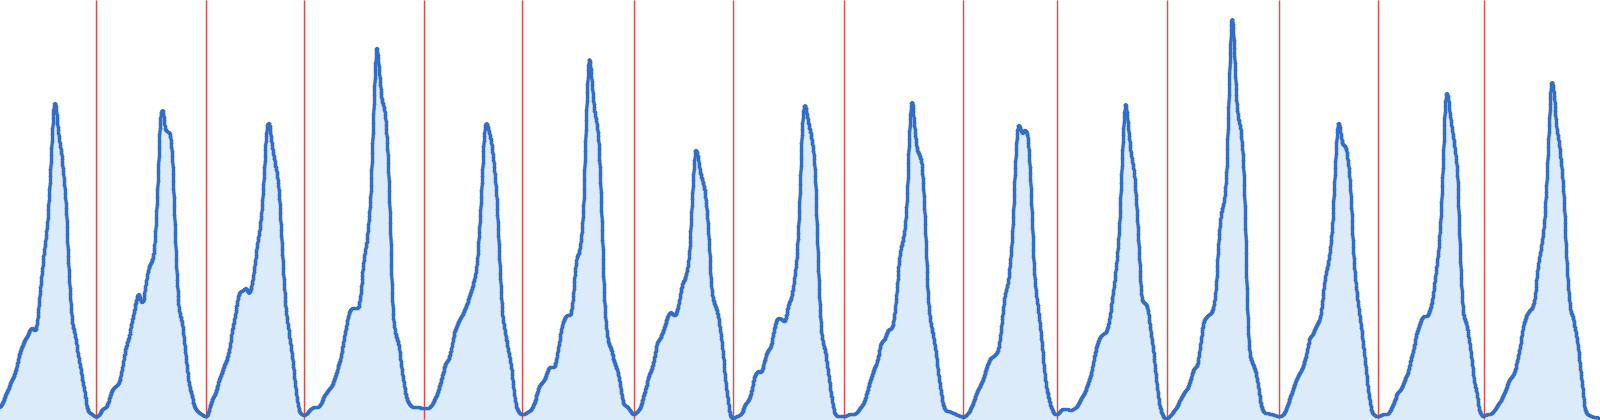
وأخيرًا يعيد تحويل مواضع الـvalleys إلى الإحداثيات الأصلية.
بعد انتهاء الاكتشاف، يتم تخزين جميع الأسطر والعناوين التي تم العثور عليها في ctx.lines، حيث يتم تمثيل عناوين السور داخليًا ككائنات LineResult تحمل is_sura=True؛ بينما تمثلها طبقة التصدير لاحقًا على شكل type="sura_header".
بعد ذلك يتحقق المحرّك من أن عدد الأسطر والعناوين المكتشفة يساوي تمامًا عدد الأسطر المحدد للصفحة، مع مراعاة الـheader slots.
ثم يمر على الأسطر التي تم اكتشافها، ويقسم كل سطر إلى segments، أي يقسم السطر اعتمادًا على aya_separator، كما يلي:
يبدأ من self.aya_separator.split_segments(ctx).
إذا كان السطر sura_header، يتم تخطيه.
يتم تضييق السطر لإزالة المساحات البيضاء الزائدة حوله. وإذا نتج عن ذلك سطر فارغ، يتم تخطيه.
إذا كانت منطقة المحتوى في السطر لا تملأ كامل صندوق السطر، يتم تقييد اكتشاف الـseparator على منطقة المحتوى المقتصة. وإذا كانت منطقة المحتوى المقتصة فارغة، يتم تخطيها.
يتم تحديد aya_separator باستخدام القالب aya_separator عبر cv2.templateMatch(). وطريقة الكشف هنا مشابه جدًا لتلك المستخدمة في الــ sura_header:
العثور على مواضع القالب، ثم ترشيحها باستخدام aya_threshold، ثم ترتيبها حسب درجة التطابق، ثم ترشيح المواضع المتداخلة.
ثم يقسم السطر إلى segments اعتمادًا على مواضع aya_separator التي تم العثور عليها، ويخزنها في ctx داخل segments تحت رقم السطر.


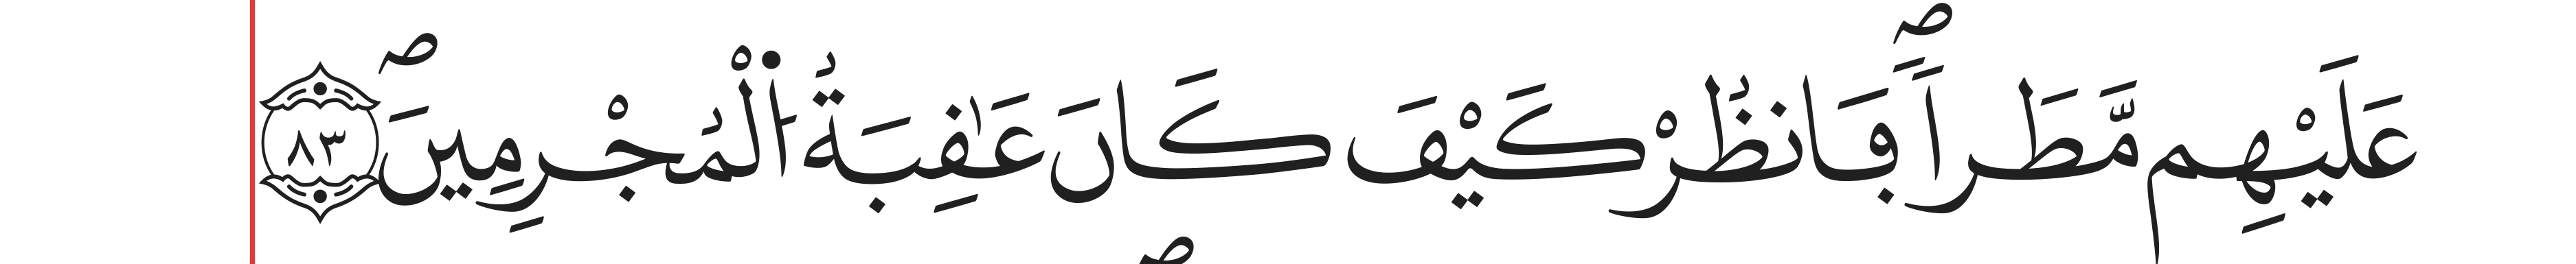




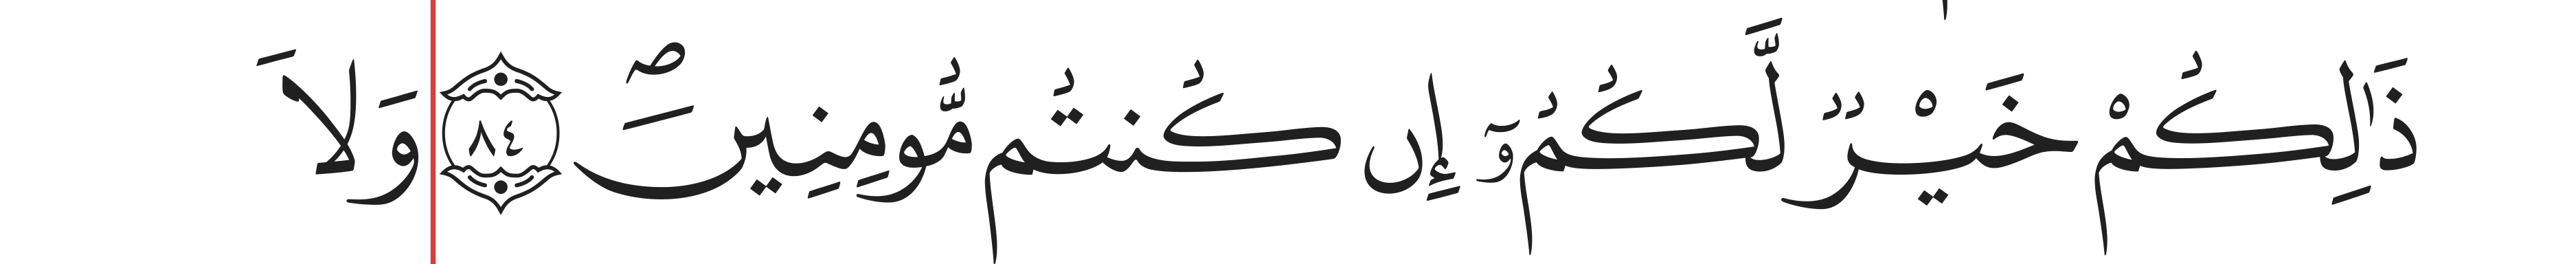





يتم تمييز كل segment بناءً على ما إذا كان يحتوي على separator أم لا، ليتم استخدام ذلك لاحقًا.
ثم يأتي دور الـtracker، وهو المسؤول عن ترقيم السور والآيات بعد اكتشاف الإحداثيات. ويتم تهيئته باستخدام الآية (السورة، الآية) التي يبدأ منها نطاق الصفحات.
يمر على الأسطر، فإذا كان السطر sura_header فإنه يزيد رقم السورة ويعيد رقم الآية إلى 1. وهناك بعض الحالات الخاصة التي يتم التعامل معها، مثل أن يبدأ نطاق المعالجة من sura_header، وأن تكون السورة المحددة عند البداية هي نفسها هذه السورة، وأن تكون الآية 1.
إذا كان السطر نصيًا، ولا يحتوي على separator، ويأتي مباشرة بعد sura_header، فإنه يُعتبر بسملة.
وإلا فهو سطر نص عادي، فيمر على الـsegments الموجودة فيه. وتتعامل هذه الحالة أيضًا بشكل صحيح مع سورة التوبة. حيث يتم إسناد رقم الآية الحالي إلى أول segment، وإذا كان الـsegment يحتوي على separator، يتم زيادة رقم الآية وإسناد الرقم الجديد إلى الـsegment التالي، وهكذا.
وأخيرًا يصدّر المحرّك نتائجه، سواء إلى الـbackend API أو إلى الــ terminal أو إلى ملف نوع البرنامج المستخدم لتشغيل المعالج.
بالطبع يوجد أجزاء لم يتم تغطيتها ولكن أعتقد أن هذه الأجزاء هي الأهم والتي تساعد في رسم الصورة الكاملة للاستخدام وطريقة المعالجة.
إن شاء الله سوف أقوم بشرح كيف يعمل معالج تمييز الكلمات في مقال آخر في وقت قريب ان شاء الله.
