إذا كنت تريد إضافة بحث قوي في النص القرآني داخل تطبيق ويب أو Node.js دون تعقيد، فهذا المشروع يقدّم لك أدات package جاهزة ومجرّبة: quran-search-engine. وهو محرّك بحث “مستقل” (stateless) ومكتوب بـ TypeScript يمكن استدعاؤه بسهولة داخل أي واجهة (React/Vue/Svelte/Next.js…)، مع دعم تطبيع العربية normalization، البحث النصي الدقيق، البحث بأصل الكلمات (Lemma) والجذر (Root)، والـ Highlighting أو التأشير على الكلمات.
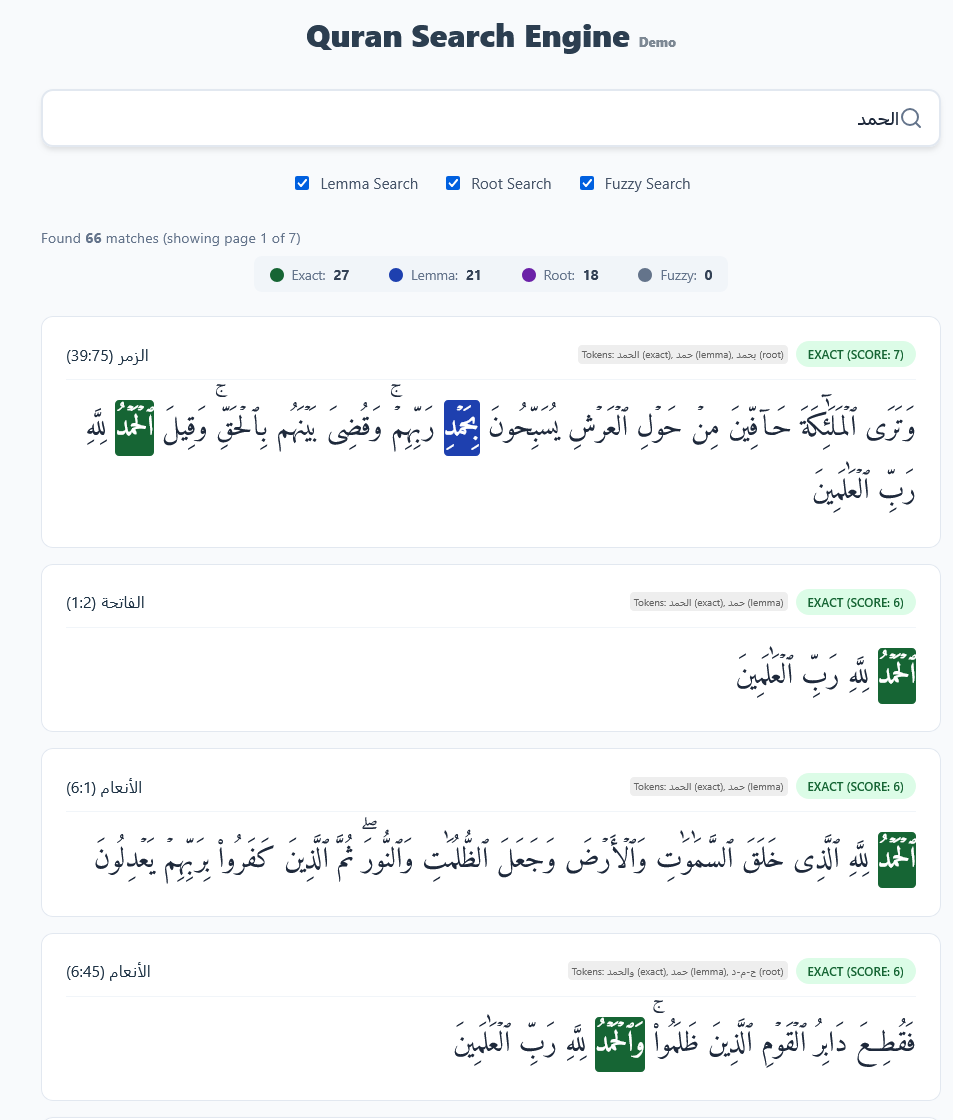
ماذا يقدّم المشروع عمليًا؟
- تطبيع عربي (Normalization): توحيد الألف والهمزة، إزلة التشكيل وعلامات المصحف، وتنظيف النص قبل البحث.
- بحث نصي دقيق (Exact): مطابقة كلمات الاستعلام داخل النص القياسي (standard) للآية.
- بحث لغوي (Lemma/Root): مطابقة على مستوى أصل الكلمة والجذر عبر بيانات الصرف (morphology) + قاموس ربط الكلمات (word map).
- بحث تقريبي (Fuzzy): بديل عند غياب المطابقات الدقيقة/اللغوية، مفيد لأخطاء الكتابة أو اختلافات بسيطة.
- Highlight ranges: يعيد نطاقات (start/end) غير متداخلة لتلوين النتائج في واجهتك دون
html tags.
- Scoring + Sorting: يحسب درجة المقاربة لكل نتيجة ويرتّب النتائج حسب الأهمية.
كيف تستخدم صفحة الـ Playground؟
افتح: https://quran-search-engine.netlify.app/
ستجد:
1) حقل البحث: اكتب كلمة أو أكثر بالعربية (مثال: الله الرحمن أو كتب أو رحم).
2) خيارات البحث:
- Lemma Search: تفعيل البحث بأصل الكلمة.
- Root Search: تفعيل البحث بالجذر.
- Fuzzy Search: تفعيل البحث التقريبي كحلّ احتياطي.
3) لوحة الإحصاءات: تعرض عدد النتائج الإجمالي وتقسيمها حسب نوع المطابقة (Exact/Lemma/Root/Fuzzy).
4) بطاقات النتائج:
- يظهر نوع المطابقة
matchType والدرجة matchScore.
- تلوين (Highlight) لأجزاء الآية المرتبطة بالكلمات المطابقة.
5) التصفح (Pagination): تنقّل بين الصفحات عند كثرة النتائج.
هذه الصفحة ليست “المحرّك” نفسه، بل مثال واجهة يستخدم نفس الـ API التي ستستخدمها داخل تطبيقك.
التثبيت (Installation)
npm install quran-search-engine
# أو
yarn add quran-search-engine
# أو
pnpm add quran-search-engine
مثال سريع (Quickstart) — TypeScript
الفكرة الأساسية: حمّل البيانات الافتراضية مرة واحدة عند بدء التطبيق، ثم نفّذ عمليات البحث على نفس البيانات.
import {
  search,
  loadMorphology,
  loadQuranData,
  loadWordMap,
  type SearchResponse,
} from 'quran-search-engine';

const [quranData, morphologyMap, wordMap] = await Promise.all([
  loadQuranData(),
  loadMorphology(),
  loadWordMap(),
]);

const response: SearchResponse = search('الله الرحمن', quranData, morphologyMap, wordMap, {
  lemma: true,
  root: true,
});

response.results.forEach((v) => {
  console.log(v.sura_id, v.aya_id, v.matchType, v.matchScore);
});
ناتج البحث يعيد قائمة نتائج، إضافة إلى عدّادات وإعدادات Pagination جاهزة للعرض.
نظرة على الـ Public API (واجهة الاستخدام العامة)
كل ما تحتاجه مستورد من الحزمة مباشرة (متوافق مع src/index.ts):
- تحميل البيانات:
loadQuranData()loadMorphology()loadWordMap()
- التطبيع:
normalizeArabic(text)removeTashkeel(text)
- البحث:
search(query, quranData, morphologyMap, wordMap, options?, pagination?)
- الـ Highlighting:
getHighlightRanges(text, matchedTokens, tokenTypes?)
- أنواع TypeScript الجاهزة (للاستخدام في تطبيقاتك):
SearchResponse, SearchOptions, QuranText, ScoredQuranText, MatchType, HighlightRange… إلخ.
تحميل البيانات الافتراضية (Default Data Loading)
المشروع يأتي مع بيانات JSON افتراضية (نص القرآن + الصرف + word map). دوال التحميل تستعمل dynamic import لتقليل حجم الحزمة الأولي (code splitting)، ثم ترجع البيانات جاهزة للاستعمال:
loadQuranData() يرجع QuranText[] (كل عنصر يمثل آية).loadMorphology() يرجع Map<number, MorphologyAya> مفهرسة بـ gid (مع lemmas و roots).loadWordMap() يرجع WordMap لربط توكن الاستعلام إلى لِمّة/جذر قياسيين.
ℹ️ نصيحة تطبيقية
خزّن بيانات القرآن والصرف وـ word map في ذاكرة التطبيق
(state / store / singleton)،
ولا تُعد تحميلها مع كل عملية بحث،
لأن search() دالة stateless وتفترض أن البيانات جاهزة في الذاكرة.
البحث بكلمات متعددة - جملة (Multi‑word Search)
الاستعلام مثل الله الرحمن يُقسّم إلى tokens بحسب المسافات، ثم يطبّق منطق AND:
- النتيجة يجب أن تطابق كل كلمة من كلمات الاستعلام.
- المطابقة لكل token قد تكون Exact أو Lemma/Root أو (عند الحاجة) Fuzzy.
هذا مفيد عندما تريد نتائج “أدق” بدل البحث الذي يعيد أي آية تحتوي إحدى الكلمات فقط.
خيارات البحث: Lemma / Root / Fuzzy
عبر SearchOptions يمكنك التحكم بسلوك المطابقة:
const response = search(query, quranData, morphologyMap, wordMap, {
  lemma: true,
  root: true,
  fuzzy: true,
});
شرح الخيارات؟
- Exact (ضمنيًا دائمًا): مطابقة مباشرة داخل النص القياسي للآية.
- Lemma Search:
- يوسّع النتائج عبر مطابقة “الأصل” للكلمة (صيغة معجمية).
- مفيد لتجميع تصريفات مختلفة لنفس المعنى الأساسي.
- Root Search:
- يبحث بالجذر (مثل ك ت ب، ر ح م…) عندما يكون هذا أنسب للبحث الدلالي.
- عادةً أوسع من الأصل، وقد يعيد نتائج أكثر.
- Fuzzy Search:
- يستخدم بحثًا تقريبيًا كحل احتياطي عندما لا توجد مطابقة لغوية/نصية للتوكن.
- يمكنك تعطيله عبر
fuzzy: false إذا كنت تريد نتائج “صارمة” فقط.
كيف يعمل الـ Scoring (الترتيب بالدرجة)
كل نتيجة ترجع كـ ScoredQuranText وتتضمن:
matchScore: الدرجة النهائية أو مجموع الدرجاتmatchType: أفضل نوع مطابقة على مستوى الآيةmatchedTokens: توكنات/مقاطع استُخدمت لإبراز النتيجةtokenTypes: نوع المطابقة لكل توكن (للتلوين)
منطق الدرجات (وزن لكل طبقة مطابقة):
- Exact:
+3 لكل كلمة مطابقة داخل الآية
- Lemma (عند التفعيل):
+2 لكل مطابقة
- Root (عند التفعيل):
+1 لكل مطابقة
- Fuzzy (عند غياب أي Exact/Lemma/Root):
+0.5 لكل مقطع مطابق
ثم تُرتّب النتائج تنازليًا حسب matchScore لتظهر الأكثر صلة أولًا.
الـ Highlighting: إبراز الكلمات دون ربط بالواجهة html أو view ....
ميزة جميلة في هذا المشروع أنه لا يفرض طريقة عرض. بدل أن يعيد HTML، يعيد نطاقات يمكن رسمها بأي UI.
import { getHighlightRanges } from 'quran-search-engine';

const ranges = getHighlightRanges(verse.uthmani, verse.matchedTokens, verse.tokenTypes);
// ranges => [{ start, end, token, matchType }, ...]
مثال React بسيط
import { getHighlightRanges, type ScoredQuranText } from 'quran-search-engine';
import type { ReactNode } from 'react';

export function Verse({ verse }: { verse: ScoredQuranText }) {
  const ranges = getHighlightRanges(verse.uthmani, verse.matchedTokens, verse.tokenTypes);
  if (ranges.length === 0) return <span>{verse.uthmani}</span>;

  const parts: ReactNode[] = [];
  let cursor = 0;

  ranges.forEach((r, i) => {
    if (cursor < r.start) parts.push(verse.uthmani.slice(cursor, r.start));
    parts.push(
      <span key={`${r.start}-${r.end}-${i}`} className={`highlight highlight-${r.matchType}`}>
        {verse.uthmani.slice(r.start, r.end)}
      </span>,
    );
    cursor = r.end;
  });

  if (cursor < verse.uthmani.length) parts.push(verse.uthmani.slice(cursor));

  return <span>{parts}</span>;
}
ما يميّز هذا الأسلوب:
- آمن (لا يوجد HTML محقون).
- يسهّل تلوين مختلف حسب
matchType (exact/lemma/root/fuzzy).
- مناسب للـ RTL وخطوط المصحف (Uthmani) لأن التحديد يعتمد على مؤشرات ضمن النص الأصلي.
لماذا استعمال quran-search-engine “سهل التنفيذ” داخل أي تطبيق؟
- واجهة واحدة واضحة: دالة
search(...) هي نقطة الدخول الأساسية.
- دوال تحميل جاهزة: لا تحتاج لتجهيز ملفات البيانات يدويًا لتبدأ.
- دون حالة داخلية: يمكنك اختبار الوظائف بسهولة وإعادة استخدامها في أي مكان.
- مخرجات UI-friendly: النتيجة تحتوي ما تحتاجه للعرض (إحصاءات، صفحات، درجات، توكنات للـ highlighting).
سيناريو شائع في تطبيقات الويب:
1) عند تشغيل التطبيق: Promise.all([loadQuranData(), loadMorphology(), loadWordMap()])
2) عند تغير الاستعلام: استدعِ search(...) مع خياراتك
3) اعرض:
response.resultsresponse.countsresponse.pagination
4) مرّر matchedTokens وtokenTypes إلى getHighlightRanges(...) لتلوين النص
مثال سريع:
import {
  search,
  loadMorphology,
  loadQuranData,
  loadWordMap,
  type SearchResponse,
} from 'quran-search-engine';

const [quranData, morphologyMap, wordMap] = await Promise.all([
  loadQuranData(),
  loadMorphology(),
  loadWordMap(),
]);

const response: SearchResponse = search(
  'الله الرحمن',
  quranData,
  morphologyMap,
  wordMap,
  {
    lemma: true,
    root: true,
  },
);

response.results.forEach((verse) => {
  console.log(
    verse.sura_id,
    verse.aya_id,
    verse.matchType,
    verse.matchScore,
  );
});
`## استخدام بيانات مخصصة
يمكنك استخدام أي Dataset للقرآن طالما يحقق الشكل التالي:
type VerseInput = { gid: number; uthmani: string; standard: string; };
مثال عملي
import { search, type VerseInput, type WordMap, type MorphologyAya } from 'quran-search-engine';

type MyVerse = VerseInput & {
  sura?: number;
  aya?: number;
  translation_en?: string;
};

const myCustomVerses: MyVerse[] = [
  {
    gid: 1,
    standard: 'بسم الله الرحمن الرحيم',
    uthmani: 'بِسْمِ ٱللَّهِ ٱلرَّحْمَٰنِ ٱلرَّحِيمِ',
    sura: 1,
    aya: 1,
    translation_en: 'In the name of Allah, the Entirely Merciful, the Especially Merciful.',
  },
];

const morphologyMap = new Map<number, MorphologyAya>();
const wordMap: WordMap = {};

const response = search(
  'الله الرحمن',
  myCustomVerses,
  morphologyMap,
  wordMap,
  { lemma: false, root: false },
);

console.log(response.results[0]);
// Output:
// {
//   gid: 1,
//   sura: 1,
//   aya: 1,
//   matchType: 'exact',
//   matchScore: 6,
//   matchedTokens: ['الله', 'الرحمن'],
//   ...
// }
روابط مهمّة


