منذ فترة أحاول جعل برنامج منجم يعمل على الأجهزة محليًا دون الحاجة لسيرفرات مكلفة أو الاعتماد على خدمات مؤقتة مثل جوجل كولاب، ودون التضحية كذلك بالدقة التي توفرها النماذج القوية التي تعمل على GPUs.
وقد تمكنت من تحقيق ذلك بفضل الله وبمساعدة الإخوة الأفاضل الذين أخص بالذكر منهم الأخ @أحمد إبراهيم الذي وجهني لاستخدام نموذج recitation-segmenter-v2 لتقسيم التلاوة حسب الأنفاس بدلًا من الاعتماد على توقيتات نماذج التزمين أو نموذج Silero VAD، وكذلك الأخ @أحمد شمس الذي ساعدني على تطوير الواجهة لتكون أسهل ما يمكن في الاستخدام بفضل خبرته الكبيرة في مجال الصوتيات.
ما هو منجم؟
منجم هو برنامج لتزمين التلاوات القرآنية بدأه الأخ @abdullah mohammed مع إخوة آخرين، وقد شاركت فيه سابقًا عبر تعديله ليدعم التزمين على مستوى الكلمات بالاعتماد على مكتبة WhisperX.
ثم بعد تجارب عديدة ونصائح وتوجيه من الأخ @محمد طارق بأنه من الأفضل أن نجعله يعمل محليًا، عملنا على بناء تطبيق ويندوز باستخدام فلاتر له، وتعديل نماذج التزمين لتكون:
تجهيز وتجميع النماذج بصيغة ONNX
لكي يعمل البرنامج على الأجهزة الشخصية دون الحاجة لتنصيب بيئات الذكاء الاصطناعي الثقيلة أو مكتبات PyTorch المعقدة، قمتُ بتصدير وضبط هذه النماذج لتشغيلها عبر محرك ONNX Runtime مع دعم التسريع العتادي المباشر DirectML / CUDA لكروت الشاشة:
- قمتُ بتحويل نموذج تقطيع الأنفاس recitation-segmenter-v2 إلى ONNX مع معالجة تجزئة الطبقات لتجاوز حاجز الـ 2 غيغابايت.
- وكذلك تصدير نموذج Wav2Vec2 XLSR-53 إلى ONNX بأبعاد ديناميكية (Dynamic Axes).
وقد رفعتُ الحزمة كاملة وجاهزة للاستخدام المباشر في مستودع مفتوح على Hugging Face لخدمة أي مطور يرغب في توظيفها في مشاريعه:
https://huggingface.co/Alimalas/munajjam-onnx-models
كيفية تحميل واستخدام منجم ديسكتوب
البرنامج متوفر لويندوز حاليًا على شكل ملف تنفيذي exe، ويمكن تحميله من الرابط التالي:
https://drive.google.com/file/d/1TulbP3Nk-_xEoMbBet5VlVqNJWNkhgim/view?usp=sharing
وبعد التحميل ليس عليك إلا تثبيت البرنامج كأي برنامج آخر، حيث كل المتطلبات محزومة في الملف جاهزة بما في ذلك النماذج المستخدمة، لكن لكي يعمل البرنامج بكفاءة يجب أن يتوافر كرت شاشة RTX 3050 بذاكرة 6 غيغابايت VRAM كحد أدنى.
بعد فتح البرنامج انتظر دقيقة أو نحو ذلك، لكي يُشغل الخادم المحلي تلقائيًا وتُهيأ النماذج في الذاكرة، إذ بعد التشغيل ستلاحظ اختفاء عبارة جاري التشغيل الموجودة في شريط العنوان، ليظهر مكانها عبارة خضراء مثل RTX DirectML.
يمكنك تزمين سورة عبر النقر على زر تزمين ذكي بالذكاء الاصطناعي، ثم اختيار ملف تلاوة صوتي لسورة معينة، حيث سيتعرف البرنامج تلقائيًا على السورة، ويمكنك تغييرها إذا لم يوفق البرنامج في التعرف بسبب عدم وجود أي رقم أو نص في اسم الملف يشير إلى السورة الصحيحة، ثم بعد ذلك تبدأ عملية التزمين.
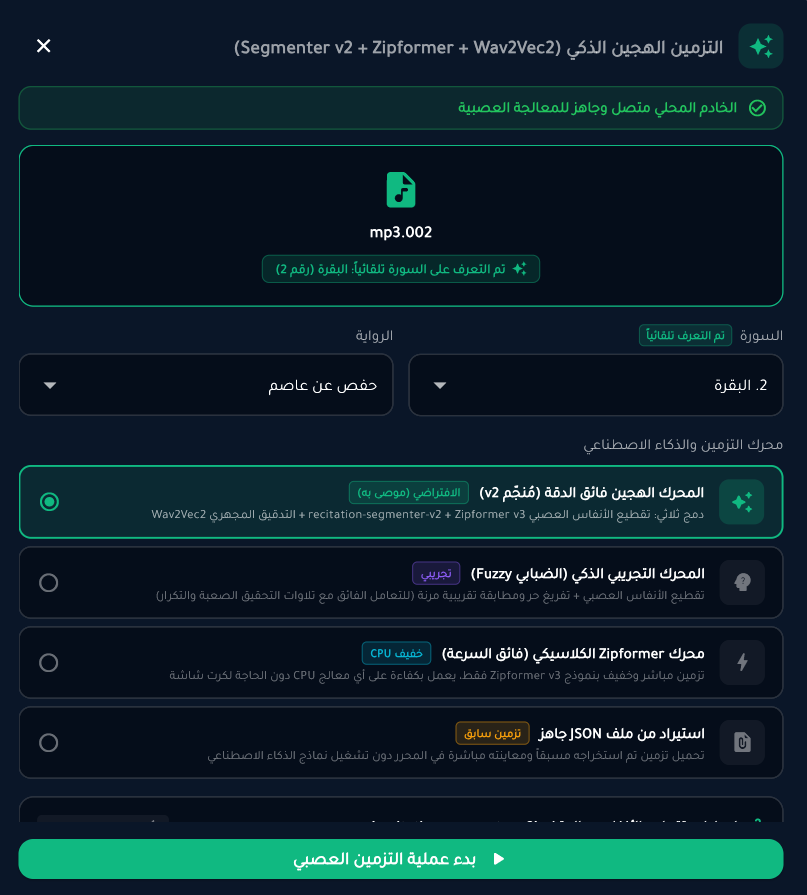
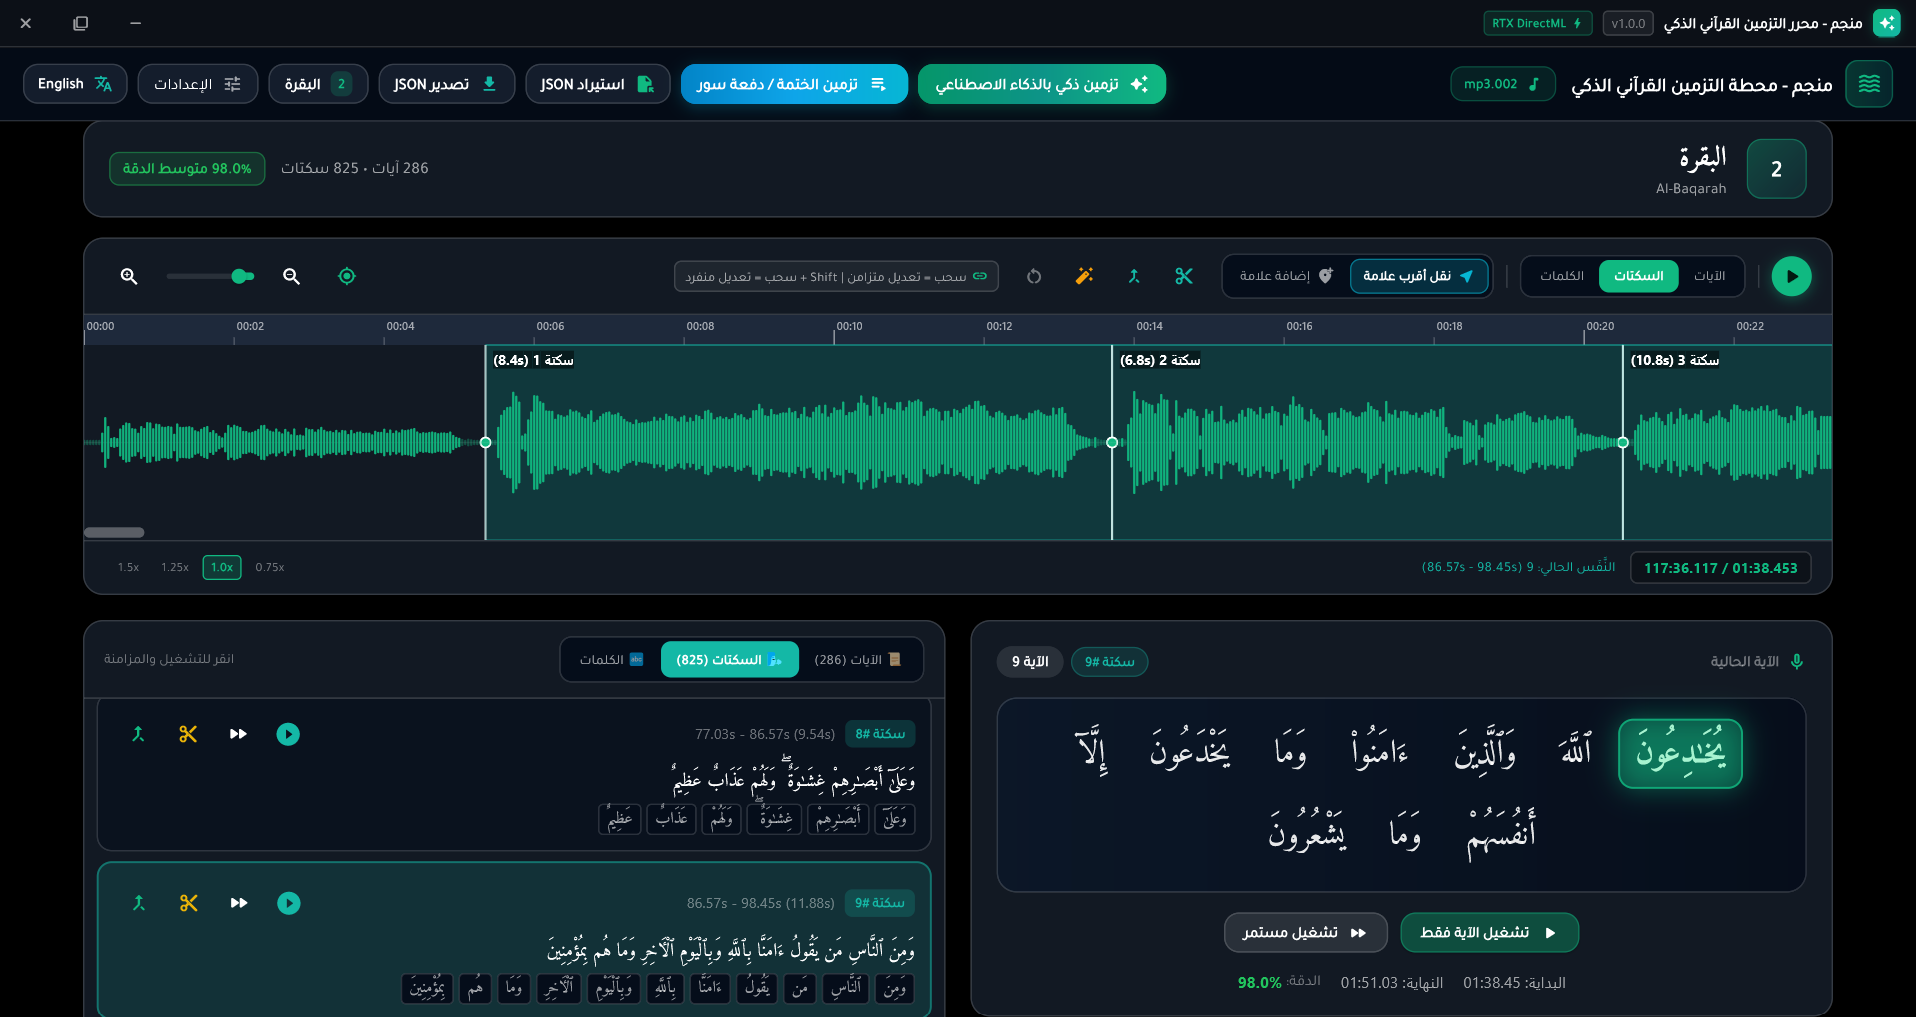
بعد الانتهاء ستظهر النتائج في المحرر ويمكن التأكد منها وتعديلها عبر الأدوات المتوفرة في الواجهة، ويمكن كذلك تصدير التزمين على شكل ملف Json عبر النقر على زر تصدير Json.
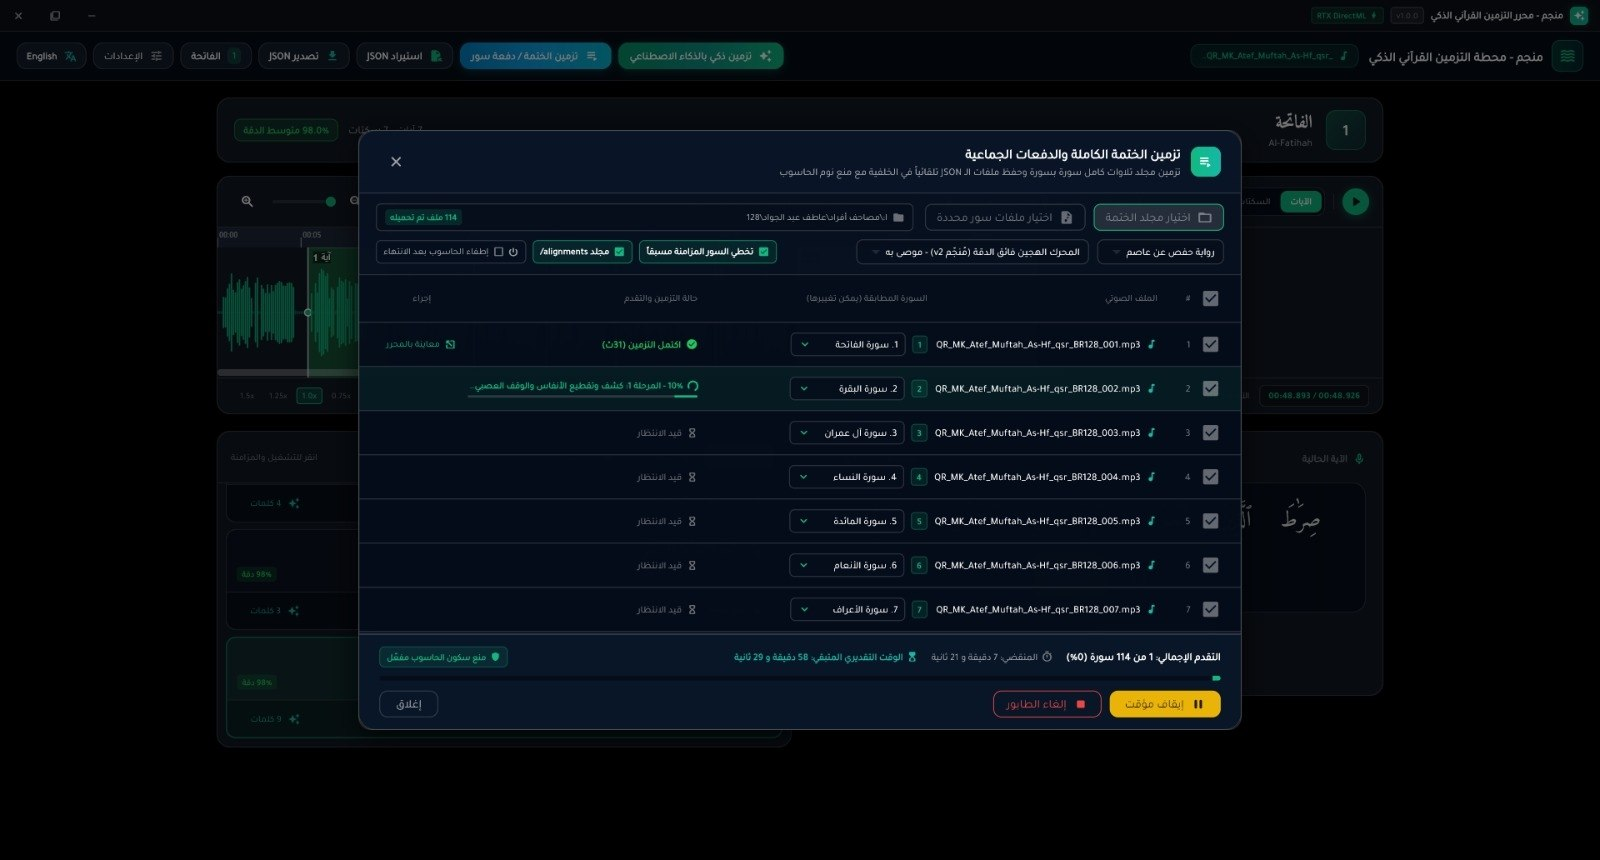
ويمكن كذلك تزمين ختمة كاملة أو دفعة سور عبر زر تزمين الختمة / دفعة سور، حيث يمكن اختيار المجلد المستهدف، ويتم حفظ نتائج التزمين تلقائيًا في ملفات Json.
كيف تعمل عملية المزامنة؟
للوصول إلى أعلى دقة ممكنة في تزمين التلاوة وتفادي المشاكل الشهيرة في المحاذاة الصوتية، مثل بتر نهايات حروف المد، أو تداخل الكلمات، عملت على طريقة تزمين تعمل على عدة مراحل، وتجمع بين قوة النماذج الثلاثة:
تقطيع الأنفاس والوقف
بدلًا من استخدام كواشف الصمت التقليدية (VAD المبنية على مستوى طاقة الصوت) والتي تخطئ كثيرًا في التلاوات الهادئة أو تفصل في منتصف المدود، يبدأ التزمين بنموذج مخصص للتلاوة القرآنية مبني على معمارية Wav2Vec2-BERT، وهو من عمل الأخ @عبد الله والذي طور أيضًا المعلم القرآني.
يقوم هذا النموذج بتحديد الأنفاس الحقيقية للقارئ بدقة متناهية، فيفصل مواضع الوقف والسكتات النفسية الطبيعية دون قص أي حرف أو مد.
التفريغ وكشف الكلمات المرجعية
يعمل نموذج zipformer_p-arabic-v3 والذي طوره @Quran Lab على تفريغ التلاوة واستخراج التوكنات الزمنية، وتكمن أهميته في كشف الاستعاذة والبسملة ودعاء الختم وكلمة (آمين) تلقائيًا واستبعادها من تزمين آيات السورة منعًا لإزاحة التوقيت، بالإضافة إلى بناء التسلسل المرجعي العام للكلمات وربط النص المقروء بآيات السورة الصحيحة.
توزيع الكلمات وفرض الترتيب الزمني
يقوم المحرك بتعيين كل كلمة لمقطع النَّفَس التابعة له، مع تطبيق خوارزمية تضمن الرتابة الصارمة لمنع ارتداد الكلمات زمنيًا إلى الخلف، والتأكد التلقائي من الكلمات الواقعة عند حواف السكتات قبل بداية النَّفَس التالي.
المحاذاة القسرية المجهرية لكل نَفَس
بدلًا من محاذاة الملف الصوتي الطويل ككتلة واحدة (وهو ما يسبب تراكم الخطأ)، يتم استقطاع كل مقطع نَفَس مستقل وتمريره إلى نموذج Wav2Vec2 XLSR-53 Arabic لتطبيق المحاذاة القسرية بدقة الإطار الواحد (Frame-level) عبر خوارزمية Viterbi Trellis المسرّعة بمكتبة Numba.
إغلاق الفجوات ومعالجة أحكام الوصل وذيول المدود
في المرحلة الأخيرة، تُطبق خوارزمية متقدمة لمعالجة طبيعة النطق القرآني:
- إغلاق الفراغات الوهمية بين الكلمات التي تُقرأ وصلًا دون سكت.
- فحص طاقة الترددات الصوتية لتحديد اللحظة الحقيقية لانتهاء الصوت، مما يمنع نهائيًا بتر مد العارض للسكون أو مد اللين عند الوقف.
- إذا أعاد القارئ كلمة أو شطر آية للابتداء بها مجددًا، يتم رصد ذلك تلقائيًا.
دعوة للمساهمة والتطوير
مشروع منجم ديسكتوب مفتوح المصدر بالكامل، ومتاح للمجتمع للاستفادة منه وتطويره عبر الرابط:
https://github.com/alinice1998/munajjam-desktop
إذا كانت لديكم رغبة في المساهمة، فهناك جوانب متعددة يمكن العمل عليها:
- تحسين واجهات المستخدم وتجربة التحرير في فلاتر.
- تجربة واختبار المزامنة ومشاركتنا الملاحظات حول الدقة.
- دعم تصدير صيغ إضافية للتوقيتات (مثل VTT أو SRT أو قواعد بيانات SQLite جاهزة لتطبيقات الموبايل).
ماذا عن الدقة؟
دقة التزمين عالية، وهي أعلى دقة توصلنا إليها بعد تجارب كثيرة، وتقارب الـ 100% على مستوى السكتات والآيات والكلمات، لكن هناك بعض الأخطاء القليلة في التعرف على التكرارات، ويمكنك إذا أردت المساهمة أن تساعدنا في فهم سبب ذلك وتحسين دقة التعرف على التكرار.
ما رأيكم في فكرة الجمع بين تقطيع الأنفاس والمحاذاة القسرية لكل مقطع نفس؟ وهل تقترحون نموذج تزمين قوي يمكن تطبيقه على مقاطع النفس أكثر خفة وبنفس جودة النموذج المستخدم؟


