السلام عليكم، في رحلتي للبحث عن إمكانية إيجاد معيار موحد للبيانات القرآنية ذكرت أني قد وجدت معيارا موحدا وناجحا جدا لبيانات الانجيل من عام ٢٠٠٢. وسأتحدث عنه بإذن الله بتفصيل في هذا المنشور.
وإذا كنت مهتما بمتابعة هذه الرحلة يمكنك قراءة هذه المنشورات السابقة
1. تساؤلات لمطوري التطبيقات القرآنية حول المصطلحات القرآنية وترجمتها
2. تحليل اختلاف تسميات المصطلحات القرآنية في المشاريع مفتوحة المصدر
3. دعوة للجميع: حصر المصطلحات القرآنية
كما أكرر الشكر لكل شخص ساهم برأيه وجهده، أنا مؤمن بأن هذه المنشورات والأفكار هي نتاج عمل جماعي بيننا وبإذن الله نصل إلى نتيجة تفيد الجميع وبالذات مطوري التطبيقات القرآنية.
تحديث بعد المنشور السابق عن حصر المصطلحات القرآنية
قد نشرت سابقا رابط لجدول حصر المصطلحات القرآنية وذلك كان بعدما اقترح عدد من أعضاء المجتمع أن نبدأ بها. والجدير بالذكر أن هذا الجدول مستلهم من مقالة والجدول المنشور لهادي الأحمد فشكرا له.
للأسف بعد نشر المقالة أخطأت في الصلاحيات، مما عطل عملية الحصر واضطررت إلى قبول صلاحية التعديل يدويا. ولكن الآن أصبح بإمكان الجميع التعديل على الجدول.
كما أنني شاركت فكرة الحصر مع عدد من المعارف ممن عندهم معرفة بعلوم القرآن، وما زلت أبحث عن مصادر أو أبحاث قد حصرت هذه المصطلحات، فإذا كان عندكم أي معلومة حول هذا الموضوع شاركوها معي لو سمحتم.
أما الآن، لنبدأ في موضوع هذا المنشور.
محاور البحث
سيتكون البحث من محورين أساسيين
- مكتبة الانجيل الرقمية (DBL) : أكبر مصدر رقمي للانجيل تتضمن ٨٤٢ ناشر محتوى
- عائلة معايير USFM/USX : وسنركز على USX وهو معيار XML خاص لرقمنة محتوى الانجيل
مكتبة الانجيل الرقمية ( DBL )
أنشئت في عام ٢٠١١ من قبل اتحاد جمعيات مسيحية وهدفها هو رقمنة، توحيد وسهولة الوصول لترجمات الانجيل بجميع اللغات. عندما بدأت المكتبة بالعمل كانت تتضمن ١٠٠ نص ، وبحلول عام ٢٠٢١ أصبحت تتضمن قرابة ٢٩٠٠ نص يشمل ١،٧٧٣ لغة ( لم أكن أعرف أن العالم فيه هذا العدد من اللغات 😅 ).
وهنا مختصر إحصائيات المكتبة منشورة في عام ٢٠٢١
- ٢٨٨٣ نص من نصوص الانجيل
- ١٧٧٣ لغة مدعومة
- ١٤٠٠ نسخة صوتية من الانجيل بـ ٨٩٠ لغة
- ٨٤٢ ناشر محتوى ما بين جهات ومشاركين
كما أنه في إعلان في عام ٢٠٢١ تمكنوا من إضافة محتوى بصيغ جديدة كفيديوهات للانجيل كاملا بلغة الإشارة، وإنجيل كامل بلغة برايل للمكفوفين.
خصائص المكتبة
بشكل عام تجربة المستخدم سلسة جدا، تمكنت من فهم المنصة في وقت وجيز جدا. واجهة بسيطة وإمكانية تصفح البيانات سهلة جدا
خاصية ١ : تصفح المحتوى
https://www.loom.com/share/58fc0ecd23d14f40b58148a1fdbdafb6
هنا خاصية التصفح. كما ذكرت يوجد مئات الناشرين ويمكن لكل ناشر نشر المحتوى بأكثر من لغة وأكثر من ترخيص وهم نوعان. رخصة مغلقة ورخصة عامة. وسأشرحها بإذن الله
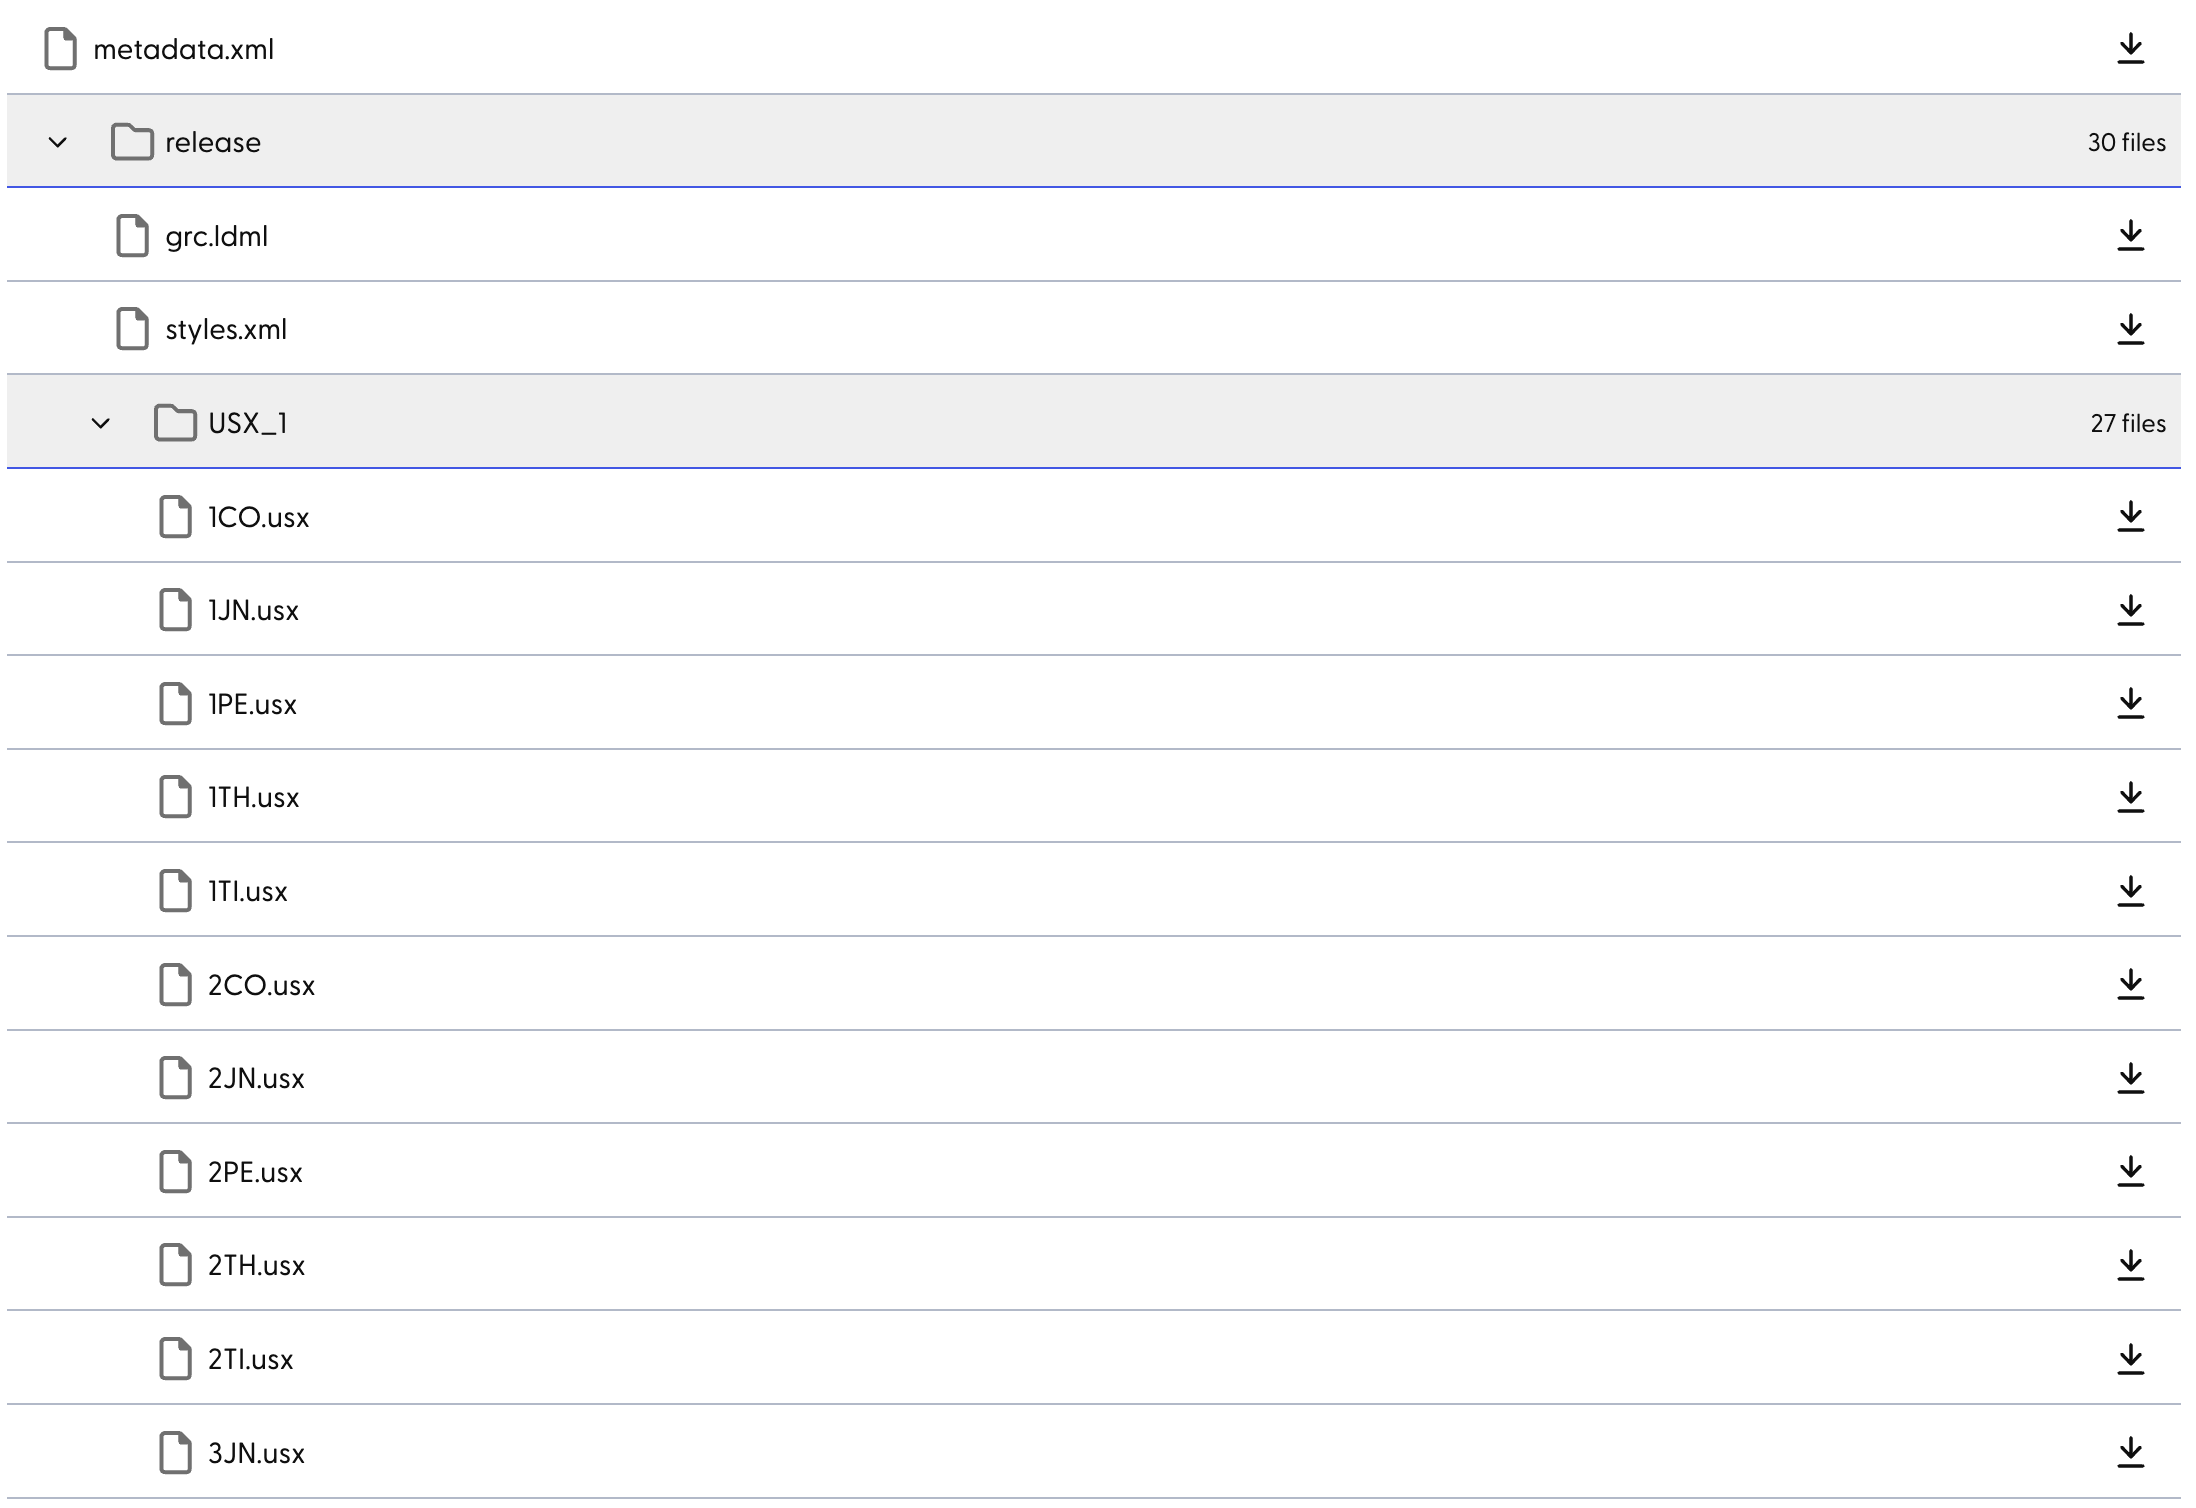
الشاهد، أنه كما موضح في المقطع في البداية فتحت مصدر برخصة مغلقة، ولكن عندما فتحت مصدر برخصة **Public Domain [DBL]** كانت الملفات موضحة حسب معيار USX بصيغة XML. وهذا المعتمد في المصادر النصية.
خاصية ٢ : تصفح الناشرين
https://www.loom.com/share/a9a6f9bdce58440f9c8f2c5d23b43be6
بالإمكان تصفح الناشرين ومواطن وجودهم، الغريب أني لم أتمكن من تصفح محتوى كل ناشر من هذه الصفحة.
خاصية ٣ : تصفح الرخص
المحتوى في DBL ينشر تحت نوعين من الرخص : رخص مغلقة تتطلب اتفاقية ترخيص مع الناشر للوصول إلى الملفات، ورخص عامة ( Public Domain أو Creative Commons ) تكون ملفاتها متاحة للجميع مباشرة.
خلاصة المكتبة
هدفي من كتابة هذا المحور هو أن هذه المكتبة تتشارك فيها مئات الجهات في نشر المحتوى والرخص منذ ١٥ سنة. وأعتقد أنه أحد أهم أسباب تمكن المكتبة من نشر آلاف النصوص ومئات اللغات هو وجود معيار موحد للبيانات. بدون هذا المعيار فلا أعتقد أن المكتبة تملك أدنى فرصة في النجاح
معيار USX
معيار USX ( Unified Scripture XML ), وهو معيار مبني بصيغة XML يحمل جميع بيانات الانجيل سواء كان الأساسية كالنصوص أو الوصفية. وهو المعيار المعتمد في مكتبة الانجيل الرقمية وأحد أكبر أسباب نجاحها، كما أنه البيانات المكتوبة بهذا المعيار سهلة القراءة إلى حد ما.
أثناء بحثي في معيار USX. اكتشفت أن هناك معيارا قبله يسمى بـ USFM ) Unified Standard Format Markers ) وهو مبني على backslashes. أسلوب الترميز هذا بدأ في الثمانينات ولكن كان صعب القراءة حيث أنه كل سطر يبدأ ب backlash
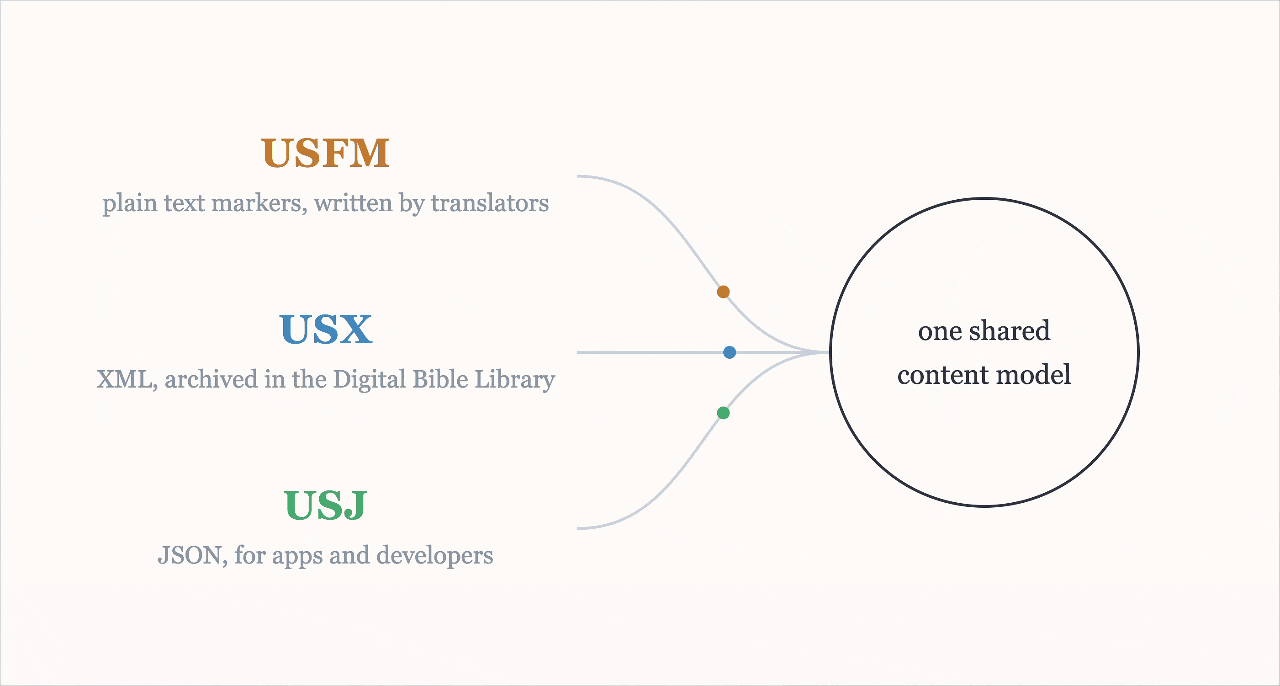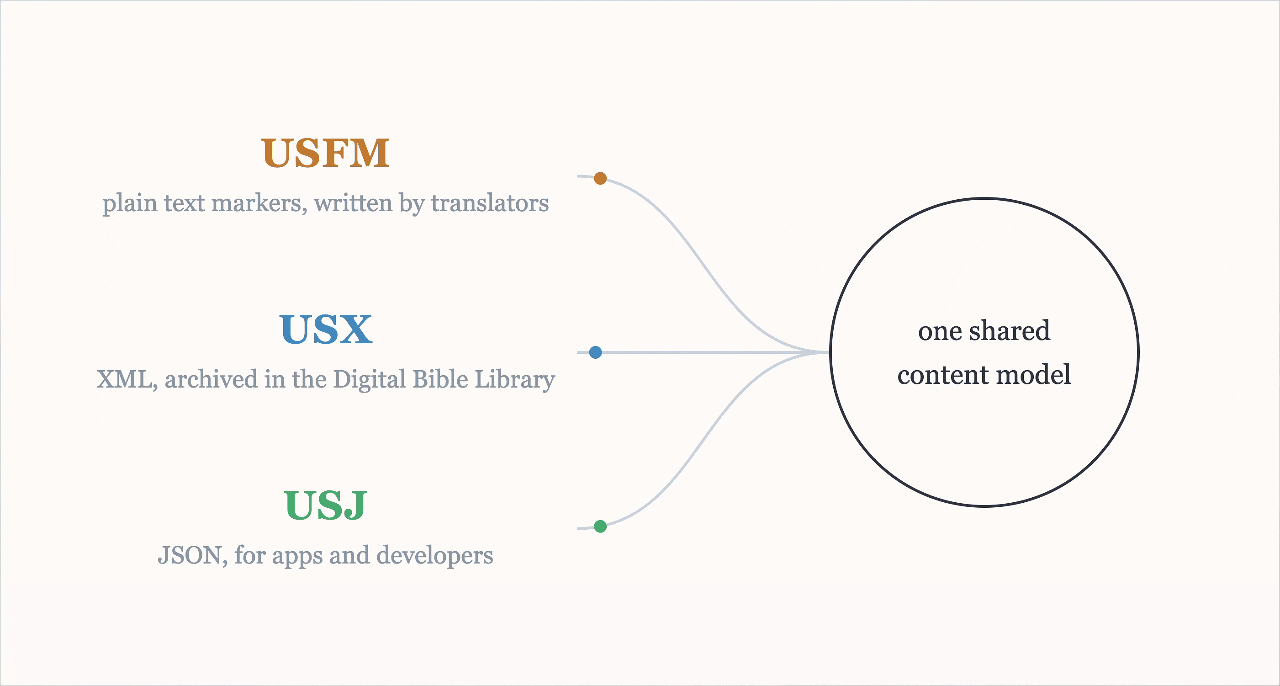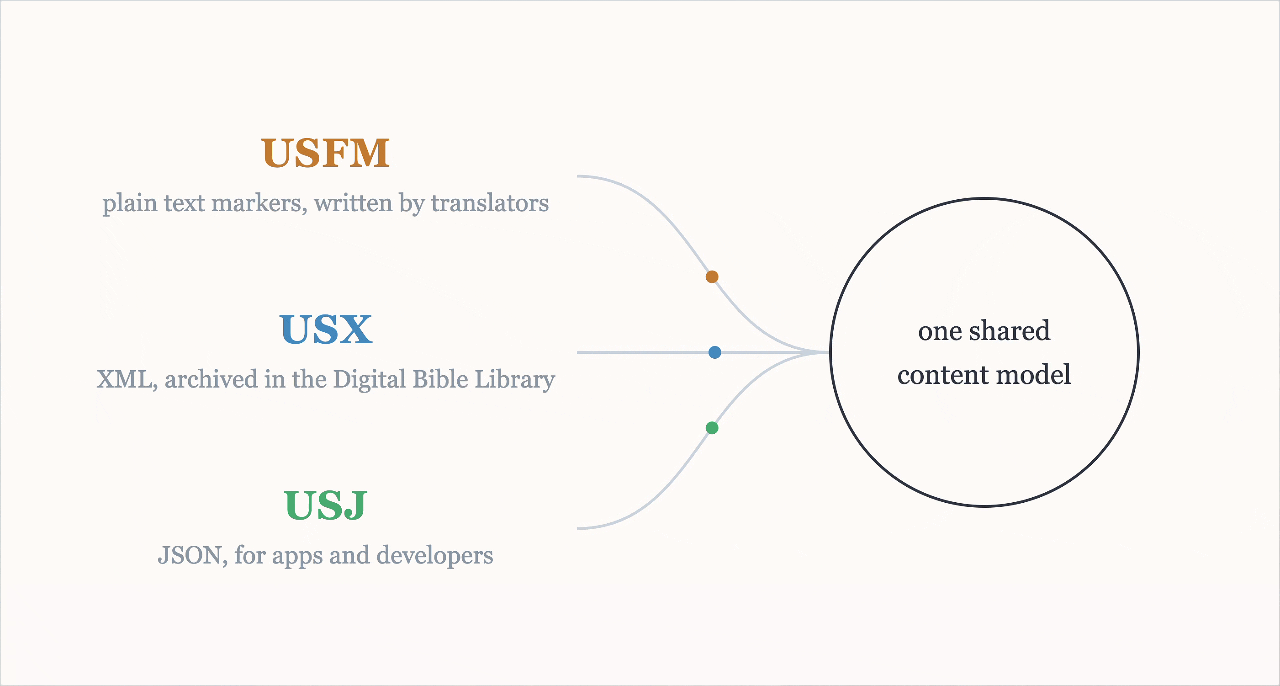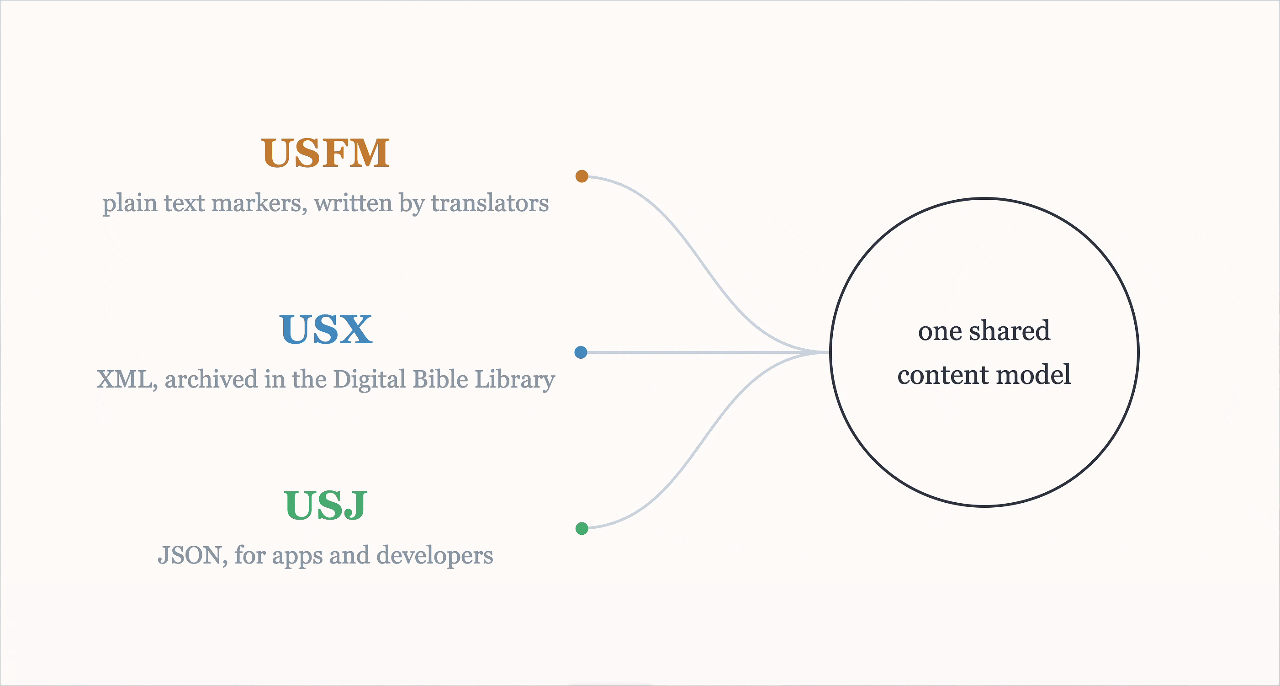
وهي ربما أكثر صيغة مؤلمة قرأتها في حياتي. وكانت هي الصيغة التي تستمد منها USX بنيتها وتحديثاتها. ولكن في عام ٢٠٢٤ ومع إصدار USFM 3.1 قررت اللجنة أن يكون content model هو ال parent الذي تستمد منه جميع صيغ Markup Expressions ومنها USFM نفسها و USX وكذلك مؤخرا USJ والتي بصيغة json.
!
ما هو ال content model ؟
أي ملف صحيح تحت ال USFM, USX, USJ (سأسميها عائلة USF ) يكون واحدا من نوعين
- نوع Scripture Book : وهو نص الإنجيل نفسه ( تركيزنا )
- نوع Peripheral : نص مساعد ملحق بالكتاب ( المقدمة، الفهرس، المعجم، الخرائط، وما إلى ذلك )
النوع الأول : Scripture Book
تفصيل Scripture Book
يتكون أي ملف scripture book من ٧ أجزاء. ٦ منها تعتبر metadata أو wrappers للمحتوى الفعلي. وهي كالتالي
| القسم | الوصف |
|---|
| Identification | رمز ثابت المكون من ٣ أحرف |
| Headers | قسم اختياري لاسم الكتاب واختصاره بلغة الترجمة، وأسماء جدول المحتويات ( |
| Titles | العناوين الرئيسية للكتاب التي تطبع في |
| Introduction | قسم اختياري من فقرات أو جداول لمقدمة الكتاب |
| Introduction end titles | عناوين اختيارية تكتب في نهاية المقدمة |
| Chapter label | نص اختياري لعنوان موحد يطبق على جميع فصول الكتاب |
| Chapter content | المحتوى الفعلي للكتاب |
أما الجزء السابع من الملف والأخير فهو الذي يتضمن المحتوى الفعلي
ولفهم ذلك، هنا صورة من إحدى صفحات الإنجيل
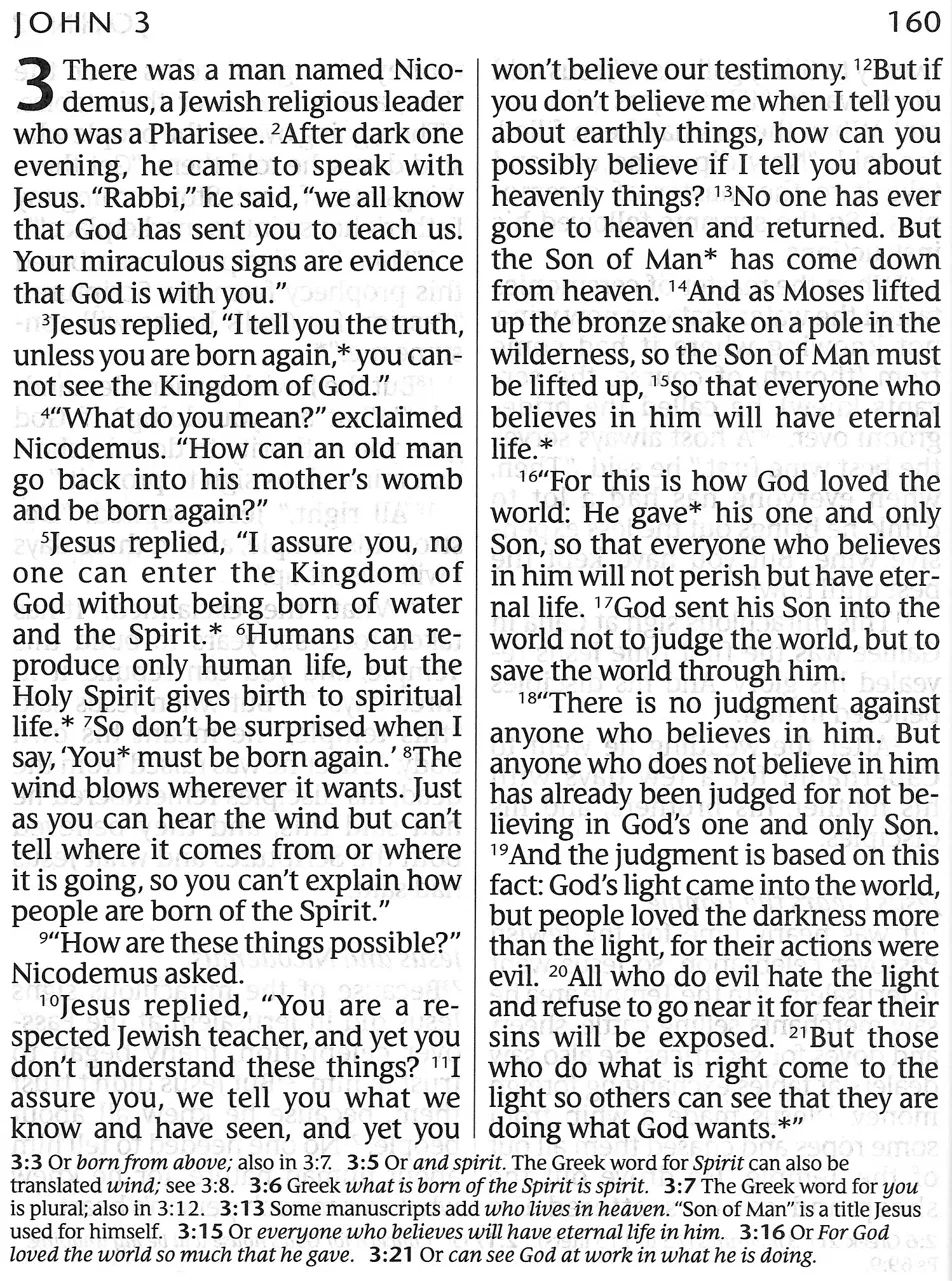
والآن، كيف حوّل ال content model هذه الصفحة إلى صيغة USFM
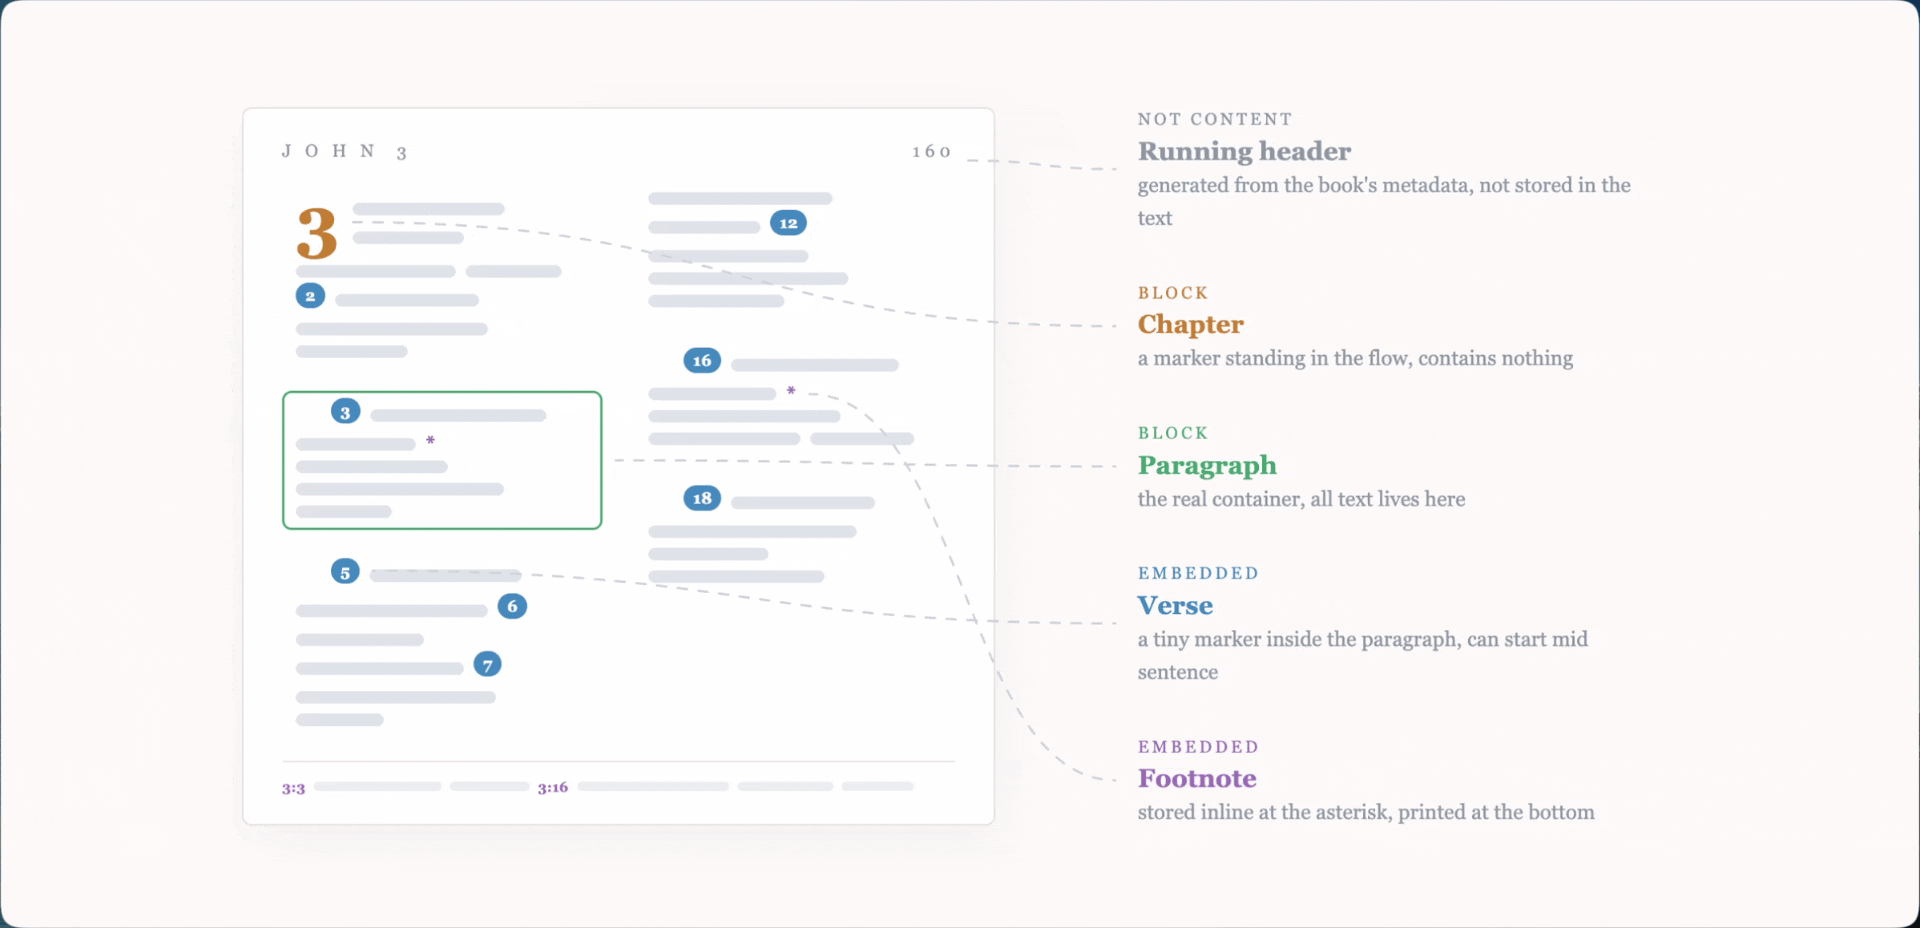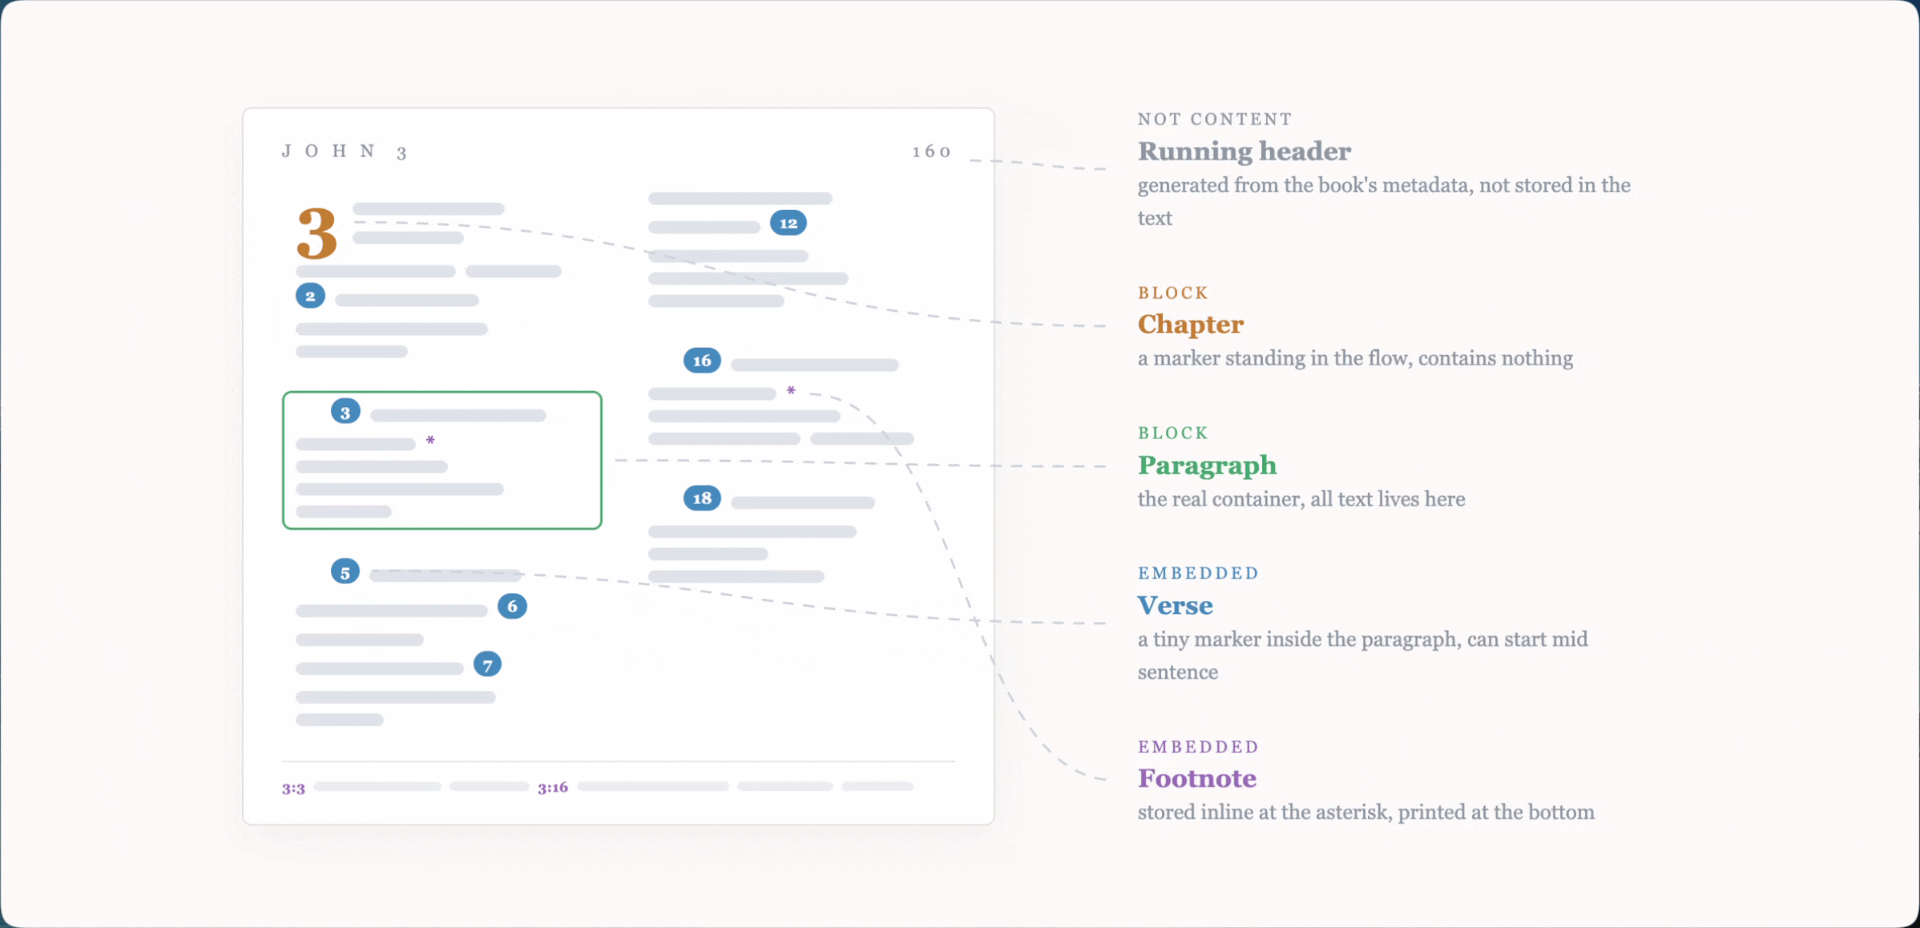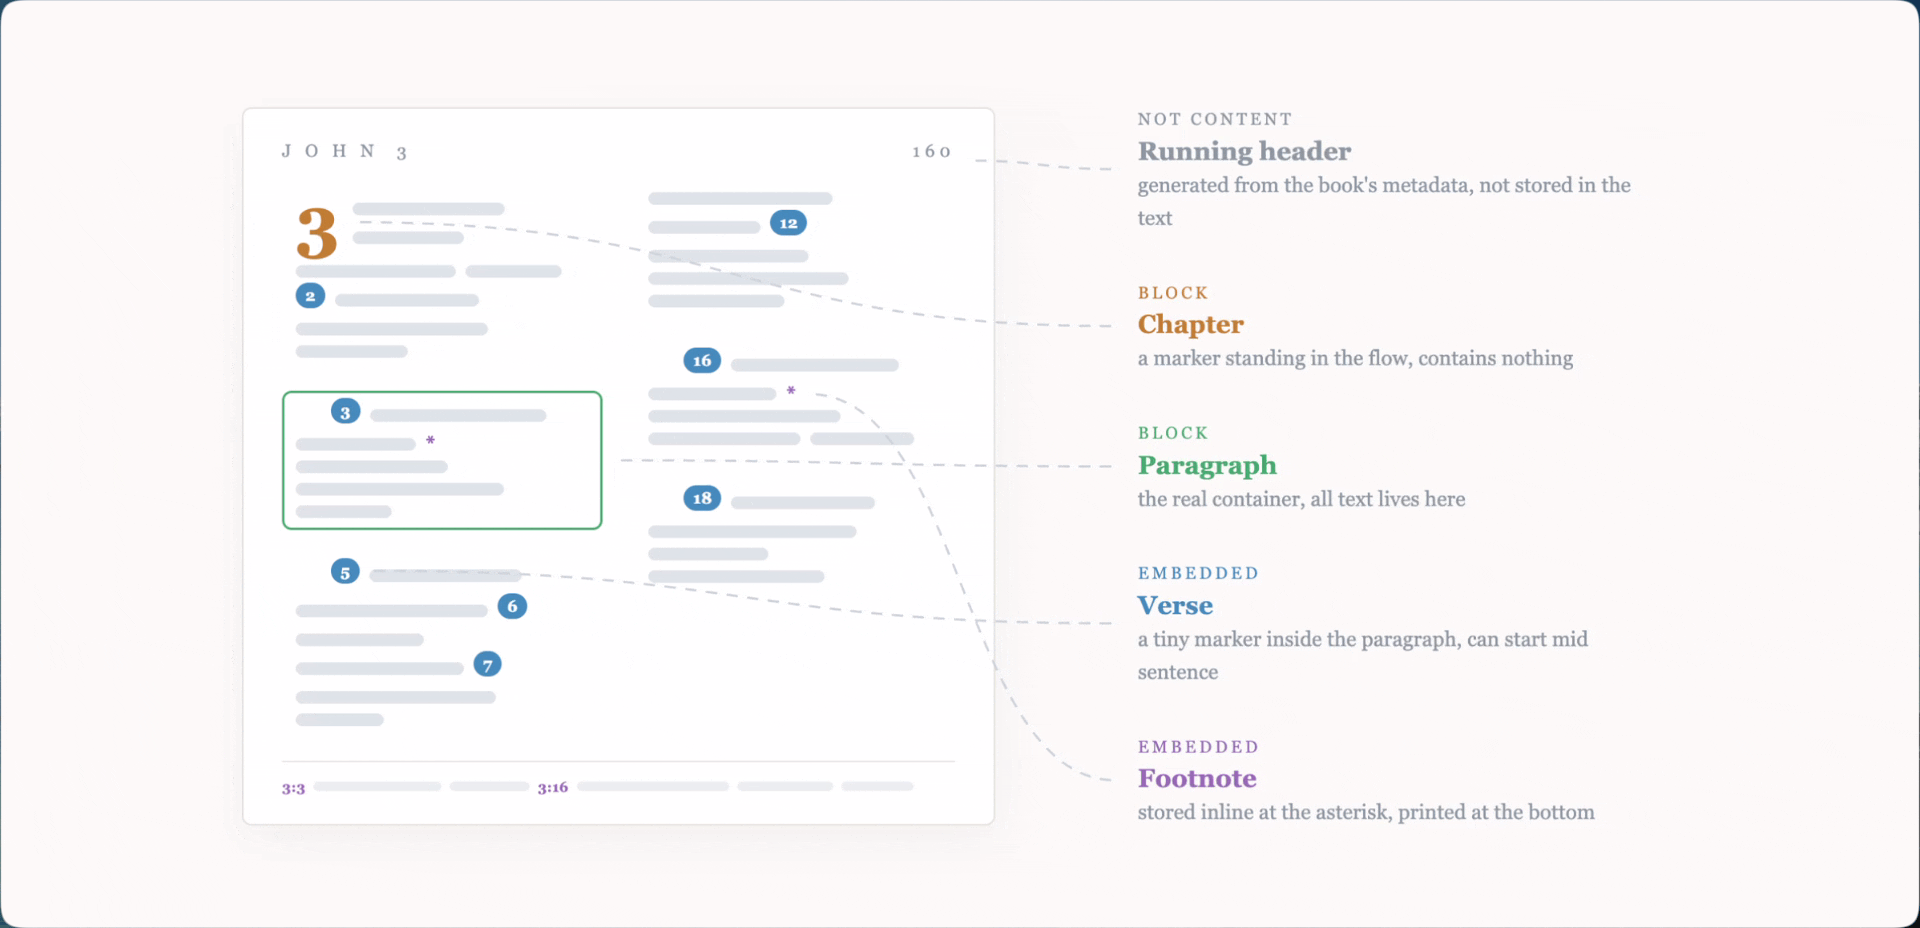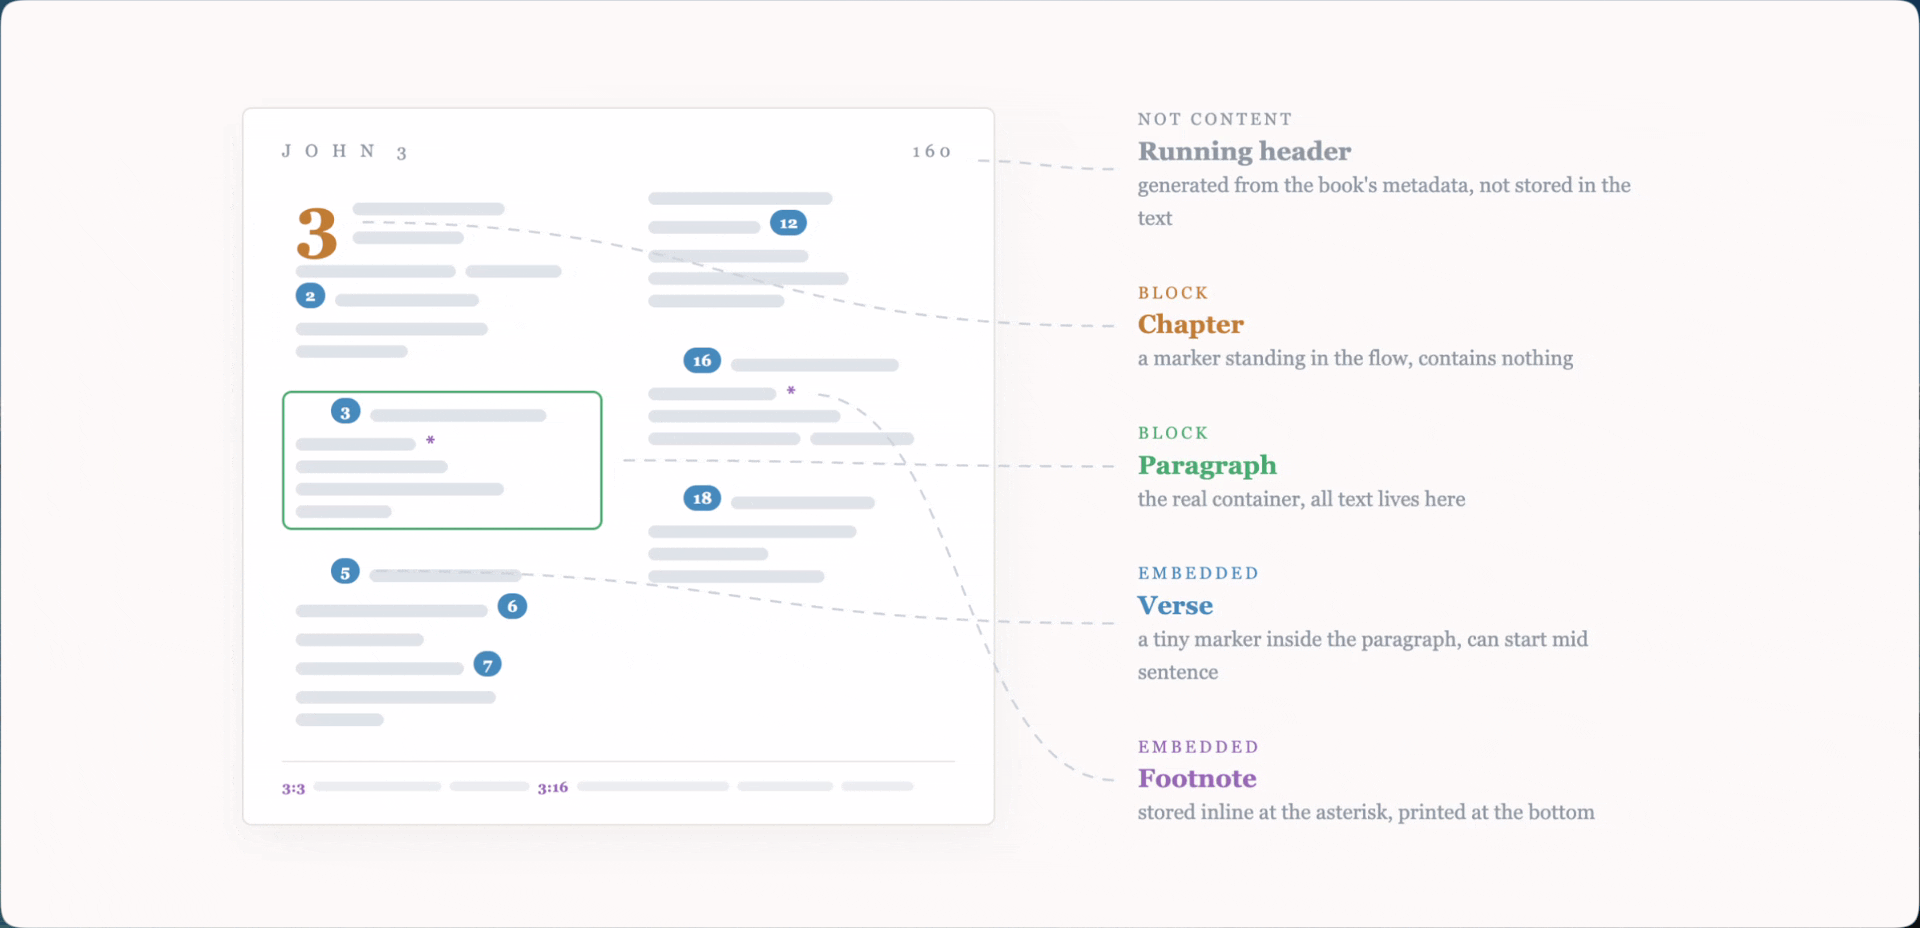
وهنا تفصيل بسيط في هذا القسم من معيار scripture book يجب فهمه. وهو أن هذا القسم يتكون من نوعين للبيانات
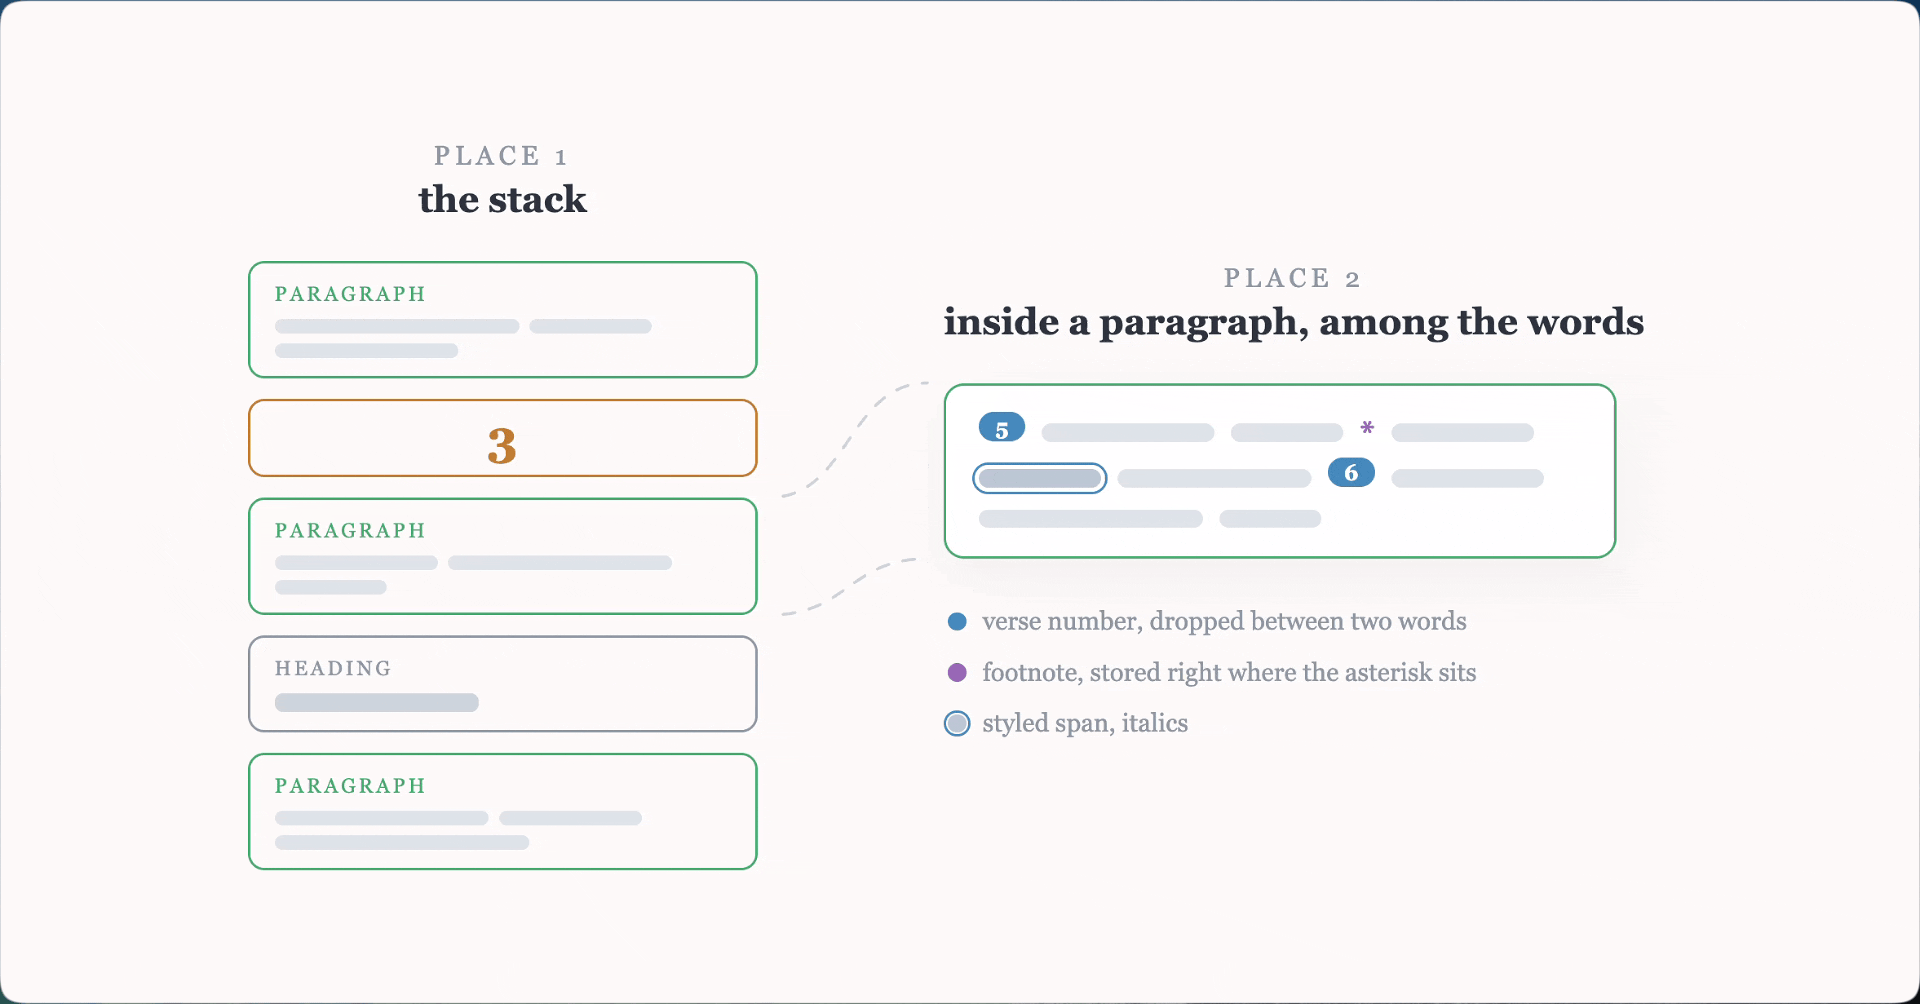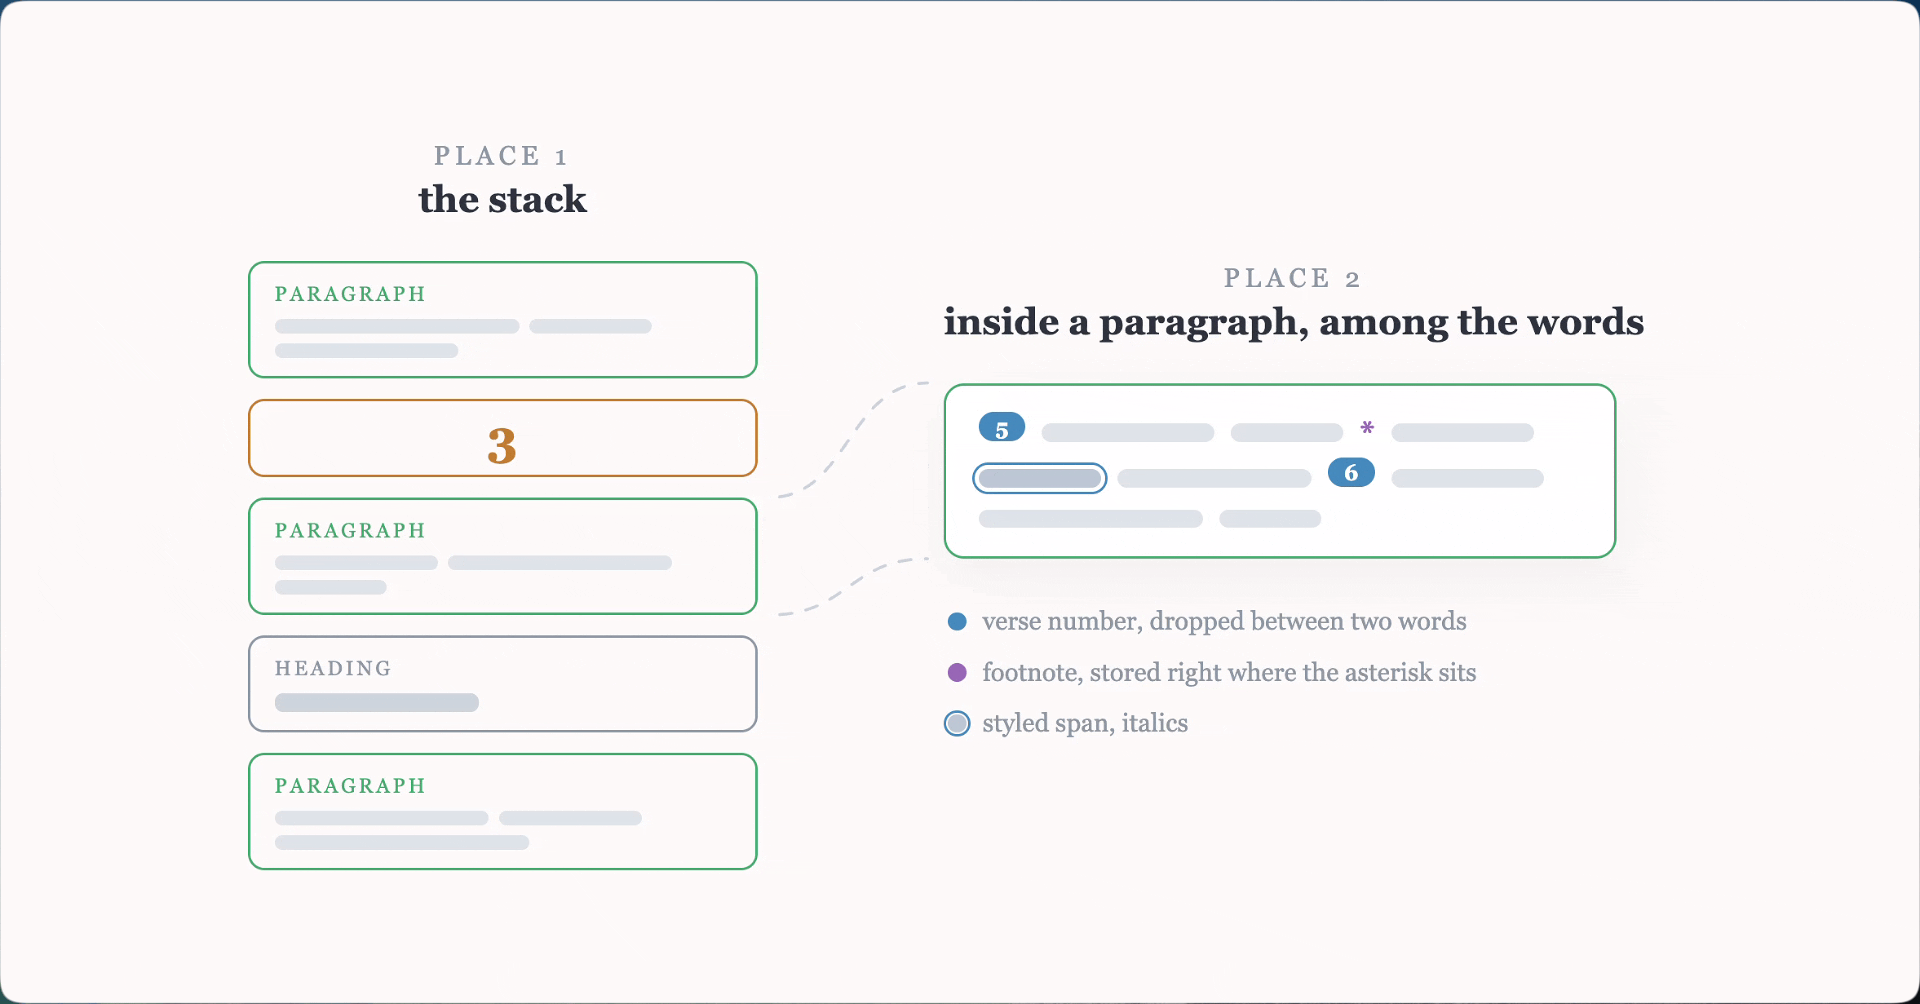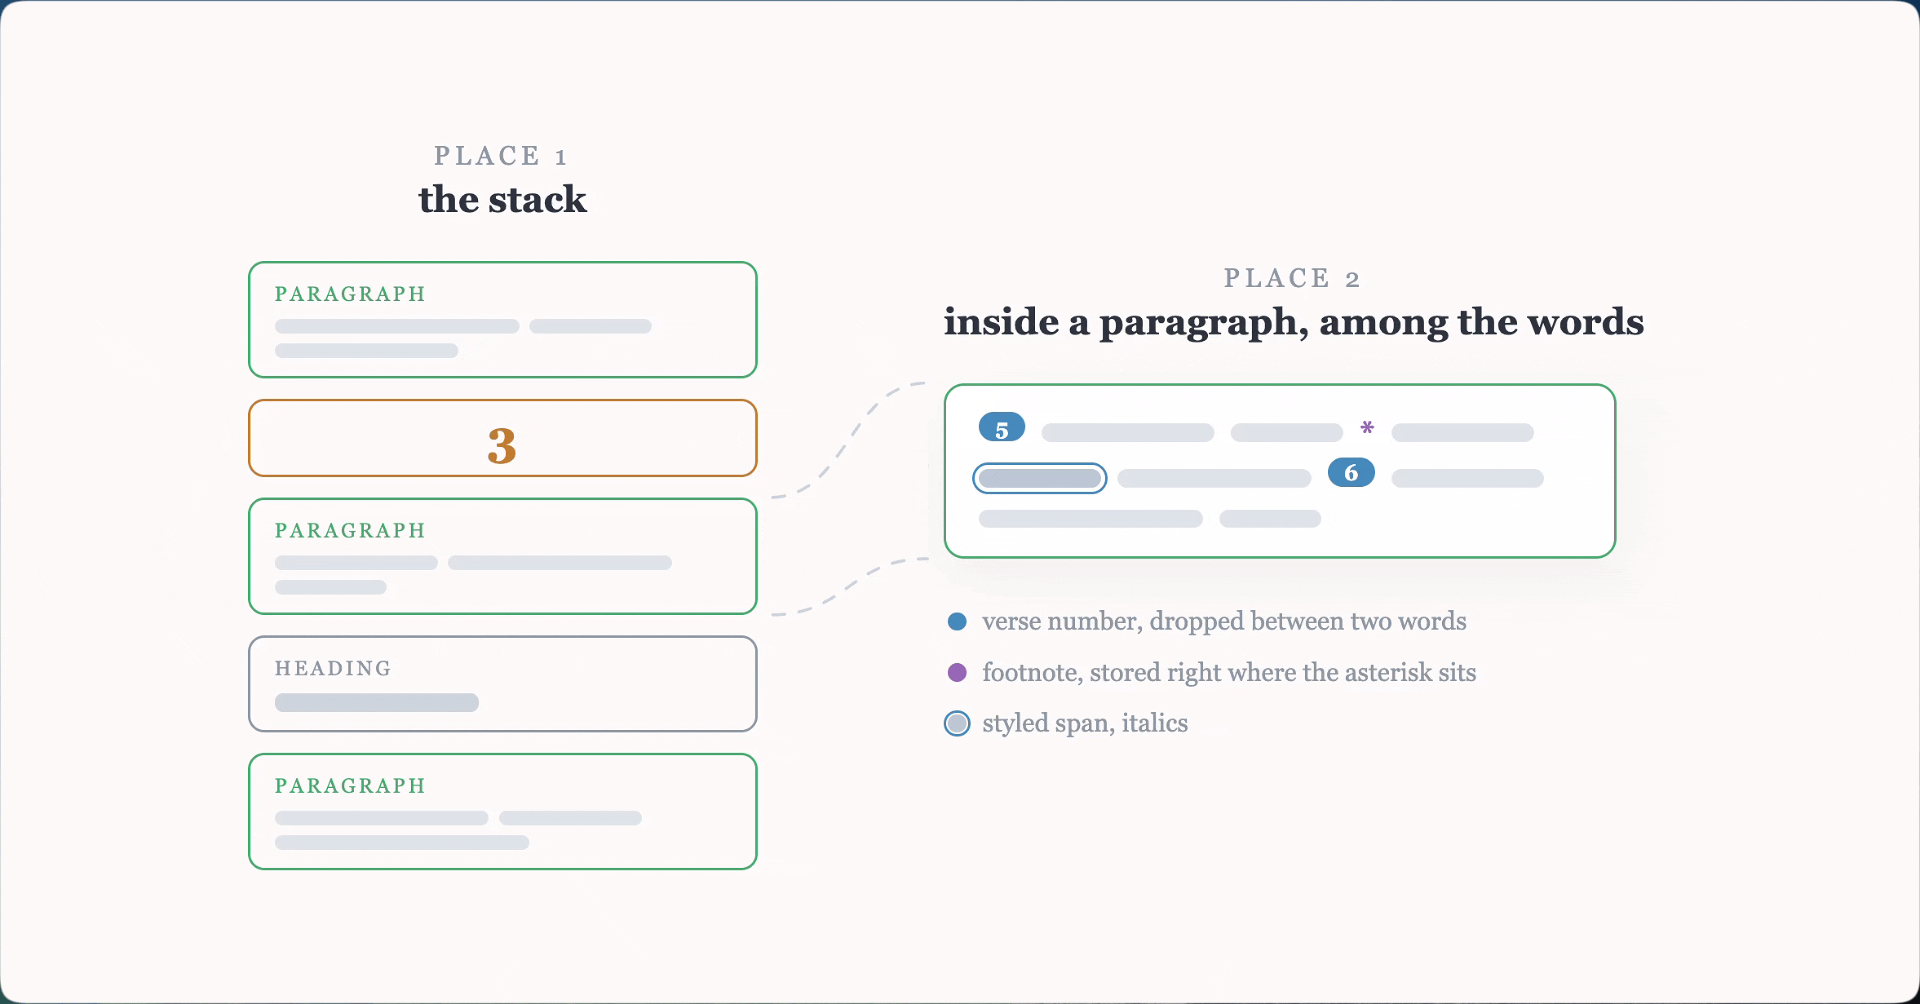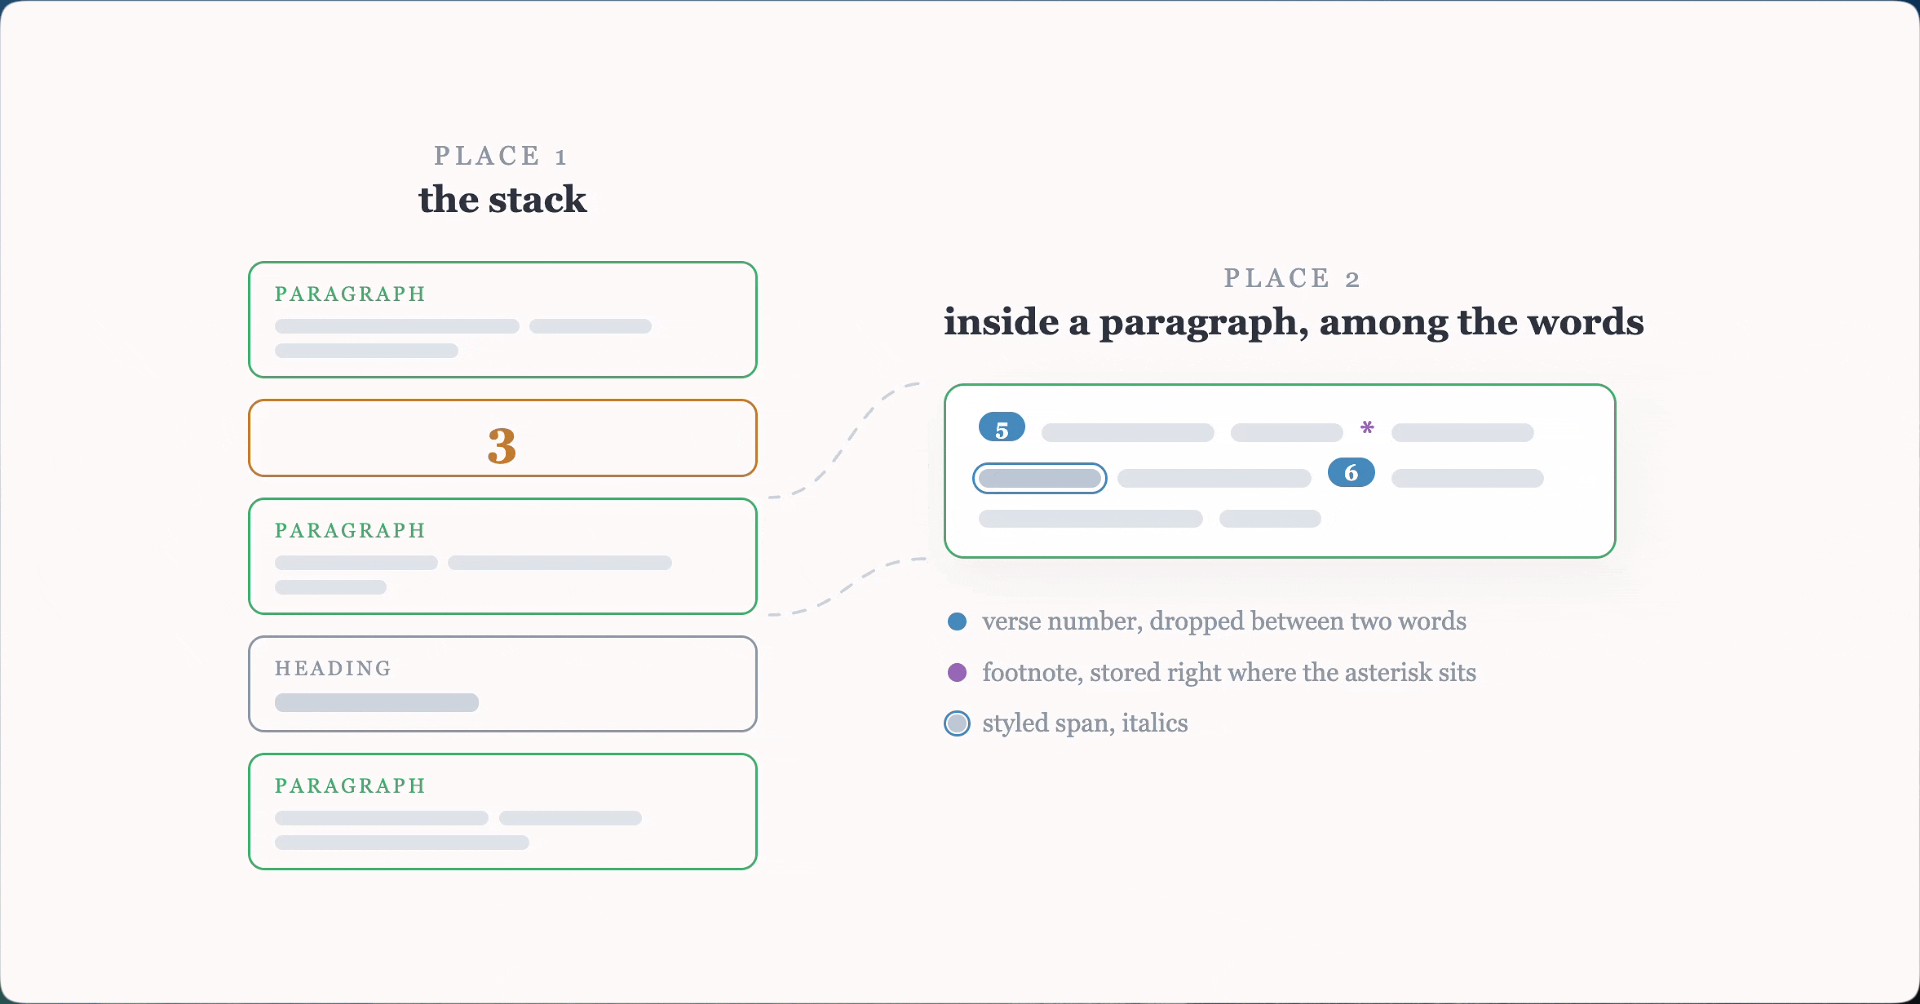
- الblocks (الأساس)
- الembeds ( بداخل الblocks)
فمثلا، إحدى الblocks قد تكون ال paragraph وتتضمن النص. ولكن مثلا معلومة أين تبدأ ال verse وأين تنتهي في هذا النص فتوجد داخل الجزء الثاني من هذا القسم وهو الembeds وهنا رسمة تشرح هذا المفهوم
ولكن لماذا هذه المعلومة مهمة ؟
طريقة تصميم content model الرائعة
قبل أن أبدأ في فهم ال content model ظننت في البداية أن التقسيم الطبيعي والمنطقي لقاعدة البيانات أو للمعيار هو هذا
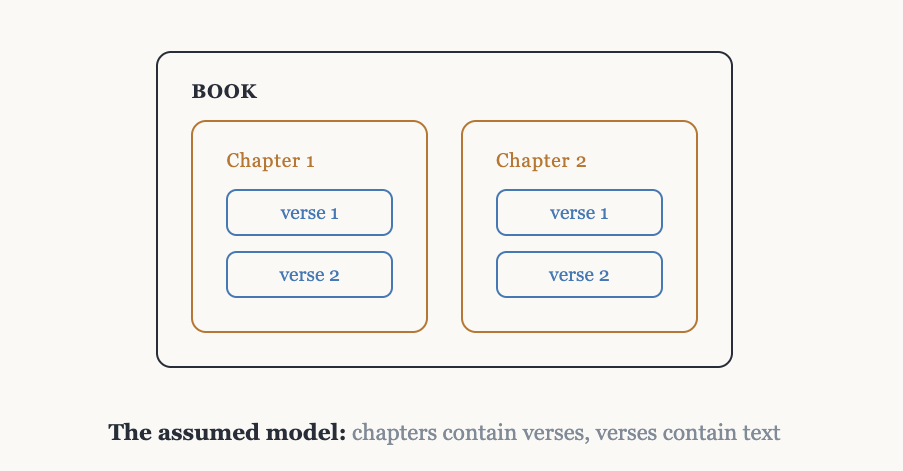
بسيط جدا، كل book فيه chapters وكل chapter يتكون من verses، كل resources منفصل وهذا هو ما اعتدنا عليه في بناء CRUD systems
ولكن واقع البيانات في USFM مختلف تماما. كما ذكرنا يوجد قائمة من ال blocks وهي ال paragraphs وهذه تتضمن النصوص. ولكن كيف يمكن معرفة ماهي الverse في النصوص ؟
الحقيقة أن معلومة ال verse ليست عبارة عن نص. بل هي boundaries. يعني الverse تبدأ من الحرف X إلى الحرف Y. وهذه المعلومة تكون موجودة في الجزء الثاني من القسم الأخير في scripture book مثل ما ذكرنا سابقا. وهذا سهل عملية عرض البيانات فهي فعليا flat ويمكن تقسيمها بـ boundaries وليس تقسيما هيكليا لها كما اعتدنا.
فكرة ال milestones markup
فهمنا فكرة ال boundaries/milestone، ولكن يجب أن نفصل قليلا في كيف وصلوا لهذا القرار
لذلك سأشرح فكرتهم المذكورة هنا في وثائق المعيار
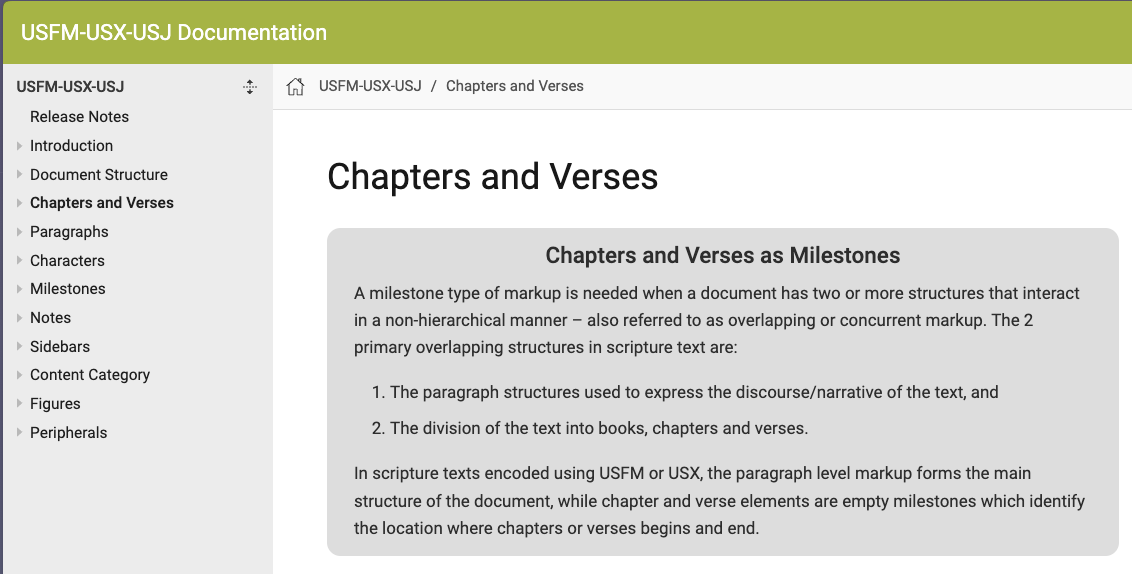
المذكور هنا هو : لماذا بني المعيار على مفهوم الmilestones ؟ والجواب حسب الوثائق أن هذا النوع من الترميز مطلوب عندما توجد في النص بنيتان متداخلتان بشكل غير هرمي ( overlapping structures ) . وهذا هو التحدي الأول وسنفصله بعد قليل. وهناك تحد ثاني منفصل لا تحله الmilestones نفسها بل تحله علامات الترقيم البديلة، وهو اختلاف عد الverses بين التقاليد.
قبل أن نكمل، يجب أن نعرف العلامات التي يستخدمها المعيار فيما يتعلق بال chapters وال verses. الفكرة أن ال chapter أو ال verse قد يحمل ثلاث علامات في الملف الواحد :
| العلامة | الاسم | المعنى |
|---|
| c | Chapter | رقم الشابتر المعتمد في هذا الملف |
| v | Verse | رقم الفيرس المعتمد في هذا الملف |
| ca | Chapter alternate | رقم نفس الشابتر حسب تقليد ترقيم آخر |
| va | Verse alternate | رقم نفس الفيرس حسب تقليد ترقيم آخر |
| cp | Chapter published | الرقم الذي يُطبع فعليا على الصفحة إذا اختلف عن المعتمد |
| vp | Verse published | الرقم الذي يُطبع فعليا على الصفحة إذا اختلف عن المعتمد |
فمثلا v = 2 and \va = 3* تعني: هذه الآية رقم ٢ حسب ترقيم هذا الملف، ويسميها التقليد الآخر الآية رقم ٣.
والآن نعود لتفصيل التحديين.
- التحدي الأول ( وهو سبب اعتماد الmilestones ) : يمكن للverse أن تكون بداخل أكثر من paragraph
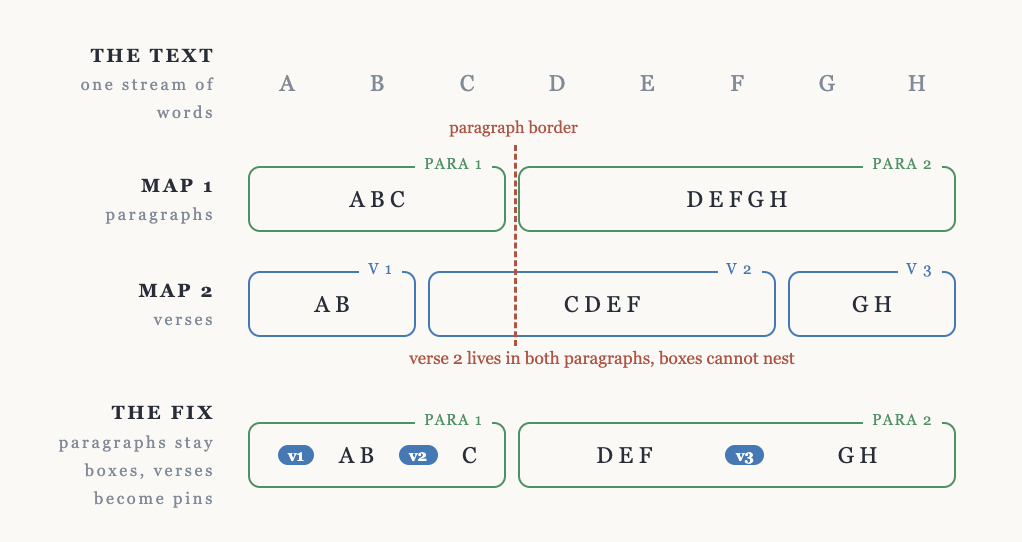
- التحدي الثاني ( وتحله علامات الترقيم البديلة ca / va / cp / vp ) : اختلاف عد الverses بين نسخ الانجيل ( التقاليد ) وذلك أن فكرة عد الverses مستحدثة
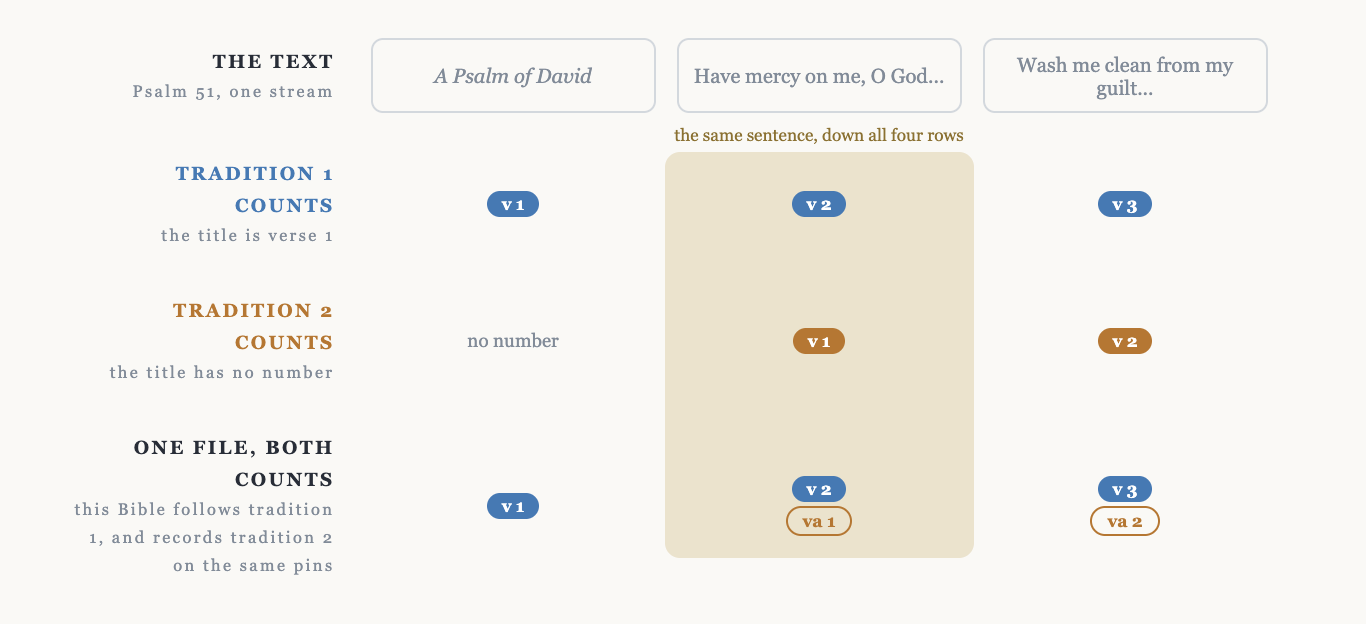
مثلا هنا التقليد العبري يعتبر العنوان verse ( وقد يعده verse رقم ١ و ٢ )، بينما الترقيم المعتمد في الترجمة الانجليزية لا يعتبره كذلك فتبدأ عنده ال verse رقم ١ بعد العنوان. فهنا اختلف عد الverses بين التقليدين
النوع الثاني : Peripheral
مفهوم Peripheral
ذكرنا سابقا أنه في ال content model يوجد نوعان من الملفات، وجميع الشرح السابق كان عن النوع الأول scripture book. والآن سنشرح النوع الثاني وهو Peripheral.
الانجيل يتكون من بيانات كثيرة، وليست كلها النصوص نفسها. بل هناك معلومات مساعدة كالمعجم، فهرس المحتوى وما إلى ذلك. وظيفة Peripheral هي وصف هذه البيانات.
من الجدير بالذكر أن ملف ال Peripheral يتشارك مع ملف scripture book في أكثر من جزء. فكما ذكرنا سابقا أن scripture book يتكون من ٧ أجزاء، فالجزء الأول وهو Identification موجود أيضا في ملف Peripheral. بل حتى أقسام Headers و Titles و Introduction يمكن أن تظهر . ومحتوى ال Peripheral نفسه يتبع نفس بنية الblocks والembeds التي شرحناها.
تفصيل peripheral
| القسم | الوصف |
|---|
| Identification | بطاقة تعريف الملف |
| periph division 1 | عدد الأقسام مفتوح، ويمكن إضافة أقسام مخصصة خارج المعيار |
| periph division 2 | عدد الأقسام مفتوح، ويمكن إضافة أقسام مخصصة خارج المعيار |
| periph division n | عدد الأقسام مفتوح، ويمكن إضافة أقسام مخصصة خارج المعيار |
شرح قسم Identification ( المشترك بين النوعين )
وبما أن Identification هو القسم المشترك بين النوعين، وجب شرحه هنا لأنه مثير للاهتمام. جزء أساسي من المعيار هو ال book، وقائمة الرموز تضم ١١٦ رمزا يضمن أيضا الكتب الخاصة بتقاليد معينة كالإثيوبية والسريانية، ولكل كتاب رمز مميز مكون من ٣ حروف، ولا يمكن بأي حال من الأحوال حتى مع اختلاف التقاليد والمسميات أن تتغير هذه الرموز. وهنا جدول لهذه الرموز
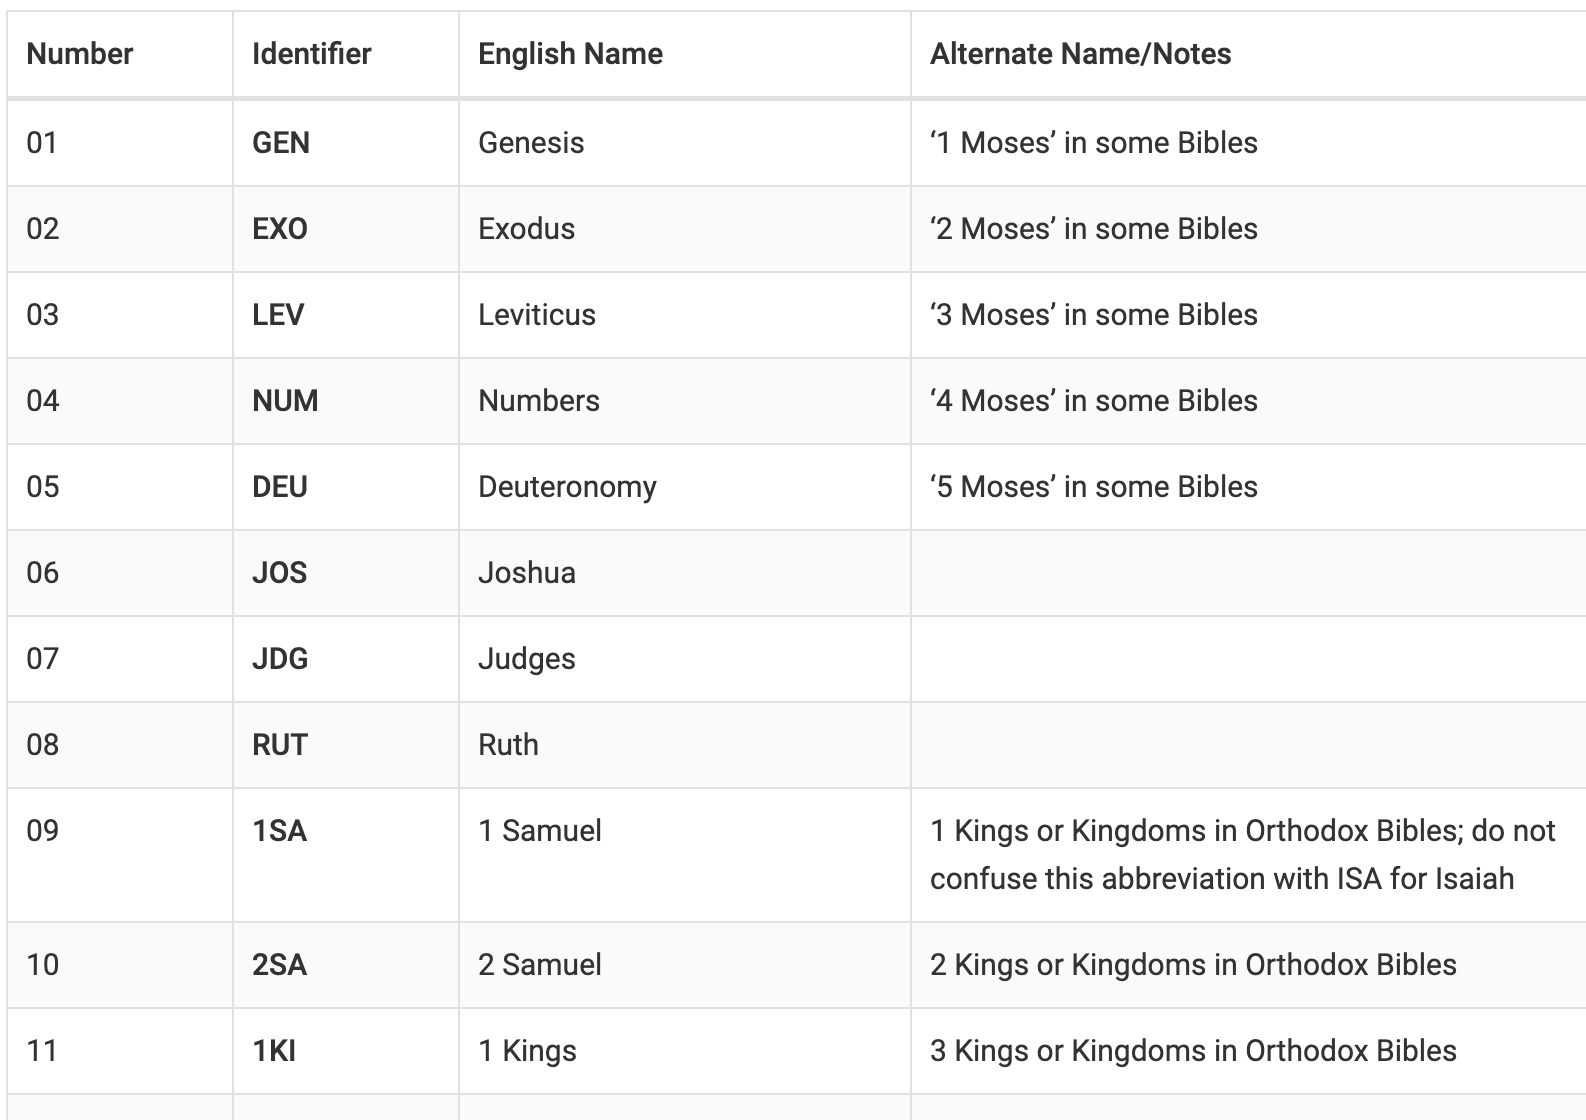
الجدير بالذكر أن بعض التقاليد تختلف في تسميات ال books. ولكن مع ذلك أكدت اللجنة أن الرموز ثابتة ويمكن لكل تقليد أن يكتب الاسم حسب رأيه فذلك لا يؤثر على المعيار.
كما أن هذه القائمة قد شملت الكتب من جميع الطوائف المسيحية حول العالم، حتى يشمل المعيار جميع نسخ الانجيل بكل تقاليدها.
كيف نقرأ ملفات USX ؟
شرحنا المفاهيم النظرية ( الblocks، الembeds، الmilestones، اختلاف الترقيم ) والآن سنربط النقاط ببعضها ونتعلم قراءة ملفات USX الفعلية
المعيار كله ١٦ علامة ( tag ) فقط
كما تعرف فإن XML يتكون من علامات، وقد عرف معيار USX ١٦ علامة مخصصة فقط، وهذه العلامات كانت كافية لكتابة الانجيل بـ ١٧٧٣ لغة !
وهي كالتالي : usx, book, chapter, verse, para, table, row, cell, char, ms, note, sidebar, periph, figure, optbreak, ref
أقسام ملف scripture book بصيغة USX
كل ملف يبدأ بعنصرين : usx ويحمل رقم إصدار المعيار، ثم book وهو قسم ال Identification الذي ذكرناه في أقسام ال scripture book السبعة :
<usx version="3.0">
<book code="JHN" style="id">World English Bible (WEB)</book>
code هو رمز الكتاب الثابت المكون من ٣ أحرف ( JHN ) وهذا الرمز لا يترجم أبدا. ملف انجيل JHON بالعربي أو الكوري أو الانجليزي كلها تبدأ بنفس الرمز JHN. هذه القاعدة الصغيرة هي التي سمحت لآلاف النصوص في DBL بأن تتعامل كنظام واحد رغم اختلاف اللغات.
الblocks وعنصرها para
<para style="s">The Sermon on the Mount</para>
<para style="p"> ... paragraph text ... </para>
<para style="q1"> ... poetry line, level 1 ... </para>
<para style="q2"> ... poetry line, level 2 ... </para>
و style هو ما يحدد نوع النص، مثلا “s” تعني عنوان قسم ( section heading )، و “p” تعني فقرة نص عادية، و “q1” تعني سطرا شعريا.
الmilestones وعنصراها chapter و verse
ال milestone له تعبير واضح في XML
<chapter number="3" style="c" sid="JHN 3"/>
<verse number="16" style="v" sid="JHN 3:16"/>
الembeds وعنصرها char و note
الembeds هي العناصر التي تعيش داخل نص ال block. وكلها تقريبا عنصر واحد اسمه char :
Then the <char style="nd">Lord</char> God ...
مثال كامل يجمع كل شيء
هذا ملف مبسط ومختصر لإنجيل John من ترجمة WEB المجانية ( نفس الترجمة التي استخدمناها في الأمثلة السابقة )، وفيه كل المفاهيم التي غطيناها في هذا المنشور مع تعليقات توضح كل جزء :
<usx version="3.1">

  <!-- 1. Identification: the file passport -->
  <book code="JHN" style="id">World English Bible (WEB)</book>

  <!-- 2. Headers + Titles divisions -->
  <para style="h">John</para>
  <para style="mt1">The Good News According to John</para>

  <!-- 3. ChapterContent begins: a chapter pin (empty, self-closing) -->
  <chapter number="3" style="c" sid="JHN 3"/>

  <!-- a heading block, then a paragraph block (the stack) -->
  <para style="s1"> ... section heading ... </para>
  <para style="p">

    <!-- verse start pin -->
    <verse number="16" style="v" sid="JHN 3:16"/>

    For God so loved the world, that he gave his one and only Son,
    that whoever believes in him should not perish, but have
    <char style="w" strong="G2222">eternal life</char>.

    <!-- an embed container (footnote) inside the block -->
    <note caller="+" style="f">
      <char style="fr">3:16 </char>
      <char style="ft"> ... note text ... </char>
    </note>

    <!-- verse end pin -->
    <verse eid="JHN 3:16"/>
  </para>

  <!-- chapter end pin -->
  <chapter eid="JHN 3"/>
</usx>
اقرأ الملف من فوق لتحت وستجد كل مفاهيم المنشور أمامك :
- مفهوم Book : رمز ثابت لا يترجم
- مفهوم para : كل block بداخله النصوص
- مفهوم verse & chapter : وهي milestones لها علامة بداية
sid وعلامة نهاية eid
الخلاصة
ربما كشفنا ٣٠٪ من المفاهيم في معيار USX، وهو معيار ضخم ويتضمن الكثير من المفاهيم التي تعكس قرارات اتخذت خلال أكثر من ٢٠ سنة ( وجذور الفكرة تعود للثمانينات ). أتمنى أن أكون وفقت في شرحها وتفصيلها.
والآن، السؤال الذي أطرحه عليكم : كيف يمكننا التعلم من هذا المعيار في بناء معيار قرآني موحد ؟
رأيكم يهمني جدا !
